
Se sei un architetto o un CIO, probabilmente ti sono state date due indicazioni che si contraddicono.
Il consiglio di amministrazione dice: “Vogliamo l’AI entro quest’anno”. Il playbook dice: “Prima pensate ai dati. Migrate. Centralizzate. Applicate la governance. Poi passate all’AI”.
La reazione istintiva è iniziare a spostare i dati in una piattaforma centralizzata. Ma qui nasce un problema. Ogni volta che si spostano i dati, aumentano costi e rischi. Se i C-level non ne sono consapevoli, dovrebbero preoccuparsi.
Per anni, spostare i dati è stato il prezzo da pagare per fare qualsiasi tipo di analisi. Per interrogare i dati bisognava passare dal compute proprietario del sistema che li conteneva. I dati in Oracle richiedevano Oracle. I dati in Teradata richiedevano Teradata. Analizzare dati di sistemi diversi significava prima spostarli fisicamente in un unico punto: così la centralizzazione è diventata la precondizione per tutto quello che veniva dopo, AI compresa.
Questa sequenza aveva senso 10 o 20 anni fa, ma oggi non è più un requisito tecnico.
Abbiamo scritto “Gioca d’anticipo” per spiegare come i cambiamenti architetturali degli ultimi anni rendano possibile avviare l’AI sui dati che hai oggi, mentre la modernizzazione prosegue sul suo percorso.
I formati aperti hanno cambiato le regole economiche
I formati di tabella aperti, in particolare Apache Iceberg™, hanno spezzato la dipendenza tra i dati e il sistema che li archivia. Qualsiasi engine di compute compatibile può leggere i dati in formato Iceberg, disaccoppiando storage e compute.
Iceberg ha davvero aperto l’interoperabilità tra tecnologie. È possibile pubblicare data product in Salesforce, SAP e Workday e utilizzarli con qualsiasi tecnologia già in essere, senza copie né pipeline complesse da costruire.
Un’azienda manifatturiera con dati operativi distribuiti tra un ERP e numerosi altri sistemi può ora interrogarli come un unico data asset. Lo stesso vale per un retailer con dati dei clienti in un CRM, dati delle transazioni in un sistema POS e dati di inventario in una piattaforma di supply chain. I dati restano dove sono. Il workload AI viene eseguito sui dati dove si trovano già.
Questa è la strategia per bruciare le tappe nella pratica: l’AI può partire dai dati che hai oggi, mentre la modernizzazione prosegue sul suo percorso. La timeline dell’AI e quella della migrazione possono procedere in modo indipendente, senza abbandonare gli investimenti esistenti.
Poiché questi formati sono aperti, i dati restano di tua proprietà. Le Iceberg Tables sono archiviate come file Parquet nel tuo storage in cloud e possono essere lette da altri motori compatibili con Iceberg. Letture e scritture funzionano in entrambe le direzioni, così i dati sono utili senza essere duplicati.
La governance che viaggia con i dati
Il vecchio modello legava la governance al luogo in cui si trovavano i dati. I dati dovevano essere centralizzati prima di poter essere governati in modo coerente, e ogni requisito di governance diventava un motivo in più per completare prima la migrazione.
Anche questa dipendenza è venuta meno. Snowflake Horizon Catalog applica un unico insieme di policy a dati, data product, app, modelli, agenti AI e altri asset, dentro e fuori dalla piattaforma. I dati a cui si accede tramite Snowflake mantengono la stessa governance, indipendentemente da dove risiedono: controllo degli accessi granulare basato sui ruoli, policy di masking e di row access, lineage a livello di colonna e access history.
Horizon Catalog ora estende le policy Snowflake di row access e masking a engine esterni come Apache Spark, Trino e PyIceberg, in public preview. Horizon applica le policy quando pianifica ogni scansione, così gli engine ricevono solo i dati che un utente è autorizzato a vedere e ogni operazione è registrata nell’access history di Snowflake.
Poiché Horizon applica queste policy in modo centralizzato, valgono automaticamente per ogni chiamante, che sia un analista in carne e ossa, uno strumento di BI o un agente AI.
Quando l’AI richiede controlli più rigorosi, la funzionalità di Snowflake per l’identità degli agenti AI consente agli amministratori di definire a quali dati può accedere un agente AI, indipendentemente dall’utente che lo ha invocato. Le policy di mascheramento e le policy di accesso righe possono essere applicate direttamente alle sessioni degli agenti AI. Ogni azione viene attribuita sia all’utente sia all’agente AI che l’ha eseguita, offrendo ai team di compliance un audit trail completo di ciò su cui è intervenuta l’AI e in quale momento.
Per le aziende europee non è l’ennesimo dettaglio di compliance. È la base dell’architettura. Con il GDPR, i requisiti di residenza dei dati e l’AI Act dell’UE, decidere dove si trovano i dati, chi può accedervi e come vengono sottoposte ad audit le decisioni dell’AI diventa una questione di scelte progettuali e di responsabilità.
Un’architettura che governa i dati in place, con policy applicate in modo coerente e lineage tracciabile end to end, può aiutare le organizzazioni a soddisfare questi requisiti senza imporre il consolidamento in un’unica region o in un unico sistema.
L’architettura
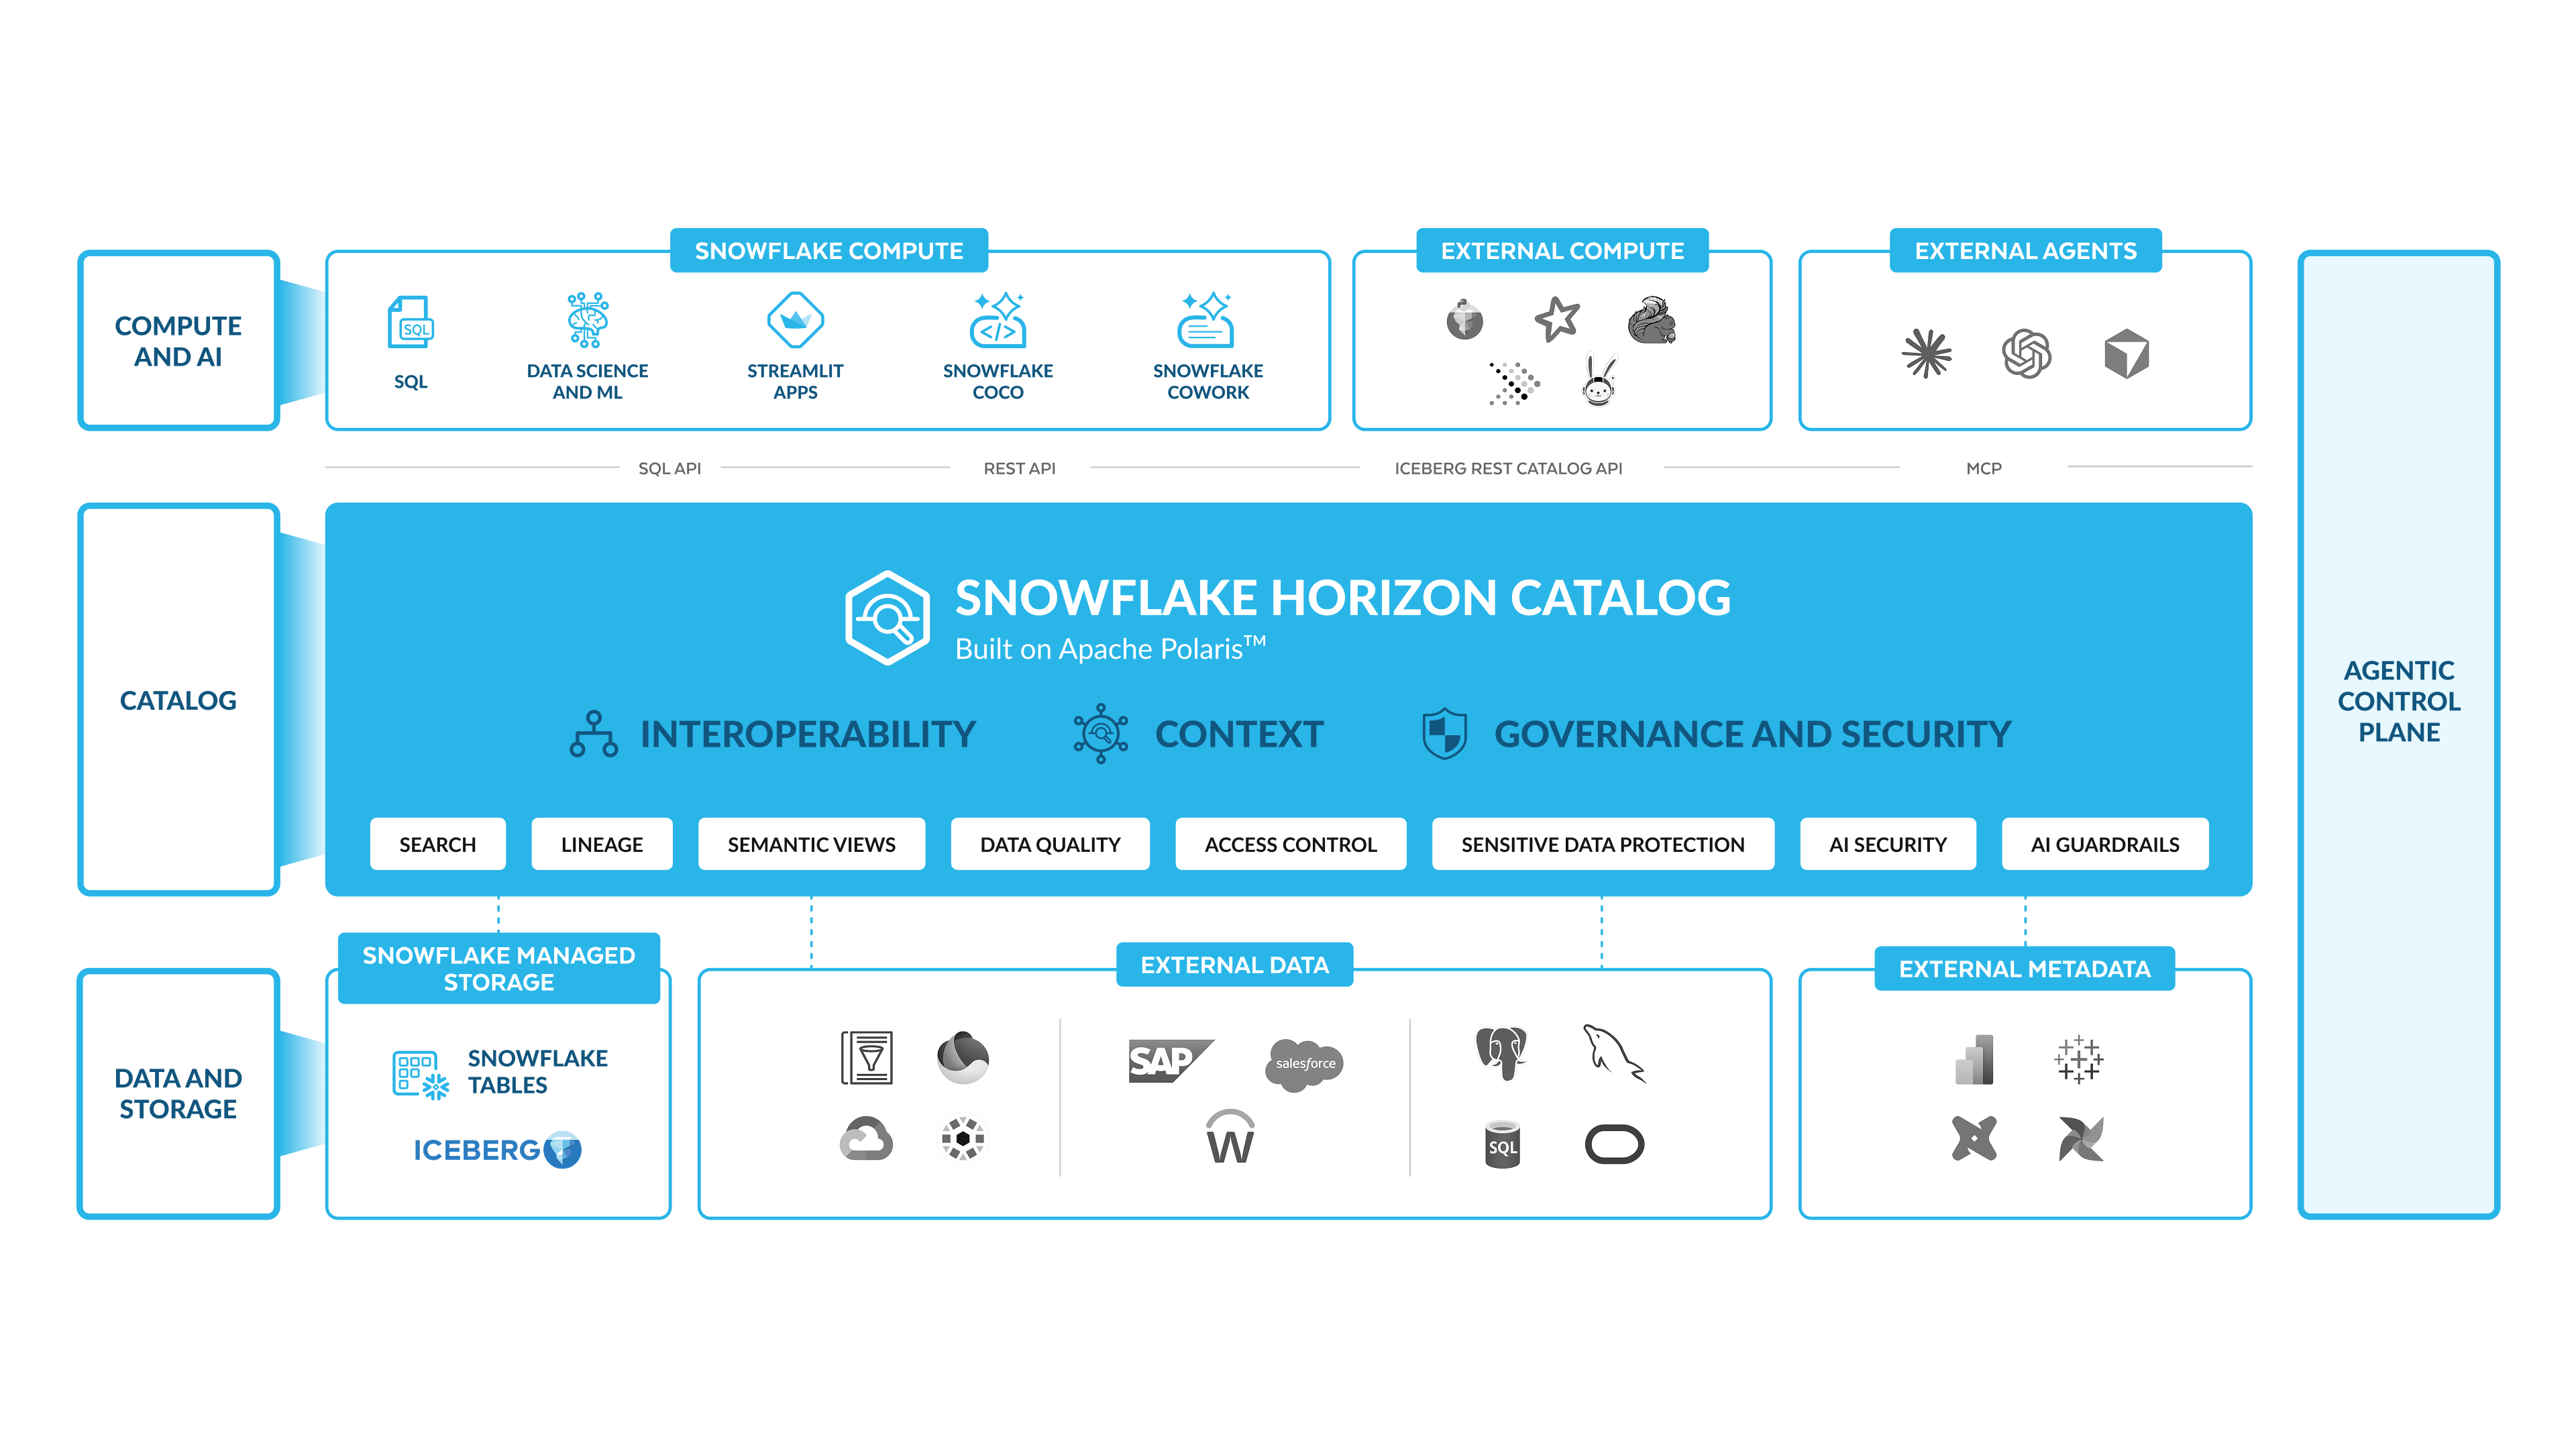
Snowflake consente di lavorare con i dati dove si trovano già. Un unico layer governato per capacità di calcolo, catalogo e storage: l’AI lavora sui dati così come sono oggi, non dopo un cambio di piattaforma. Ecco come si bruciano le tappe, nella pratica: la roadmap dell’AI e quella della migrazione procedono separate.
Compute e AI: esegui i workload dove è più opportuno, su Snowflake o su motori esterni.
Catalogo: un unico layer di governance per dati in formati aperti e dati gestiti da Snowflake.
Dati e storage: interroga i dati senza spostarli e senza doverli prima copiare.
Agentic Control Plane: gli agenti AI operano entro lo stesso perimetro governato di tutti gli altri elementi.
Collegare un patrimonio tecnologico globale
NTT DATA, leader globale nei servizi di AI, digital business e tecnologia, gestisce uno dei patrimoni tecnologici più grandi e complessi al mondo e serve clienti in tutti i principali settori. Con dati distribuiti tra sistemi accumulati nel corso di decenni, la sfida non era la mancanza di investimenti, ma riuscire a metterli a sistema senza avviare un altro programma pluriennale di consolidamento.
“Per NTT DATA, la partnership con Snowflake non si limita a portare più dati su un’altra piattaforma. L’obiettivo è facilitare l’accesso, la governance e l’utilizzo dei dati in un panorama tecnologico globale complesso. In questo modo creiamo una data foundation agile e ad alte prestazioni per AI, innovazione e trasformazione, mantenendo la flessibilità necessaria per far evolvere il nostro panorama tecnologico senza introdurre ulteriore complessità.”
Nick Cheesman
CIO, NTT DATA, Inc.
Evitare il far west
La velocità senza architettura crea problemi propri, un po’ come una città costruita senza piano urbanistico.
Nella corsa a consegnare qualcosa, le organizzazioni rischiano di creare un far west di strumenti AI diversi. Il risultato sono soluzioni frammentate e output incoerenti che erodono la fiducia nei risultati dell’AI. La risposta è costruire i workload AI all’interno di un framework di governance esistente dal primo giorno, anche se quel framework è ancora in evoluzione. I nuovi use case diventano banchi di prova che offrono insight per far evolvere la strategia e l’architettura dei dati.
La modernizzazione resta importante e l’AI può contribuire ad accelerarla. Le migrazioni procedono più rapidamente quando l’AI si fa carico di buona parte del lavoro più pesante. L’AI può essere sia il risultato della modernizzazione sia uno strumento per farla avanzare.
Da dove iniziare
Il patrimonio dati non sarà mai completo: smetti di chiederti quando i dati saranno pronti e chiediti quanto costa un altro trimestre di attesa. Il punto di partenza pratico è un progetto pilota circoscritto. Dai priorità a un use case capace di dimostrare valore rapidamente e di creare la credibilità organizzativa per andare oltre.
“Gioca d’anticipo” approfondisce l’architettura che consente di bruciare le tappe, compreso il modo in cui i workload AI e la modernizzazione condividono un’unica base aperta e governata, così il lavoro fatto oggi si collega a quello che sarà completato domani. Leggi il nuovo ebook.
