11. Nov. 2026/Lesezeit: 6 MinutenKI und ML
Die versteckten Kosten der Datenverschiebung (und wie Sie diese vermeiden)
Wenn Sie Architekt:in oder CIO sind, haben Sie wahrscheinlich zwei Anweisungen erhalten, die sich widersprechen.
Der Vorstand sagt: „Geben Sie uns dieses Jahr KI.“ Das Playbook sagt: „Bringen Sie zuerst die Daten in Ordnung. Migrieren Sie. Zentralisieren Sie. Sorgen Sie für Governance. Dann machen Sie KI.“
Die Standardreaktion besteht darin, Daten auf eine zentralisierte Plattform zu verschieben. Aber das schafft ein Problem. Jedes Mal, wenn Sie Daten verschieben, steigen Kosten und Risiken. Das sollte Führungskräften auf C-Level Kopfzerbrechen bereiten, wenn sie sich dessen nicht bewusst sind.
Jahrelang war das Verschieben von Daten der Preis dafür, überhaupt Analytics betreiben zu können. Um Daten abzufragen, mussten Sie die proprietäre Rechenressource des jeweiligen Systems nutzen, dem sie gehörten. Daten in Oracle erforderten Oracle. Daten in Teradata erforderten Teradata. Systemübergreifende Analysen bedeuteten, dass Daten zunächst physisch an einen Ort verschoben werden mussten, sodass Zentralisierung zur Voraussetzung für alles Folgende wurde, einschließlich KI.
Diese Reihenfolge war vor 10 bis 20 Jahren sinnvoll, ist aber keine technische Anforderung mehr.
„Das lineare Modell durchbrechen“ ist eine Ressource, die wir erstellt haben, um zu erklären, wie die Architekturverschiebungen der letzten Jahre es ermöglichen, KI mit den Daten zu starten, die Sie heute haben, während die Modernisierung auf ihrem eigenen Weg weitergeht.
Offene Formate haben die Wirtschaftlichkeit verändert
Offene Tabellenformate, insbesondere Apache Iceberg™, haben die Abhängigkeit zwischen Daten und dem System, das sie speichert, aufgehoben. Jede kompatible Compute-Engine kann Daten im Iceberg-Format lesen und so Speicher von Rechenressource entkoppeln.
Iceberg hat die Interoperabilität zwischen Technologien wirklich geöffnet. Sie können Datenprodukte in Salesforce, in SAP, in Workday veröffentlichen und sie von der Technologie aus nutzen, die Sie gerade verwenden, ohne Kopieren oder komplexen Pipeline-Aufbau.
Für ein Fertigungsunternehmen mit operativen Daten, die über ein ERP und zahlreiche andere Systeme verteilt sind, können diese Quellen nun als einheitliches Asset abgefragt werden. Für einen Händler mit Kundendaten in einem CRM, Transaktionen in einem Point-of-Sale-System und Beständen in einer Supply Chain-Plattform gilt dasselbe. Die Daten bleiben, wo sie sind. KI-Workloads werden dort ausgeführt, wo sich die Daten bereits befinden.
Das ist die Leapfrog-Strategie in der Praxis: KI kann mit den Daten beginnen, die Sie heute haben, während die Modernisierung auf ihrem eigenen Weg weitergeht. Ihre KI-Zeitachse und Ihre Migrationszeitachse können sich unabhängig voneinander bewegen, ohne bestehende Investitionen zurückzulassen.
Da die Formate offen sind, bleiben die Daten Ihre. Iceberg Tables können als Parquet-Dateien in Ihrem eigenen Cloud-Speicher liegen und von anderen Iceberg-kompatiblen Engines gelesen werden. Lese- und Schreibvorgänge funktionieren in beide Richtungen, sodass Daten nützlich sein können, ohne dupliziert zu werden.
Governance, die mit den Daten reist
Im alten Modell war Governance untrennbar mit dem physischen Speicherort verknüpft. Daten mussten zentralisiert werden, bevor sie konsistent verwaltet werden konnten, was jede Governance-Anforderung zu einem weiteren Grund machte, die Migration zuerst abzuschließen.
Auch diese Abhängigkeit ist gebrochen. Snowflake Horizon Catalog wendet einheitliche Richtlinien auf Daten, Datenprodukte, Apps, Modelle, Agenten und andere Assets innerhalb und außerhalb der Plattform an. Daten, auf die über Snowflake zugegriffen wird, unterliegen derselben Governance, wo immer sie sich befinden: feingranulare Role-Based Access Control (RBAC), Maskierungs- und Row Access Policies, Lineage auf Spaltenebene und Zugriffshistorie.
Horizon Catalog erweitert nun Snowflake-Row Access Policies und Maskierungsrichtlinien auf externe Engines wie Apache Spark, Trino und PyIceberg, in Public Preview. Horizon wendet die Richtlinien an, wenn es jeden Scan plant, sodass Engines nur die Daten erhalten, die ein:e Nutzer:in sehen darf, und jeder Vorgang in der Zugriffshistorie von Snowflake aufgezeichnet wird.
Da Horizon diese Richtlinien zentral durchsetzt, gelten sie automatisch für jeden Aufrufer, sei es ein:e menschliche:r Analyst:in, ein BI-Tool oder ein KI-Agent.
Wenn strengere Kontrollen für KI erforderlich sind, können Administrator:innen mit der Agentenidentitätsfunktion von Snowflake definieren, auf welche Daten ein Agent zugreifen kann, unabhängig von dem:der Nutzer:in, der:die ihn aufgerufen hat. Maskierungsrichtlinien und Zeilenzugriffsrichtlinien können direkt auf Agenten-Sitzungen angewendet werden. Aktionen werden sowohl dem:der Nutzer:in als auch dem Agenten zugeordnet, der sie ausgeführt hat, sodass Compliance-Teams einen Audit-Trail darüber erhalten, was die KI wann berührt hat.
Für europäische Unternehmen ist dies nicht nur ein weiteres Compliance-Detail. Es bildet das architektonische Fundament. DSGVO, Anforderungen an die Datenresidenz und der EU AI Act bedeuten, dass der Speicherort von Daten, wer darauf zugreifen kann und wie KI-Entscheidungen geprüft werden, Designentscheidungen und Verantwortlichkeiten sind.
Eine Architektur, die darauf ausgelegt ist, Daten an Ort und Stelle zu verwalten, wobei Richtlinien konsistent durchgesetzt werden und die Lineage durchgängig nachvollziehbar ist, kann Unternehmen dabei helfen, diese Anforderungen zu unterstützen, ohne eine Konsolidierung in einer einzigen Region oder einem einzigen System zu erzwingen.
Die Architektur
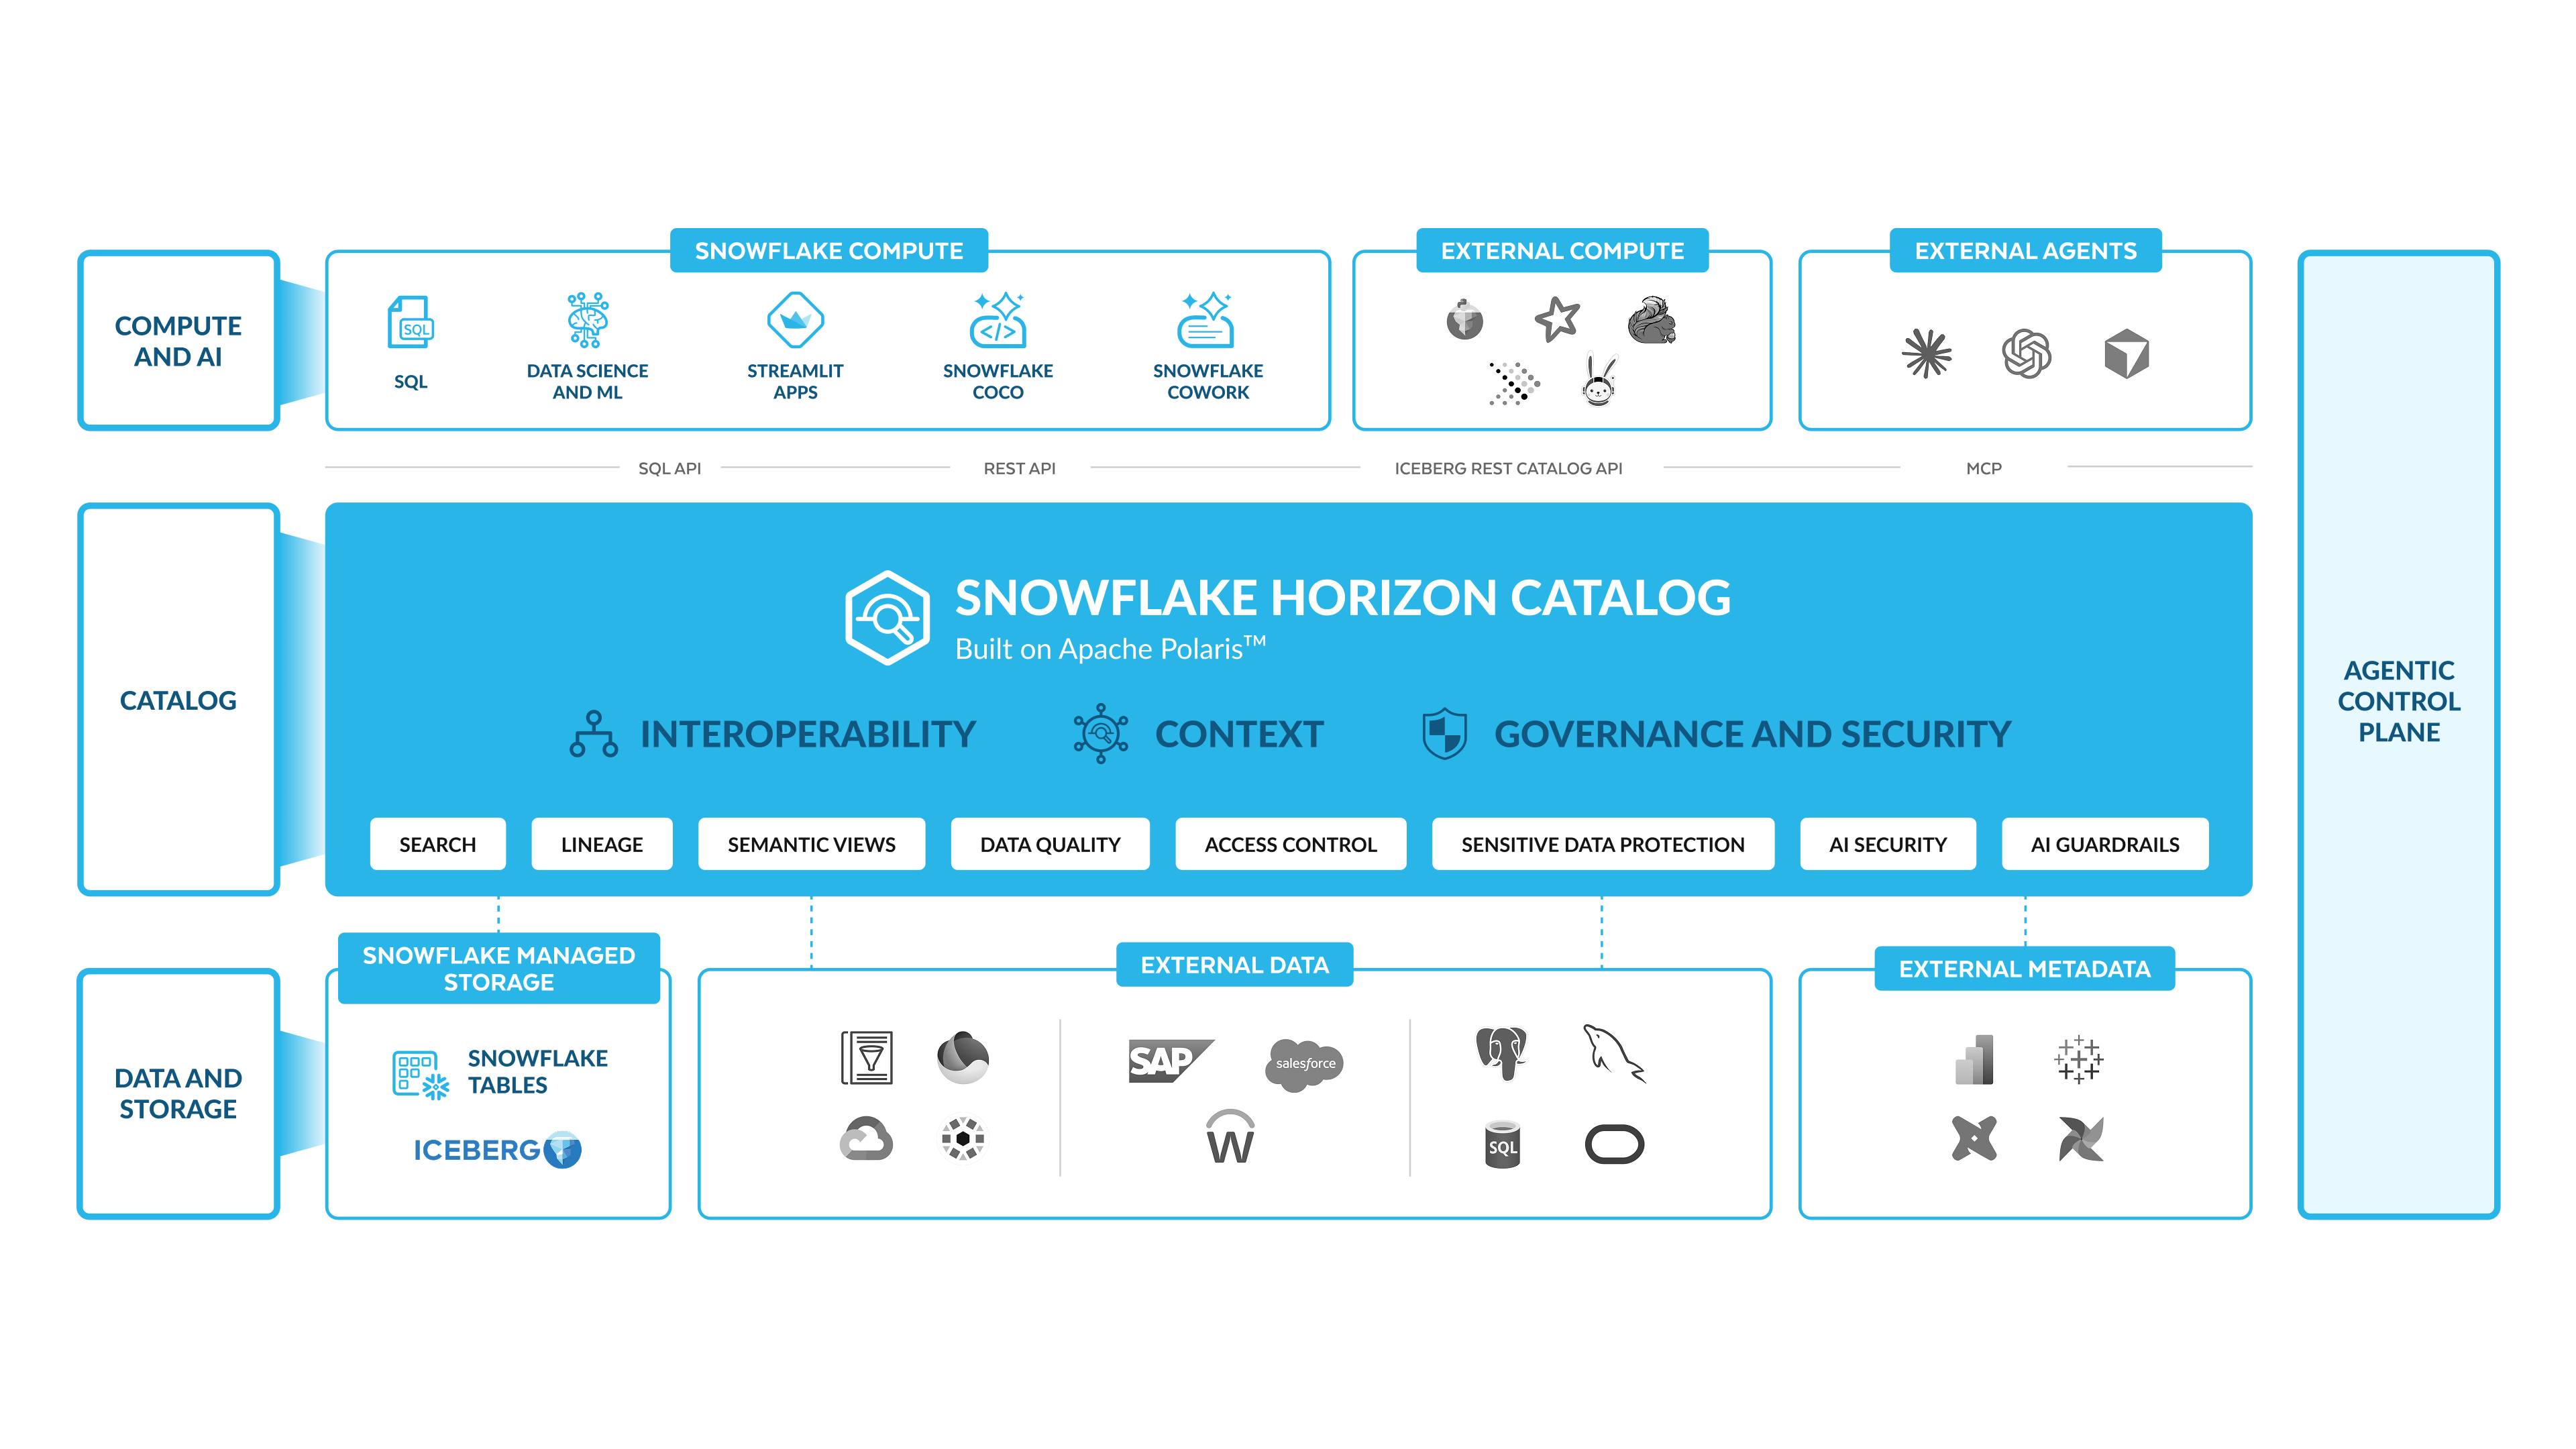
Mit Snowflake können Sie Ihre Daten genau dort nutzen, wo sie sich bereits befinden. Eine verwaltete Schicht, die Rechenressource, Katalog und Speicher umfasst, sodass KI auf Ihren Daten so ausgeführt wird, wie sie heute sind, und nicht erst nach einem Replatforming. Das ist das Leapfrog-Prinzip in der Praxis: Ihre KI-Zeitachse und Ihre Migrations-Zeitachse sind entkoppelt.
Rechenressourcen und KI: Workloads genau dort ausführen, wo es am sinnvollsten ist – auf Snowflake oder externen Engines.
Katalog: Eine zentrale Governance-Schicht für offene sowie von Snowflake verwaltete Daten.
Daten und Speicher: Daten direkt am Speicherort abfragen, ohne sie vorher kopieren zu müssen.
Agenten-Kontrollebene: Agenten arbeiten innerhalb derselben verwalteten Grenze wie alles andere.
Verbindung eines globalen Bestands
NTT DATA, ein weltweit führender Anbieter von KI, digitalem Geschäft und Technologie-Services, betreibt eine der größten und komplexesten IT-Infrastrukturen der Welt und bedient Kundenunternehmen in allen wichtigen Branchen. Da die Daten über Jahrzehnte hinweg auf historisch gewachsene Systeme verteilt waren, bestand die Herausforderung nicht in mangelnden Investitionen, sondern darin, diese Investitionen nutzbar zu machen, ohne ein weiteres mehrjähriges Konsolidierungsprogramm zu starten.
“For NTT DATA, the partnership with Snowflake goes beyond simply putting more data into another platform. It’s about making data easier to access, govern and consume across a complex global technology landscape. By doing so, we’re creating a high-performing, agile data foundation for AI, innovation and transformation, while maintaining the flexibility to evolve our technology landscape without introducing additional complexity.”
Nick Cheesman
CIO, NTT DATA, Inc.
Vermeiden Sie den Wilden Westen
Geschwindigkeit ohne Architektur schafft ihre eigenen Probleme, ähnlich wie eine Stadt, die ohne Stadtplan gebaut wurde.
In der Eile, etwas zu liefern, können Unternehmen einen Wilden Westen verschiedener KI-Tools schaffen. Das Ergebnis sind fragmentierte Lösungen und inkonsistente Ausgaben, die das Vertrauen in KI-Ergebnisse untergraben. Die Antwort besteht darin, KI-Workloads vom ersten Tag an innerhalb eines bestehenden Governance-Frameworks aufzubauen, auch wenn sich dieses Framework noch in der Entwicklung befindet. Neue Anwendungsfälle werden zu Testumgebungen, die Erkenntnisse für die Weiterentwicklung der Datenstrategie und -architektur liefern.
Modernisierung ist nach wie vor wichtig, und KI kann helfen, sie zu beschleunigen. Migrationen können schneller ablaufen, wenn KI einen Großteil der schweren Arbeit übernimmt. KI kann sowohl das Ergebnis der Modernisierung als auch ein Werkzeug zu ihrer Vorantreibung sein.
Wo Sie anfangen sollten
Der Bestand wird nicht fertiggestellt sein, also hören Sie auf zu fragen, wann die Daten bereit sein werden, und fragen Sie sich, was ein weiteres Quartal des Wartens kostet. Der praktische Ausgangspunkt ist ein fokussierter Pilot. Priorisieren Sie einen Anwendungsfall, der schnell einen Mehrwert aufzeigen und die organisatorische Glaubwürdigkeit schaffen kann, um weiterzugehen.
„Break the Sequence“ geht detaillierter auf die Architektur hinter der Leapfrog-Strategie ein, einschließlich der Frage, wie KI-Workloads und Modernisierung eine offene, verwaltete Grundlage teilen, sodass die heute geleistete Arbeit mit der später abgeschlossenen Arbeit verbunden wird. Laden Sie das E-Book herunter
