Si eres arquitecto o CIO, probablemente hayas recibido dos instrucciones contradictorias.
El consejo de administración dice: “Danos IA este año”. El manual dice: “Primero, pon los datos en orden. Migra. Centraliza. Aplica la gobernanza. Después, implementa la IA”.
La reacción habitual es empezar a trasladar los datos a una plataforma centralizada. Pero esto plantea un problema. Cada vez que mueves datos, aumentan el coste y el riesgo. Esto debería preocupar a los altos directivos si no son conscientes de ello.
Durante años, mover datos fue el precio que había que pagar para realizar cualquier tipo de analíticas. Para consultar los datos, había que recurrir al cómputo propietario del sistema al que pertenecían. Los datos de Oracle requerían Oracle. Los datos de Teradata requerían Teradata. Para realizar análisis entre distintos sistemas, primero había que mover físicamente los datos a un único lugar, por lo que la centralización se convirtió en una condición previa para todo lo demás, incluida la IA.
Esta secuencia tenía sentido hace entre 10 y 20 años, pero ya no es un requisito técnico.
“Break the Sequence” es un recurso que hemos creado para explicar cómo los cambios arquitectónicos de los últimos años permiten empezar a usar la IA con los datos que tienes hoy mientras la modernización sigue su propio curso.
Los formatos abiertos cambiaron la ecuación económica
Los formatos de tabla abiertos, en concreto Apache Iceberg™, eliminaron la dependencia entre los datos y el sistema que los almacena. Cualquier motor de cómputo compatible puede leer datos en formato Iceberg, lo que desacopla el almacenamiento del cómputo.
Iceberg ha impulsado realmente la interoperabilidad entre tecnologías. Puedes publicar productos de datos en Salesforce, SAP y Workday, y consumirlos desde la tecnología que estés utilizando en cada momento, sin copiar datos ni crear pipelines complejos.
En el caso de un fabricante cuyos datos operativos estén repartidos entre un ERP y muchos otros sistemas, ahora esas fuentes pueden consultarse como un activo unificado. Lo mismo se aplica a una empresa de retail con datos de clientes en un CRM, transacciones en un sistema de punto de venta e inventario en una plataforma de cadena de suministro. Los datos permanecen donde están. El workload de IA se ejecuta sobre los datos allí donde se encuentran.
Así funciona en la práctica la estrategia del salto tecnológico: la IA puede empezar a utilizar los datos que tienes hoy mientras la modernización sigue su propio curso. El calendario de la IA y el de la migración pueden avanzar de forma independiente, sin dejar atrás las inversiones existentes.
Como los formatos son abiertos, los datos siguen siendo tuyos. Las tablas de Iceberg pueden almacenarse como archivos Parquet en tu propio almacenamiento en la nube y ser leídas por otros motores compatibles con Iceberg. Las lecturas y escrituras funcionan en ambas direcciones, por lo que los datos pueden aprovecharse sin duplicarlos.
Una gobernanza que acompaña a los datos
El modelo anterior vinculaba la gobernanza a la ubicación. Los datos tenían que centralizarse antes de poder aplicarles una gobernanza coherente, por lo que cada requisito de gobernanza se convertía en otro motivo para completar primero la migración.
Esa dependencia también ha desaparecido. Snowflake Horizon Catalog aplica un único conjunto de políticas a los datos, productos de datos, aplicaciones, modelos, agentes y otros activos, tanto dentro como fuera de la plataforma. Los datos a los que se accede mediante Snowflake mantienen la misma gobernanza allí donde se encuentren: control de acceso granular basado en roles, políticas de enmascaramiento y de acceso a filas, linaje a nivel de columna e historial de acceso.
Horizon Catalog amplía ahora las políticas de acceso a filas y de enmascaramiento de Snowflake a motores externos como Apache Spark, Trino y PyIceberg, en vista previa pública. Horizon aplica las políticas al planificar cada exploración, de modo que los motores solo reciben los datos que el usuario tiene permiso para ver y cada operación queda registrada en el historial de acceso de Snowflake.
Como Horizon aplica estas políticas de forma centralizada, se asignan automáticamente a cada solicitante, ya sea un analista humano, una herramienta de inteligencia empresarial (BI) o un agente de IA.
Cuando se necesitan controles más estrictos para la IA, la funcionalidad de identidad de agentes de Snowflake permite a los administradores definir a qué datos puede acceder un agente, independientemente del usuario que lo haya invocado. Las políticas de enmascaramiento y de acceso a filas pueden focalizar directamente las sesiones de los agentes. Las acciones se atribuyen tanto al usuario como al agente que las ha realizado, de modo que los equipos de cumplimiento disponen de un registro de auditoría que indica a qué accedió la IA y cuándo.
Para las empresas europeas, esto no es un mero detalle de cumplimiento más. Es la base arquitectónica. El RGPD, los requisitos de residencia de datos y el Reglamento de Inteligencia Artificial de la UE implican que la ubicación de los datos, quién puede acceder a ellos y cómo se auditan las decisiones de la IA son decisiones de diseño y responsabilidades.
Una arquitectura diseñada para aplicar la gobernanza a los datos in situ, con políticas que se aplican de forma coherente y un linaje trazable de extremo a extremo, puede ayudar a las organizaciones a cumplir esos requisitos sin obligarlas a consolidar los datos en una única región o sistema.
La arquitectura
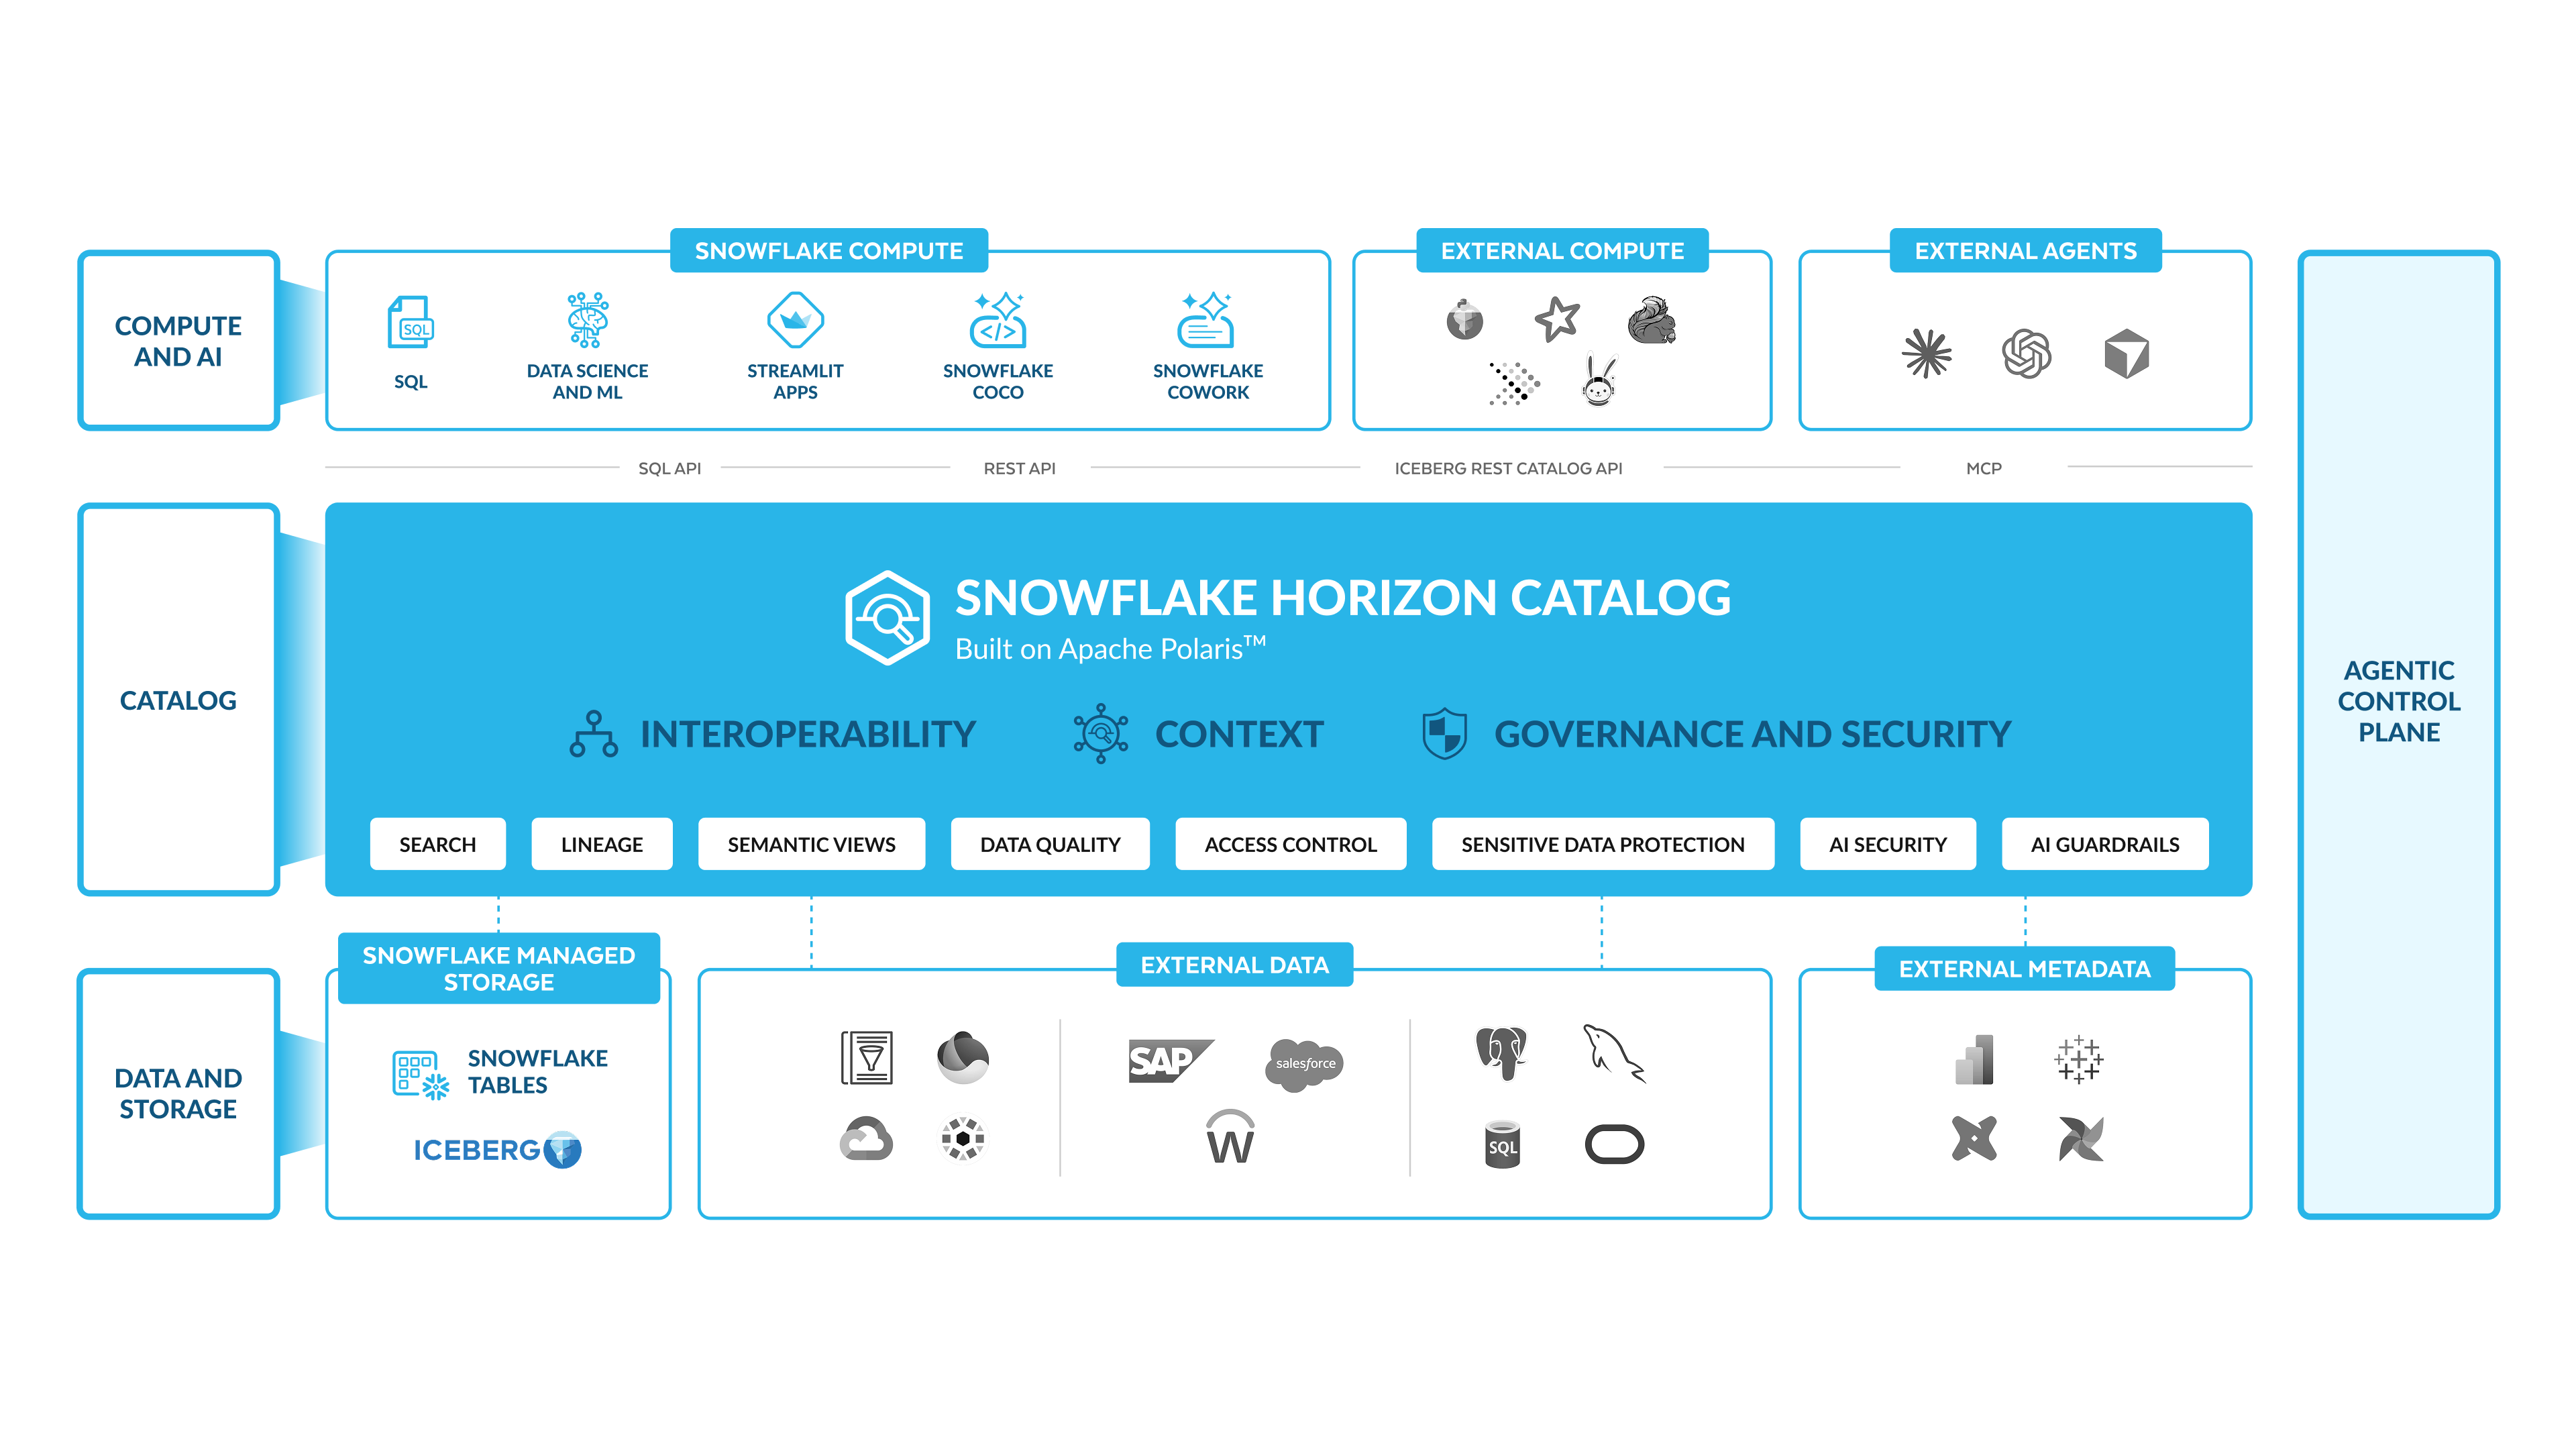
Snowflake te permite trabajar con tus datos allí donde ya se encuentran. Una única capa gobernada que abarca el cómputo, el catálogo y el almacenamiento para que la IA se ejecute sobre tus datos tal como están hoy, no después de migrarlos a otra plataforma. Así funciona en la práctica este salto tecnológico: el calendario de la IA y el de la migración están desacoplados.
Cómputo e IA: Ejecuta los workloads donde resulte más conveniente, en Snowflake o en motores externos.
Catálogo: Una única capa de gobernanza para los datos abiertos y los gestionados por Snowflake.
Datos y almacenamiento: Consulta los datos in situ sin tener que copiarlos primero.
Plano de control agéntico: Los agentes operan dentro del mismo perímetro gobernado que todo lo demás.
Conectar un patrimonio de datos global
NTT DATA, líder mundial en IA, negocio digital y servicios de tecnología, gestiona uno de los entornos tecnológicos más grandes y complejos del mundo y presta servicio a clientes de los principales sectores. Con datos distribuidos entre sistemas acumulados durante décadas, el reto no era la falta de inversión, sino conseguir que esa inversión funcionara de forma conjunta sin poner en marcha otro programa de consolidación de varios años.
“Para NTT DATA, la colaboración con Snowflake va más allá de llevar más datos a otra plataforma. Se trata de facilitar el acceso, la gobernanza y el consumo de los datos en un entorno tecnológico global y complejo. De este modo, estamos creando un fundamento de datos ágil y de alto rendimiento para la IA, la innovación y la transformación, al tiempo que mantenemos la flexibilidad necesaria para hacer evolucionar nuestro entorno tecnológico sin añadir más complejidad”.
Nick Cheesman
CIO, NTT DATA, Inc.
Evitar el Salvaje Oeste
La velocidad sin arquitectura genera sus propios problemas, como ocurre con una ciudad construida sin un plan urbanístico.
Por las prisas por ofrecer algo, las organizaciones pueden crear un Salvaje Oeste de herramientas de IA dispares. El resultado son soluciones fragmentadas y resultados incoherentes que socavan la confianza en los resultados de la IA. La solución consiste en crear workloads de IA dentro de un marco de gobernanza existente desde el primer día, aunque ese marco todavía esté en desarrollo. Los nuevos casos de uso se convierten en campos de pruebas que aportan información para hacer evolucionar la estrategia de datos y la arquitectura.
La modernización sigue siendo importante y la IA puede ayudar a acelerarla. Las migraciones pueden avanzar más rápido cuando la IA se encarga de buena parte del trabajo pesado. La IA puede ser tanto el resultado de la modernización como una herramienta para impulsarla.
Por dónde empezar
El entorno nunca estará terminado, así que deja de preguntarte cuándo estarán listos los datos y plantéate cuánto cuesta esperar otro trimestre. El punto de partida práctico es un proyecto piloto específico. Prioriza un caso de uso que pueda demostrar valor rápidamente y generar la credibilidad necesaria dentro de la organización para ir más lejos.
“Break the Sequence” analiza con más detalle la arquitectura en la que se basa la estrategia del salto tecnológico, incluido cómo los workloads de IA y la modernización comparten un fundamento de datos abierto y gobernado para que el trabajo realizado hoy esté conectado con el que se complete más adelante. Descarga el ebook
