Si vous êtes architecte ou CIO, vous avez probablement reçu deux consignes contradictoires.
Le conseil d’administration exige : « Donnez-nous de l’IA cette année. » La méthode préconise : « Commencez par remettre les données en ordre. Migrez-les. Centralisez-les. Gouvernez-les. Ensuite, passez à l’IA. »
Le premier réflexe consiste généralement à déplacer les données vers une plateforme centralisée. Mais cette approche pose problème. Chaque déplacement de données augmente les coûts et les risques. De quoi donner des sueurs froides aux cadres dirigeants qui n’en ont pas conscience.
Pendant des années, déplacer les données était le prix à payer pour effectuer la moindre analyse. Pour exécuter une requête sur les données, il fallait passer par le moteur de calcul propriétaire du système qui les détenait. Pour les données dans Oracle, vous aviez besoin d’Oracle. Pour les données dans Teradata vous aviez besoin de Teradata. Toute analyse entre plusieurs systèmes exigeait d’abord de déplacer physiquement les données vers un emplacement unique. La centralisation devenait ainsi indispensable à tout ce qui suivait, y compris l’IA.
Cette séquence était logique il y a 10 à 20 ans. Aujourd’hui, elle n’est plus une nécessité technique.
Nous avons publié notre eBook « Innover sans attendre » pour expliquer comment les évolutions architecturales de ces dernières années permettent de lancer des projets d’IA sur vos données actuelles, tout en poursuivant la modernisation à son propre rythme.
Les formats ouverts changent la donne économique
Les formats de table ouverts, en particulier Apache Iceberg™, ont rompu la dépendance entre les données et le système qui les stocke. Tout moteur de calcul compatible peut lire les données au format Iceberg, dissociant ainsi le stockage du calcul.
Iceberg a véritablement ouvert la voie à l’interopérabilité entre les technologies. Vous pouvez publier des produits de données dans Salesforce, SAP ou Workday, puis les exploiter depuis la technologie de votre choix, sans copie ni création de pipelines complexes.
Pour un fabricant dont les données opérationnelles sont réparties entre un ERP et de nombreux autres systèmes, ces sources peuvent désormais être interrogées comme un actif unifié. Il en va de même pour un retailer dont les données clients résident dans un CRM, les transactions dans un système de point de vente et les stocks dans une plateforme de supply chain. Les données restent là où elles se trouvent. L’IA exécute ses tâches directement dans l’environnement où résident les données.
Voilà la stratégie de saut technologique en action : vous pouvez lancer l’IA sur vos données actuelles pendant que la modernisation suit son propre calendrier. Vos calendriers d’IA et de migration peuvent avancer indépendamment, sans laisser de côté vos investissements existants.
Grâce aux formats ouverts, vos données restent les vôtres. Les Iceberg Tables peuvent être stockées sous forme de fichiers Parquet dans votre propre espace de stockage cloud et lues par d’autres moteurs compatibles avec Iceberg. La lecture comme l’écriture fonctionne dans les deux sens : les données peuvent donc être exploitées sans être dupliquées.
Une gouvernance qui accompagne les données
L’ancien modèle liait la gouvernance à l’emplacement des données. Les données devaient être centralisées avant de pouvoir être gouvernées de façon cohérente. Chaque exigence de gouvernance devenait donc une raison supplémentaire d’achever la migration en premier.
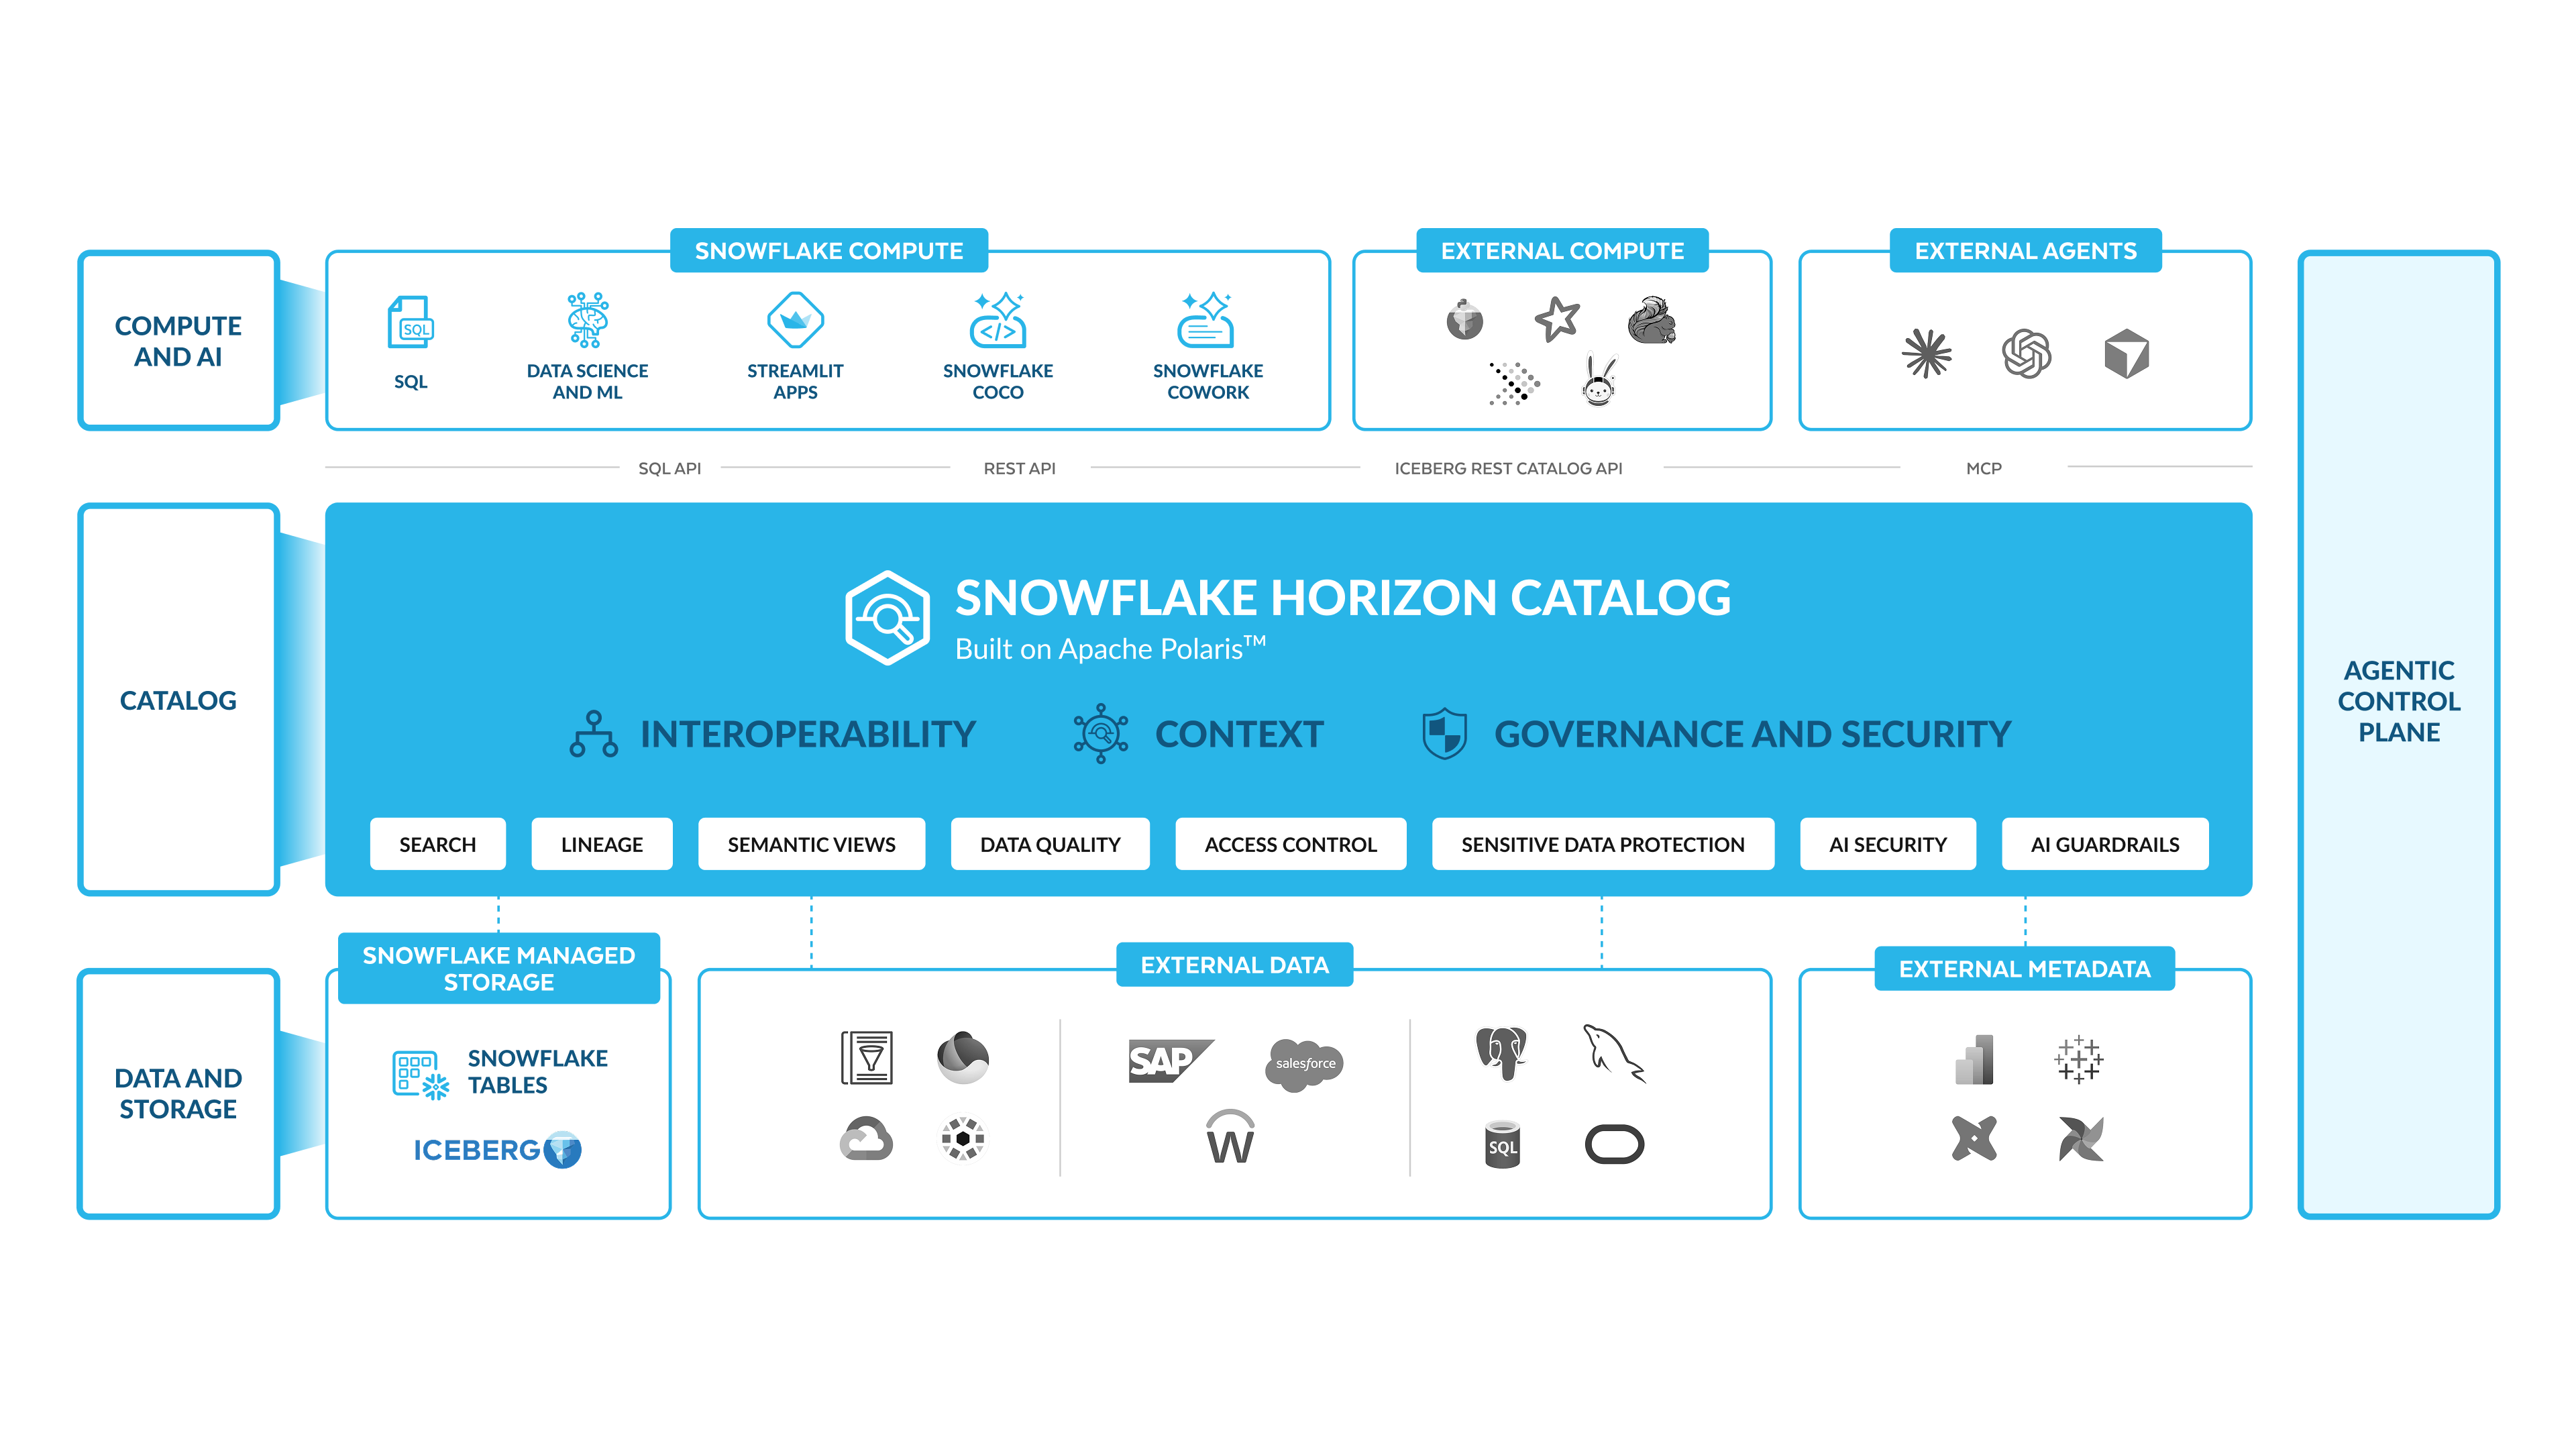
Cette dépendance appartient, elle aussi, au passé. Snowflake Horizon Catalog applique un ensemble unique de politiques aux données, produits de données, applications, modèles, agents et autres actifs, qu’ils se trouvent dans la plateforme ou en dehors. Les données accessibles via Snowflake bénéficient de la même gouvernance, où qu’elles résident : contrôle d’accès granulaire basé sur les rôles, masquage, politiques d’accès aux lignes, traçabilité au niveau des colonnes et historique des accès.
Horizon Catalog étend désormais les politiques d’accès aux lignes et les politiques de masquage de Snowflake à des moteurs externes comme Apache Spark, Trino et PyIceberg, dans le cadre de la public preview. Horizon applique les politiques lors de la planification de chaque analyse. Les moteurs ne reçoivent ainsi que les données que l’utilisateur est autorisé à consulter, et chaque opération est enregistrée dans l’historique des accès de Snowflake.
Comme Horizon applique ces politiques de manière centralisée, elles s’imposent automatiquement à chaque entité appelante, qu’il s’agisse d’un analyste, d’un outil de BI ou d’un agent d’IA.
Lorsque l’IA exige des contrôles plus stricts, la fonctionnalité Agent identity de Snowflake permet aux administrateurs de définir les données auxquelles un agent peut accéder, indépendamment de l’utilisateur qui l’a invoqué. Le masquage et les politiques d’accès aux lignes peuvent cibler directement les sessions des agents. Les actions sont attribuées à la fois à l’utilisateur et à l’agent qui les a effectuées. Les équipes de conformité disposent ainsi d’une piste d’audit indiquant les données auxquelles l’IA a accédé et à quel moment.
Pour les entreprises européennes, il ne s’agit pas d’un simple détail de conformité supplémentaire. C’est un socle architectural. Le RGPD, les exigences de résidence des données et le règlement européen sur l’intelligence artificielle (AI Act) font de l’emplacement des données, de leur accès et de l’audit des décisions de l’IA de véritables choix de conception et responsabilités.
Une architecture conçue pour gouverner les données là où elles résident, appliquer les politiques de façon cohérente et assurer une traçabilité de bout en bout peut aider les organisations à répondre à ces exigences sans imposer une consolidation dans une région ou un système unique.
L’architecture
Snowflake vous permet d’exploiter vos données directement dans l’environnement où elles résident. Une couche gouvernée unique couvrant le calcul, le catalogue et le stockage, pour exécuter l’IA sur vos données telles qu’elles sont aujourd’hui, sans attendre leur migration vers une nouvelle plateforme. Vous avancez sur deux fronts : vous dissociez votre calendrier de développement de l’IA de votre calendrier de migration.
Calcul et IA : exécutez chaque workload dans l’environnement le mieux adapté, Snowflake ou des moteurs externes.
Catalogue : une couche de gouvernance unique pour les données ouvertes et celles gérées par Snowflake.
Données et stockage : effectuez vos requêtes directement sur les données, sans avoir à les copier au préalable.
Plan de contrôle agentique : les agents opèrent dans le même périmètre gouverné que tous les autres actifs.
Connecter un patrimoine technologique mondial
NTT DATA, leader mondial de l’IA, du business numérique et des services technologiques, exploite l’un des parcs technologiques les plus vastes et les plus complexes au monde, au service de clients dans tous les grands secteurs d’activité. Avec des données réparties dans des systèmes accumulés au fil des décennies, le défi n’était pas le manque d’investissement. Il fallait faire fonctionner ces investissements ensemble sans lancer un nouveau programme de consolidation sur plusieurs années.
« Pour NTT DATA, le partenariat avec Snowflake ne consiste pas simplement à transférer davantage de données vers une plateforme de plus. Il vise à rendre les données plus faciles d’accès, à les gouverner et les exploiter au sein d’un écosystème technologique mondial complexe. Nous créons ainsi un socle data performant et agile pour l’IA, l’innovation et la transformation, et nous restons flexibles pour continuer à faire évoluer notre écosystème sans le complexifier. »
Nick Cheesman
CIO, NTT DATA, Inc.
Évitez le Far West
La vitesse sans architecture crée ses propres problèmes, comme une ville bâtie sans plan d’urbanisme.
Dans l’urgence de livrer, les organisations risquent de créer un véritable Far West d’outils d’IA disparates. Résultat : des solutions fragmentées et des résultats incohérents qui sapent la confiance dans l’IA. La solution consiste à créer dès le premier jour des workloads d’IA dans un environnement de gouvernance existant, même si celui-ci est encore en cours de développement. Les nouveaux cas d’usage deviennent des terrains d’expérimentation qui livrent des enseignements utiles pour faire évoluer la stratégie data et l’architecture.
La modernisation reste essentielle, et l’IA peut contribuer à l’accélérer. Les migrations peuvent progresser plus vite lorsque l’IA prend en charge une grande partie du travail. L’IA peut être à la fois le résultat de la modernisation et un outil pour la faire avancer.
Par où commencer ?
Votre patrimoine data ne sera jamais totalement finalisé. Cessez donc de vous demander quand les données seront prêtes et demandez-vous plutôt combien coûte un trimestre d’attente supplémentaire. La meilleure approche consiste à commencer par un pilote ciblé. Donnez la priorité à un cas d’usage capable de démontrer rapidement sa valeur et de renforcer la crédibilité nécessaire pour aller plus loin.
« Innover sans attendre » présente en détail l’architecture qui sous-tend la stratégie de saut technologique. Vous découvrirez notamment comment les workloads d’IA et la modernisation peuvent partager un socle ouvert et gouverné, afin que le travail réalisé aujourd’hui s’intègre à celui qui sera achevé demain. Télécharger l’eBook
