10 juin 2026/Lecture : 11 minProduit et technologie
Le data engineering à l’ère de l’IA : nouveaux outils Snowflake pour des pipelines intelligents
Avec l’IA, créer n’a jamais été aussi facile. Mais la facilité ne garantit pas une solution durable. Si vos systèmes manquent de robustesse et de résilience, l’IA ne fera qu’aggraver le problème. D’où l’importance d’une plateforme conçue pour exploiter pleinement le potentiel de l’IA.
Lors du Snowflake Summit 2026, nous avons annoncé de nouvelles fonctionnalités qui placent nos clients à l’avant-garde du data engineering. Nous avons intégré l’IA directement aux workflows et simplifié la création de pipelines de données de bout en bout. Ces nouvelles fonctionnalités s’adressent à tous les profils de data engineer. Elles fonctionnent là où résident vos données : dans Snowflake, dans des lakehouses ouverts et interopérables, ou dans les deux. Que vous écriviez votre code en SQL ou en Python, ou si vous souhaitez créer vos propres modèles de ML, tout le nécessaire pour construire vos pipelines est réuni au même endroit. Avec Snowflake, vous bénéficiez d’une performance de calcul élastique capable d’évoluer, d’une connectivité fluide aux données où qu’elles résident et de fonctionnalités de gouvernance de niveau entreprise. Vos données sont ainsi sécurisées, fiables et enrichies d’un contexte business concordant.
Accélérer la mise en production grâce à l’IA
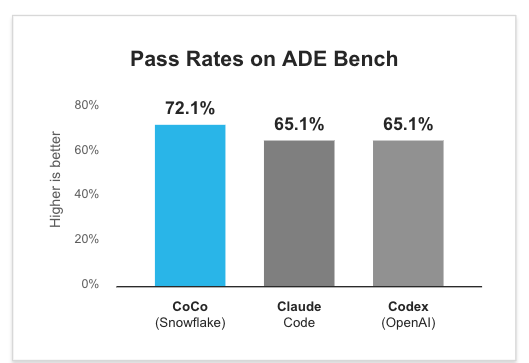
Figure 1 : Snowflake CoCo surpasse les agents de programmation généralistes dans les tâches de data engineering.1
Grâce aux nouveaux workflows agentiques, l’IA intervient directement dans votre environnement local pour créer des solutions de bout en bout. Pour les véritables projets de data engineering, Snowflake CoCo établit une nouvelle référence parmi les meilleurs agents de programmation. Par exemple, des benchmarks comparatifs avec Claude Code exécuté sur Opus 4.7 montrent que CoCo utilise 51 % de tokens en moins et nécessite 8 % d’étapes en moins pour accomplir une tâche.2
Grâce à une assistance contextuelle et à des compétences conçues pour les fonctionnalités de data engineering de Snowflake, CoCo opère dans votre périmètre de sécurité et, surtout, comprend le contexte des données de votre entreprise. Avec les modèles les plus récents, comme Claude Opus 4.8, Claude Sonnet 4.6 et GPT 5.5, les data engineers peuvent utiliser CoCo dans Snowsight, via la CLI CoCo ou désormais dans une nouvelle application de bureau, disponible en public preview. Utilisez des compétences prédéfinies ou personnalisées pour migrer des pipelines Spark, déployer du code Python, automatiser des workflows dbt, optimiser la performance et bien plus encore, le tout à partir d’un seul prompt.
Des pipelines autonomes dignes de confiance
Chaque organisation souhaite disposer en continu de données prêtes pour l’IA, à faible latence et issues d’un nombre croissant de sources. L’ancienne méthode, fondée sur des scripts d’orchestration artisanaux, une logique incrémentielle fragile et des déploiements manuels, permet difficilement de faire évoluer les traitements. Avec les workflows déclaratifs, vous définissez le résultat attendu, et Snowflake se charge de sa réalisation.

Chez Wolt (groupe DoorDash), nous avons standardisé notre architecture sur Apache Iceberg afin de pouvoir exécuter chaque workload sur le moteur le plus adapté. Nous utilisons les tables Iceberg dynamiques de Snowflake pour enrichir, préparer et actualiser automatiquement les données de notre data lake : il nous suffit de définir une seule requête assortie d'un niveau de fraîcheur cible, et Snowflake se charge des mises à jour incrémentielles et de l'orchestration. Grâce aux tables dynamiques sur Apache Iceberg, nous avons lancé nos pipelines plus rapidement, réduit le temps consacré à la maintenance et allégé la charge liée à nos pipelines incrémentiels. »
Raimund Kämmerer
Staff Data Engineer, Wolt
Des Dynamic Tables plus rapides et plus flexibles
Dynamic Tables élimine des heures de travail manuel en automatisant l’actualisation de vos données selon une requête définie et un objectif de fraîcheur. Dynamic Tables offre une performance de pointe et une faible latence aux pipelines incrémentiels. Lors du Summit, Sergey Labetsik, senior data engineer chez Wind Creek Hospitality, a montré comment son équipe avait réussi à fournir aux clients des bons de restauration moins d’une minute après qu’ils y étaient devenus éligibles. En migrant un job dbt par batch vers un pipeline Dynamic Tables, l’équipe a ramené la latence de bout en bout à moins d’une minute, contre une exécution planifiée toutes les 30 minutes auparavant.
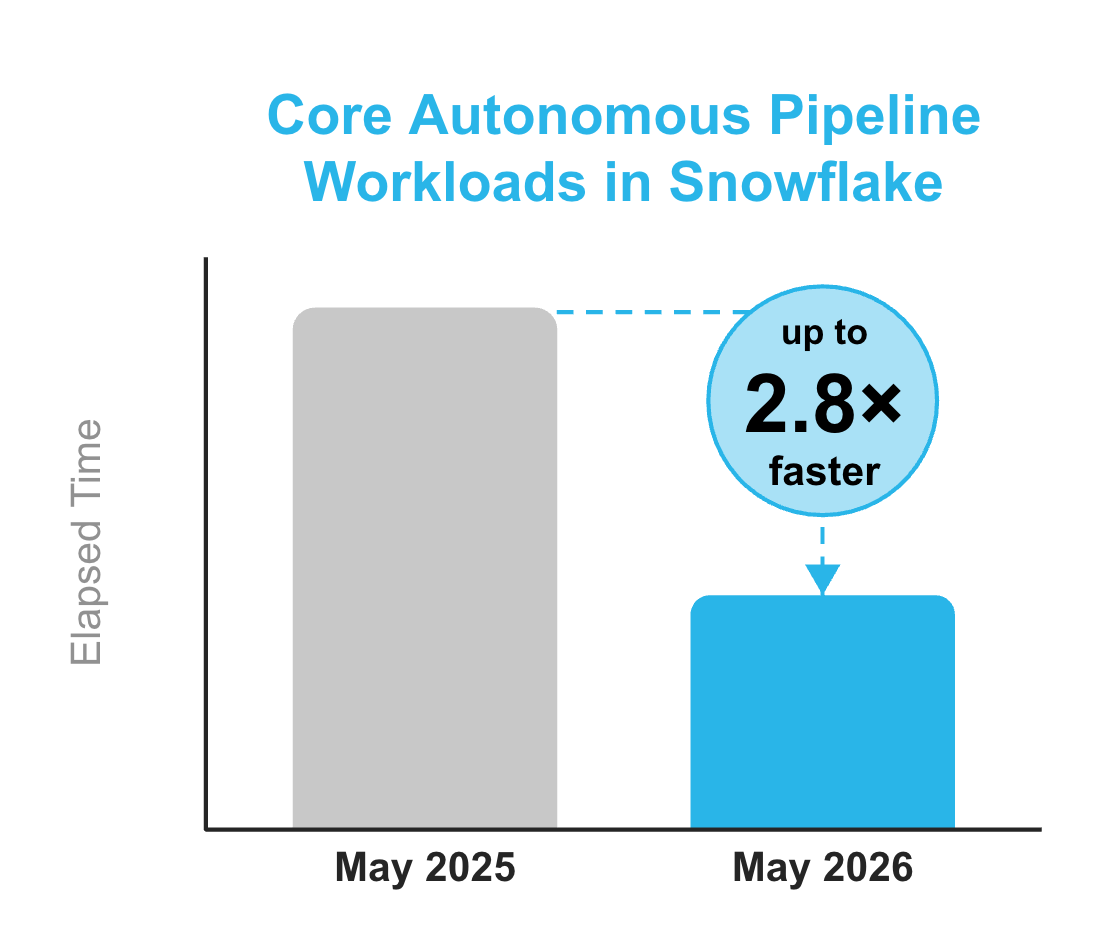
Snowflake a annoncé plusieurs nouveautés pour rendre ses workflows déclaratifs natifs plus performants, interopérables et expressifs, notamment :
- Actualisation plus performante des Dynamic Tables (disponible pour tous nos clients) : accélérez jusqu’à 2,8 fois les workloads dans plusieurs domaines, notamment les fonctions d’agrégation, qualify/rank (SCD-1), les opérations cluster-by et les jointures. Toutes ces mesures ont été réalisées sur des warehouses Gen2.
- Incrémentalisation personnalisée (public preview) : optimisez les performances des transformations complexes en écrivant votre propre logique d’actualisation avec des instructions MERGE ou INSERT, tout en conservant les avantages de Dynamic Tables, notamment la planification automatique, le suivi des dépendances et la réplication.
- Actualisation adaptative (public preview) : déterminez automatiquement la méthode d’actualisation la plus efficace à chaque cycle. Aucun réglage requis. Snowflake choisit systématiquement entre les actualisations incrémentielles et les réinitialisations afin d’optimiser les coûts, d’éviter les échecs sur les requêtes complexes et d’éliminer les réglages manuels.
- Matérialisation des Dynamic Tables dans dbt (version 1.11.5 de l’adaptateur) : optimisez le traitement incrémentiel en modifiant simplement le type de matérialisation dans dbt. Compatible avec les autres modèles dbt du pipeline.
- DCM Projects (public preview) : gérez l’infrastructure de manière déclarative grâce au versionnage, aux tests et au déploiement de divers pipelines de transformation sur Snowflake.
Intégrer dbt nativement à Snowflake
Avec dbt Projects on Snowflake, vous utilisez les fonctionnalités Snowflake que vous connaissez déjà pour créer, modifier, tester, exécuter et gérer vos projets dbt Core. Le déploiement d’un objet dbt Project vous offre une observabilité intégrée et une intégration CI/CD, tout en supprimant les frais opérationnels liés à la gestion autonome de l’infrastructure.
En tant que pionniers de dbt Projects, nous avons travaillé main dans la main avec Snowflake pour faire évoluer la feuille de route en fonction de la manière dont nos équipes conçoivent et exploitent réellement leurs projets. Cela a permis à une équipe resserrée d'avancer plus vite, tout en bâtissant un socle plus modulaire, mieux gouverné et évolutif, au service de l'analytique comme du déploiement de l'IA à l'échelle du groupe. »
António Costa
Director of Data Engineering, Aviv Group
Grâce aux nouveautés annoncées lors du Summit, davantage de clients standardisent leurs opérations sur dbt Projects. Ils peuvent remplacer la gestion de dbt Core tout en accédant à dbt Fusion et à une observabilité renforcée :
- dbt Fusion (disponible pour tous nos clients) est désormais proposé comme version avec dbt Projects on Snowflake. Grâce à notre partenariat avec dbt Labs, chaque dbt Project peut accéder à Fusion, conçu pour réduire les temps de compilation de nombreux builds complexes.
- DAG dbt enrichi d’un lignage au niveau des colonnes (disponible pour tous nos clients) utilise Snowflake Horizon Catalog pour intégrer les informations au niveau du schéma directement dans un graphe orienté acyclique (DAG), couvrant Workspaces, les détails des objets et Query History. Désormais, chaque exécution d’un objet dbt Project fournit une vue unifiée du lignage du pipeline de données.
Des pipelines programmatiques capables d’évoluer
Pfizer a réduit son coût total de propriété (TCO) de 57 % tout en quadruplant la vitesse de traitement de ses données grâce à Snowpark.
Toutes les transformations ne se prêtent pas à un modèle déclaratif. Pour les data engineers et data scientists qui créent des solutions par programmation en Python, Java, Scala et Apache Spark™, les transformations impliquent des jobs comme l’analyse complexe de fichiers, l’inférence ML par batch conçue pour évoluer et les workflows Python en plusieurs étapes. Ces utilisateurs constatent souvent que la mise en production prend plus de temps que l’écriture du code elle-même. Snowpark et Snowpark Connect for Apache Spark™ sont justement conçus pour réduire l’écart entre prototype et production.
Créer et orchestrer des Notebooks et des ML Jobs
Passer d’un notebook à un pipeline de production a toujours été plus compliqué que nécessaire. Le nouveau Pipeline Builder (private preview) change la donne : les équipes peuvent relier visuellement des Notebooks et des ML Jobs dans un pipeline complet de bout en bout, sans écrire le code d’orchestration à partir de zéro. La planification, l’infrastructure et la création d’objets sont automatisées. Les data scientists et les ingénieurs consacrent ainsi moins de temps à la configuration et davantage à leur travail. À la clé : des itérations plus rapides, moins de transferts entre équipes et des pipelines ML simples à surveiller et à reproduire dans Snowflake.
Créer avec Snowpark des pipelines capables d’évoluer
Snowpark intègre nativement à Snowflake l’expérience de développement en Python, Java et Scala. Les data engineers et data scientists peuvent écrire du code et itérer dans Notebooks, créer des transformations avec l’API DataFrame familière, créer un package et déployer leur logique sous forme de procédures stockées et de fonctions définies par l’utilisateur (UDF), puis tout planifier avec Tasks. De la première ligne de code aux pipelines de production, Snowpark offre aux développeurs un workflow complet de bout en bout. Leur code s’exécute directement là où résident les données, avec des fonctionnalités de gouvernance intégrées et sans infrastructure externe à gérer.
Nous avons enrichi Snowpark dans trois domaines clés : la productivité des développeurs, la connectivité externe et les nouveautés destinées aux workloads ML et aux données non structurées. Parmi les fonctionnalités enrichies :
- API d’intégration de données : récupérez par programmation des données depuis des bases externes. DB-API (disponible pour tous nos clients) prend en charge les pilotes Python pour Oracle, SQL Server, Postgres et MySQL ; JDBC-API (public preview) ajoute des lectures parallèles côté serveur depuis toute source JDBC.
- Traitement des données non structurées (disponible pour tous nos clients) : lisez, analysez et enrichissez des fichiers (images, PDF et fichiers audio) à l’échelle d’un warehouse avec
session.read.file(), associé à des fonctions d’IA commeai.extract(),ai.parse_document()etai.transcribe(). - Artifact Repository (bientôt en public preview) : utilisez des packages Python issus de référentiels hébergés par le client (Nexus, JFrog) pour les UDF, les procédures stockées et Notebooks, avec prise en charge de Private Link.
- Inférence ML par batch capable d’évoluer (private preview) : chargez les modèles une seule fois avec
@udf_init_once, puis partagez-les entre les workers afin de réduire l’utilisation de la mémoire et d’améliorer la performance sur les warehouses standard. - Code Bundles pour le déploiement en Python et Java (bientôt en public preview) : associez-les facilement à DCM Projects pour créer un package regroupant le code Snowpark et Snowpark Connect, puis le déployer de manière fiable et automatisée avec l’infrastructure dont il dépend. Ensemble, ces fonctionnalités offrent aux équipes de data engineering la même confiance dans leurs déploiements que celle dont bénéficient les équipes logicielles depuis des années.
Avec Snowflake, les équipes sont passées d'un code local Python ou Apache Spark à des workflows utilisables directement, en accélérant les performances d’un facteur de 5,1, et en baissant les coûts de 42 % en moyenne. [3]
Moderniser les pipelines Apache Spark avec Snowpark Connect
Moderniser une plateforme data ne devrait pas obliger à tout reconstruire à partir de zéro. Snowpark Connect offre aux équipes une voie de migration concrète pour transférer les pipelines Spark existants vers l’infrastructure moderne et managée de Snowflake, sans réécriture complète. Les ingénieurs peuvent abandonner des clusters Spark vieillissants et coûteux au profit d’une plateforme conçue pour faire évoluer les traitements aux volumes de données actuels, avec une gouvernance native, un calcul élastique et un accès fluide à tout l’écosystème Snowflake. Cette modernisation s’adapte à la situation actuelle des équipes et élimine les frais opérationnels hérités du passé.
Depuis le lancement de Snowpark Connect l’année dernière, Snowflake a développé de nombreuses nouveautés, notamment :
- Client Spark pour Scala et Java compatible avec Scala 2.12/2.13 et Java 11/17, avec la CLI
snowpark-submitpour une mise en production sans modification du code - Traitement des fichiers de la couche Bronze avec mode permissif, types de données complexes, évolution des schémas et lectures parallèles des fichiers compressés volumineux
- Observabilité unifiée pour détecter et diagnostiquer les problèmes liés aux jobs Spark, et alerter les utilisateurs avec des informations complètes (statut, durée, ressources, requêtes et journaux) provenant de Jupyter, Airflow ou de sources externes
Intégrer le contexte sémantique à votre pipeline
Ces dix dernières années, les définitions business sont restées en dehors du pipeline. Les métriques étaient définies dans les outils de BI, les features dans les stores ML, et chaque équipe avait sa propre version de la vérité. Avec les vues sémantiques, la situation évolue. Les data engineers peuvent désormais intégrer le sens directement au pipeline. Avec Snowflake Semantic View dbt Package, nous intégrons cette fonctionnalité aux workflows dbt. Les équipes définissent leur couche sémantique directement dans les fichiers de modèles dbt à l’aide de la syntaxe DDL standard, et CoCo peut les aider à rédiger cette définition. Exécuter dbt build permet de créer ou de mettre à jour la vue sémantique dans Snowflake, tout en la synchronisant avec le reste du pipeline. Horizon Context va encore plus loin en mettant automatiquement ces définitions à la disposition de chaque agent d’IA, outil de BI et application qui accède à vos données.
Une nouvelle ère pour le data engineering
Nous savons depuis des années qu’un problème systémique ne se résout pas à coups de recrutements. Il en va de même avec l’IA. Lorsque les data engineers utilisent l’IA pour livrer des solutions sur des plateformes héritées et fragiles, la dette technique ne disparaît pas, elle s’accumule plus vite. Résultat : des pipelines qui tombent en panne, une infrastructure difficile à maintenir et des produits de données qui ne suivent pas le rythme des besoins stratégiques. Dans cette nouvelle ère de l’IA, la vitesse de création risque de dépasser la qualité des fondations sur lesquelles elle repose.
Snowflake associe des expériences de codage agentique spécialement conçues pour le data engineering à la plateforme gouvernée qu’exigent les workloads d’IA. Que vous adoptiez une architecture open lakehouse, migriez des charges de travail Spark, cherchiez à faire évoluer des pipelines d’inférence ML ou déployiez une toute nouvelle plateforme data, Snowflake fournit à chaque profil du data engineering les outils nécessaires pour accélérer, livrer en toute confiance et consacrer moins de temps aux contraintes d’infrastructure. L’ère agentique du data engineering est arrivée.
Pour commencer, téléchargez gratuitement l’eBook « Créer des pipelines pour l’IA : le guide indispensable d’un data engineering plus intelligent », puis découvrez les nouvelles versions et annonces phares du Snowflake Summit 2026.
- D’après les résultats d’ADE Bench comparés à Claude Code. ↩
- Attention : Le score d’efficacité repose sur des tests internes utilisant ADE-bench, un framework créé par dbt pour évaluer les agents d’IA sur des tâches réelles d’analytics et de data engineering. ↩
- D’après des cas d’usage clients en production et des démonstrations de faisabilité comparant la vitesse et le coût de Snowpark entre novembre 2022 et mai 2026. Les gains réels de vitesse et les réductions de coûts dépendent de l’environnement propre à chaque client et des profils de charge de travail. ↩