10 sept. 2026/Lecture : 7 minStratégie et perspectives
Data engineering autonome : 5 étapes vers une véritable maturité agentique
Le data engineering est un métier exigeant : il faut enquêter pendant des heures sur des exécutions qui ont échoué, absorber un flux constant de demandes des équipes business et expliquer à la compta pourquoi le coût de tous ces pipelines ne cesse d’augmenter. Et à bien des égards, l’IA complique encore la donne : elle multiplie les volumes et les types de données, tout en laissant beaucoup plus de gens dans l’entreprise les exploiter grâce à des agents de chat et de codage capables d’écrire du SQL à leur place. La plupart des équipes de data engineering tentent de suivre le rythme en adoptant leurs propres agents de codage. Pourtant, elles semblent accumuler toujours plus de retard.
Selon un rapport de MIT Technology Review intitulé « Redefining Data Engineering in the Age of AI », huit organisations sur dix ont déployé des outils d’ingénierie des données fondés sur l’IA. Dans le même temps, les ingénieurs data doivent gérer une complexité croissante. Leur principale difficulté concerne la sécurité et la confidentialité des données, citées par 55 % des répondants.
Il faut changer de cap en profondeur. Plutôt que de demander à l’IA d’accélérer les processus existants, il est temps de repenser ces processus et de dépasser la création et la maintenance manuelles des pipelines. Les équipes data pourront consacrer davantage de temps au résultat du data engineering, les produits de données, plutôt qu’à la transformation progressive des données brutes. Il deviendra stratégique pour les équipes de proposer des données prêtes à être exploitées par les humains comme par l’IA, sans perdre leur contexte ni leur gouvernance.
L’avenir du data engineering reposera sur la création de produits de données concrets et exploitables, capables d’éclairer les décisions business. De véritables agents autonomes créeront, maintiendront et optimiseront tout ce qui est nécessaire pour actualiser ces produits, tandis que les humains resteront les principaux décisionnaires et arbitres.
Ces agents détecteront les besoins en nouveaux produits et les problèmes ou défaillances des produits existants. Ils rechercheront aussi les possibilités d’amélioration, de nettoyage et d’optimisation.
Les humains resteront bien sûr stratégiques, mais leur rôle gagnera en importance : définir les enjeux business prioritaires, orienter les agents vers l’architecture globale adéquate et veiller à ce que le contexte business soit correctement transmis aux agents qui exploitent les produits de données.
Les emplois « professionnalisés » par l’IA progressent deux fois plus vite que ceux qu’elle « démocratise », et les salaires correspondants augmentent 42 % plus rapidement depuis 2021.
Source: PwC AI Jobs Barometer 2026
En route vers le data engineering autonome
Cette évolution est majeure. Les équipes ne pourront pas, et ne devraient pas, la mener du jour au lendemain. Mieux vaut reconnaître qu’il s’agit du bon objectif, puis progresser par étapes, de façon réfléchie. À chaque étape, les équipes cerneront mieux les capacités des agents et des modèles. Elles détermineront ainsi ce qui peut être automatisé en toute sécurité et où ajouter des contrôles avec humain dans la boucle (HITL), des outils ou des processus. De nombreuses entreprises ont déjà entamé ce parcours : toute équipe ayant adopté un cycle de vie défini par logiciel, le contrôle de version, des pipelines déclaratifs ou le développement assisté par l’IA a déjà fait un pas vers l’avenir.
La courbe de maturité du data engineering autonome
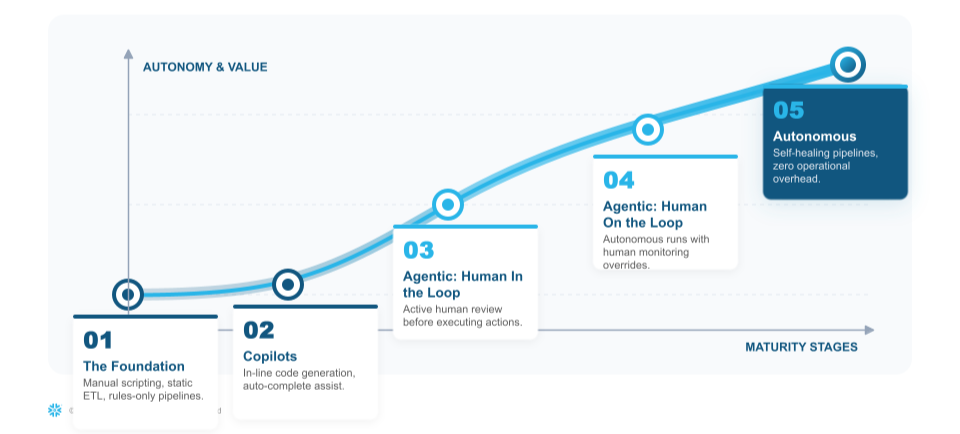
| Étape 1 : les fondamentaux |
À ce stade, les data engineers construisent et maintiennent les pipelines manuellement. Chaque modification de schéma, décision d’orchestration ou réponse à une défaillance nécessite une intervention humaine. Les équipes qui profitent de l’étape 1 pour maîtriser les fondamentaux de l’ingénierie réussiront mieux les étapes suivantes. L’adoption de pratiques de data engineering plus modernes, comme les pipelines déclaratifs, peut améliorer l’efficacité. Travelpass, par exemple, a rendu ses activités de data engineering plus accessibles. L’équipe a ainsi pu faire évoluer ses opérations et fournir des données aux unités business avec une efficacité accrue de plus de 350 %. |
| Étape 2 : les copilotes |
C’est à ce stade que l’IA entre dans l’éditeur. La saisie semi-automatique et la génération de code à la volée simplifient la transformation et la configuration, mais les data engineers restent responsables de chaque décision. Le workflow fondamental reste inchangé, même si la production augmente. |
| Étape 3 : agentique : l’humain dans la boucle |
À l’étape 3, l’IA commence à jouer le rôle de collaborateur. Les agents peuvent proposer des changements, comme la modification de pipelines, la correction de défaillances ou la migration de schémas. Mais rien ne s’exécute sans l’approbation explicite d’un humain. Les data engineers révisent le code au lieu de l’écrire, ce qui réduit considérablement le délai de réponse aux incidents. |
| Étape 4 : agentique : la supervision humaine |
C’est ici que les avantages de l’automatisation prennent toute leur ampleur. Les agents exécutent de façon autonome certaines tâches clairement définies, comme la détection d’anomalies ou l’adaptation des pipelines aux changements en amont, sans attendre d’approbation. Les data engineers conservent une visibilité sur les actions des agents et peuvent les remplacer si nécessaire. |
Étape 5 : |
À l’étape 5, le data engineering a profondément redéfini le travail dans la data. Les pipelines détectent leurs propres défaillances, identifient les causes premières des problèmes du stack, appliquent des correctifs, valident les résultats et documentent les changements sans intervention humaine. Les frais opérationnels deviennent presque nuls. Les data engineers définissent les politiques, les normes et la sémantique business. Ils déterminent également ce que la plateforme peut faire de manière autonome et ce qui exige leur jugement. Les changements à fort impact sont ainsi soumis à une validation humaine. Leur rôle passe entièrement de l’exécution à la gouvernance : de simples créateurs de pipelines, ils deviennent de véritables partenaires business. |
« Le fait de tout réaliser exclusivement dans Snowflake a changé la donne. Aujourd’hui, nous pouvons concevoir une solution le jeudi et la mettre en production dès le mardi suivant. »
Thomas Bodenski
COO & Chief Data & Analytics Officer, TS Imagine
Repenser la création des produits de données à l’ère agentique
Cette évolution majeure implique de ne plus raisonner en pipelines de données, mais en produits de données. Ceux-ci englobent les données, la sémantique, la qualité et tout ce dont un agent a besoin pour accomplir ses tâches. Par exemple, un produit de données consacré à la fidélité client peut inclure des données sur le risque d’attrition. Il associe alors les données d’activité de chaque compte à une vue sémantique précisant ce que le business considère comme « à risque », ainsi qu’à des contrôles qualité documentés. Tout agent ou analyste accédant à ce produit de données obtient alors une réponse homogène et fiable pour mener ses actions de fidélisation client.
Le modèle traditionnel part de l’infrastructure et remonte progressivement : construire le socle data, définir les schémas, créer les pipelines, puis répondre à un besoin business. Cette approche fonctionnait lorsque les produits de données étaient peu nombreux et stables.
Les équipes data modernes inversent désormais cette logique : elles partent du problème business et identifient le workflow d’agent capable d’y répondre. Elles déterminent les données dont cet agent a besoin, puis créent le produit de données qui les lui fournira. Cette approche réorganise le patrimoine data autour des résultats business plutôt que des couches techniques. Elle instaure une conception verticale des produits de données, dans laquelle les pipelines visent des résultats, et non des schémas.
Dans un véritable data engineering autonome, la plateforme compte autant que le choix du framework d’agents. Les équipes les plus performantes doivent d’abord renforcer le contrôle de version, les tests automatisés et les pipelines CI/CD, ces mêmes bonnes pratiques que les meilleures équipes data adoptent depuis des années. La gouvernance, l’interopérabilité et l’unification des données sont les prérequis indispensables pour faire confiance aux workflows autonomes en toute sécurité.
Créer les fondations ; le data engineering autonome suivra
Le passage au data engineering autonome est une nécessité opérationnelle. Les équipes qui atteindront le plus rapidement la maturité n’y parviendront pas parce qu’elles disposent des meilleurs modèles. Elles réussiront parce qu’elles auront élevé le data engineer au rang de partenaire business et créé des fondations assez fiables pour accueillir des agents autonomes, avec une gouvernance suffisamment efficace pour leur faire confiance.
Pour réussir ce parcours, les clients doivent miser sur une plateforme qui répond à leurs besoins actuels, mais qui saura aussi évoluer et intégrer les nouvelles innovations en matière de data engineering et d’IA, sans les obliger à tout assembler ou créer eux-mêmes. Découvrez comment Snowflake établit une nouvelle référence pour mesurer la qualité et l’efficacité des tokens dans les tâches de data engineering autonome grâce au Data-eng-benchmark.
Pour savoir concrètement comment vous lancer dans le data engineering autonome, avec notamment des modèles d’architecture, des frameworks de gouvernance et les pratiques d’ingénierie qui rendent les workflows agentiques fiables, consultez Créer des pipelines pour l’IA : le guide essentiel d’un data engineering plus intelligent.
