16 sept. 2026/Lecture : 8 minData engineering
Découvrez un parcours simplifié entre les producteurs de données et Snowflake : Elastic Channels prend en charge jusqu’à 20 Go/s
Aujourd’hui, nous annonçons la disponibilité générale d’Elastic Channels pour Snowpipe Streaming. Ils simplifient la diffusion en streaming des données depuis les applications, appareils et services directement vers les tables Snowflake ou les tables Apache Iceberg™ gérées par Snowflake. Les équipes peuvent supprimer les systèmes d’ingestion uniquement destinés à transférer les données. Elles simplifient ainsi leurs opérations, réduisent la latence et peuvent diminuer le coût total de possession.
Cette simplicité fait toute la différence pour les organisations qui exploitent des produits connectés, des systèmes industriels et des applications numériques. Les appareils envoient continuellement des données de télémétrie, les applications génèrent des événements utilisateur et les services évoluent indépendamment. Pour rendre ces signaux accessibles à l’analytique et à l’intelligence artificielle, un système d’ingestion presque aussi complexe que les applications qui les produisent peut être nécessaire.
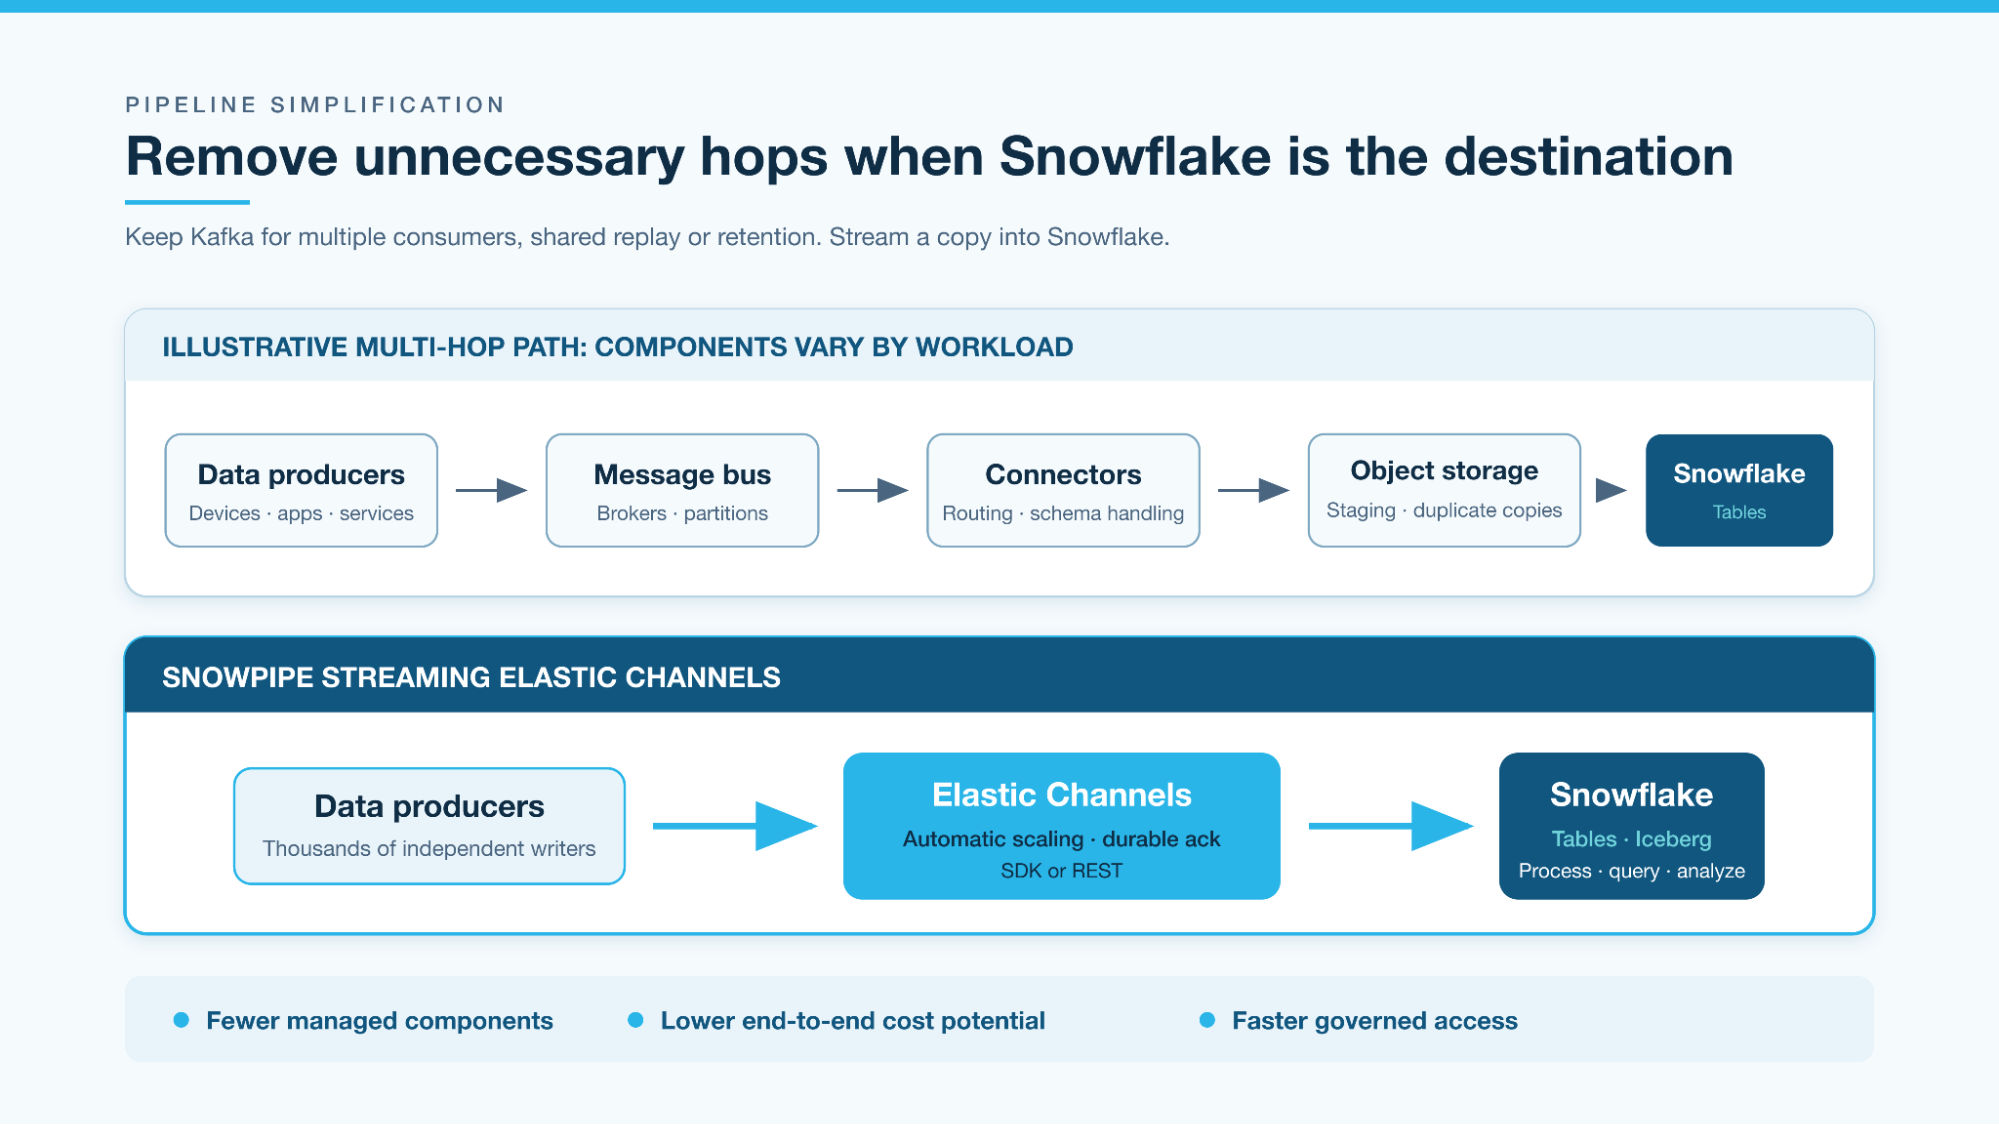
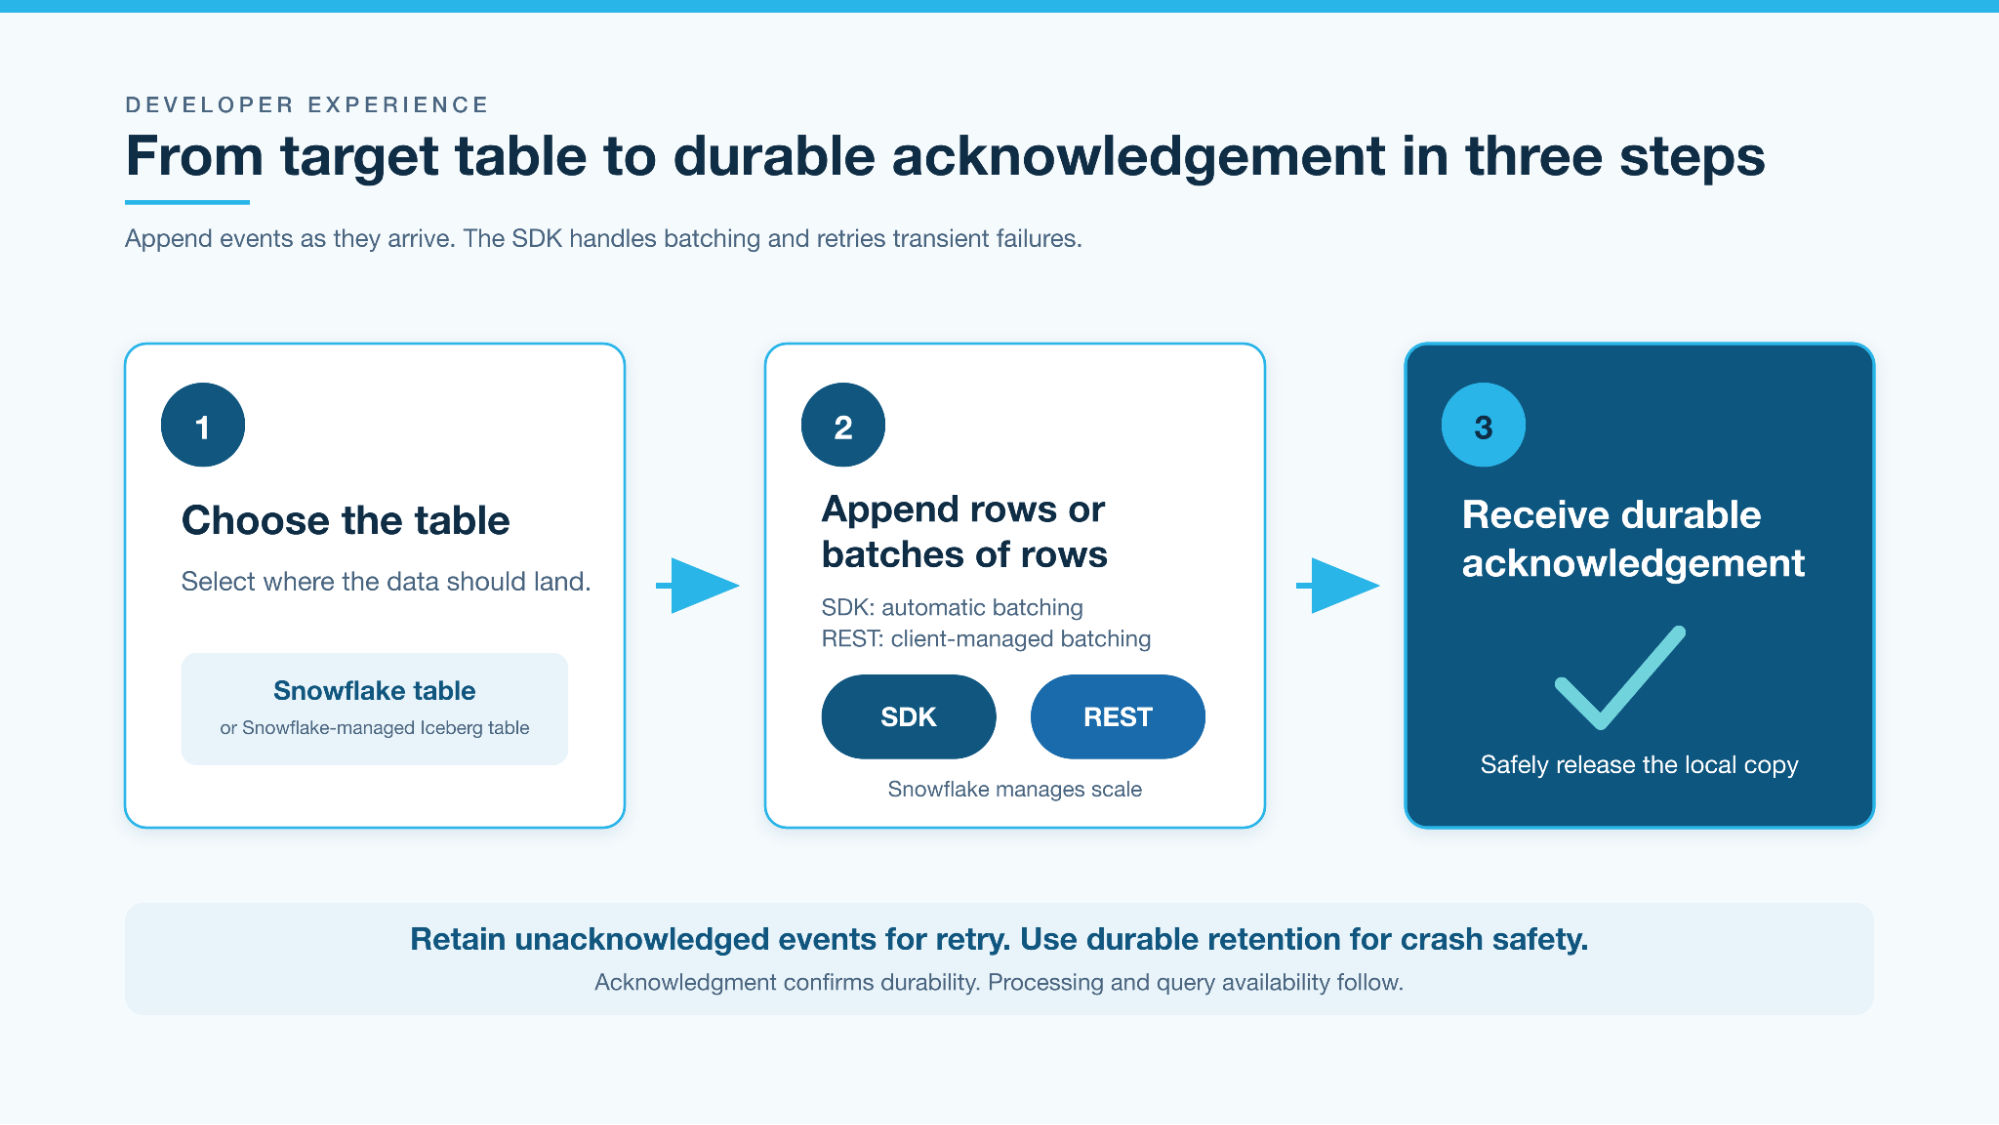
Elastic Channels simplifie ce processus : choisissez une table cible, ajoutez des lignes ou des lots de lignes et recevez un accusé de réception durable dès que Snowflake a stocké les données de façon persistante, avant même qu’elles ne soient accessibles par requête dans la table. Le SDK regroupe automatiquement les ajouts en lots et relance les opérations après les défaillances temporaires, tandis que Snowflake gère l’évolution de l’ingestion et le cycle de vie des canaux. Vous avez ainsi moins besoin d’un bus de messages ou d’un pipeline intermédiaire distinct uniquement destiné à transférer les données vers Snowflake.
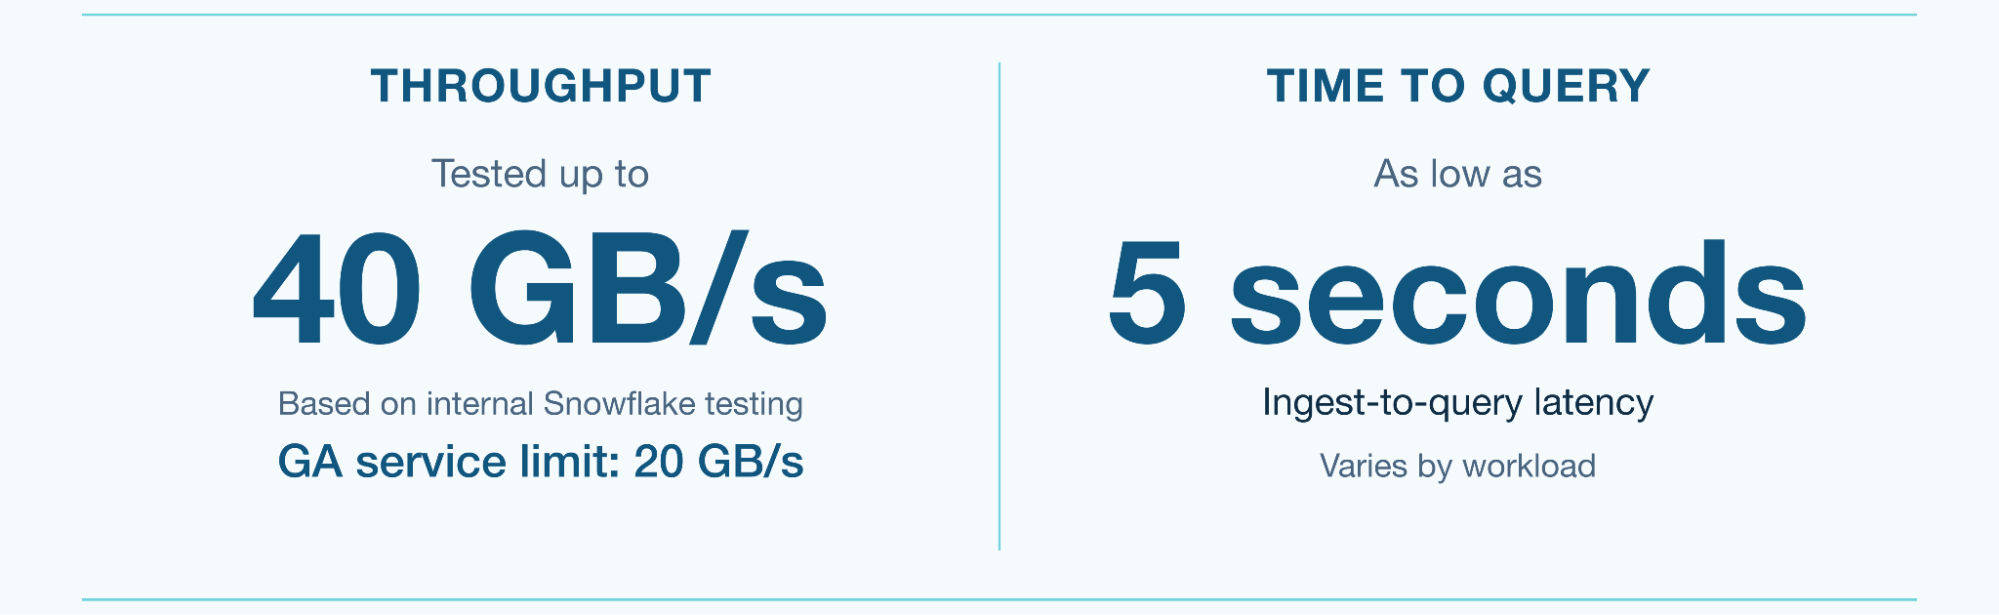
Cette expérience simplifiée répond également aux exigences des charges de travail les plus intensives. Lors de leur disponibilité générale, Elastic Channels prend en charge jusqu’à 20 Go/s par table. Selon la charge de travail, les données peuvent être accessibles aux requêtes en seulement cinq secondes. Lors de nos tests internes, nous sommes allés encore plus loin, avec un débit atteignant 40 Go/s dans une seule table. Notre prochain article analysera ces résultats de benchmark et notre méthode de mesure. Un troisième article, plus technique, explorera l’architecture et la conception des Elastic Channels.
Pour en savoir plus ou faire vos premiers pas avec Elastic Channels, consultez notre documentation sur Elastic Channels.
Du défi client au chemin direct vers les données
Snowflake a développé Elastic Channels aux côtés de clients confrontés à deux défis distincts liés au streaming. Yuvital, qui fournit aux entreprises un environnement d’applications de récompenses et d’avantages, teste Elastic Channels pour simplifier ses pipelines et diffuser directement dans Snowflake les données analytiques utilisateur et les événements de parcours de navigation. HighByte, leader des logiciels Industrial DataOps, recherchait une solution plus simple pour prendre en charge des milliers de connexions et diffuser directement dans Snowflake les données industrielles et IoT, avec une disponibilité en quasi-temps réel. Ces partenaires de conception illustrent la nécessité de simplifier l’ingestion, aussi bien pour les applications numériques que pour les systèmes industriels.
Elastic Channels simplifie l’ingestion en limitant le recours à plusieurs systèmes dont le seul rôle consiste à transférer les données vers une table. Si vous utilisez déjà un bus de messages comme Kafka pour plusieurs consommateurs, la relecture partagée ou la conservation, vous pouvez le garder et diffuser une copie dans Snowflake à l’aide de nos canaux nommés.
Avec Elastic Channels, les clients créent une table cible, connectent les producteurs via un SDK ou REST, puis commencent à ajouter des lignes. Snowflake gère le chemin d’ingestion côté serveur à mesure que les parcs et le trafic augmentent.

Chez Yuvital, nous aidons les organisations à mobiliser leurs membres et à les encourager à adopter des comportements plus sains grâce à des récompenses et à des mesures incitatives. Les activités et les interactions de nos membres génèrent un flux continu d’événements, que nous intégrons à Snowflake afin de mieux comprendre leurs comportements, de personnaliser leur expérience et d’éclairer nos décisions métier. Nous utilisions Confluent, car c’était le moyen le plus rapide d’ingérer dans Snowflake des événements ajoutés en continu, sans modification des données existantes. Mais la solution était beaucoup trop complexe et coûteuse pour un besoin aussi simple. Avec Elastic Channels, il nous a suffi d’ajouter quelques lignes de code pour envoyer les événements directement depuis notre backend Node.js. Nous avons ainsi pu étendre très facilement le dispositif. »
Yaron Levi
Chief Architect and Co-Founder, Yuvital
Simple pour les producteurs, durable et stratégique pour l’entreprise
Elastic Channels est conçu pour les charges de travail dans lesquelles de nombreux producteurs indépendants partagent une même destination :
- Un chemin d’ingestion partagé : Les producteurs écrivent via un seul canal élastique implicite pour le pipe et la table cibles.
- Aucune coordination entre les producteurs : Les applications n’ont pas à attribuer, suivre ou rééquilibrer les canaux d’ingestion lorsque les parcs et le trafic évoluent.
- Évolution automatique côté serveur : Snowflake répartit la charge de travail à mesure que le nombre de producteurs et leur trafic évoluent.
- Accusé de réception durable : Un producteur reçoit une confirmation une fois que Snowflake a stocké de façon persistante les données envoyées dans le service d’ingestion.
Après réception de l’accusé, le producteur peut supprimer la copie qu’il conservait : Snowflake a stocké les données de façon persistante. Le traitement et la disponibilité pour les requêtes interviennent ensuite. L’accusé de réception ne signifie pas que chaque ligne a terminé les traitements en aval. La latence indiquée ci-dessus mesure le délai entre l’ingestion et la requête, et non le délai d’accusé de réception.
Les producteurs doivent conserver les événements non confirmés afin de pouvoir réessayer leur envoi. En cas d’interruption, ils peuvent suspendre la réception ou, si la collecte doit continuer, utiliser une boîte d’envoi existante ou un tampon persistant local au producteur. Pour assurer la conservation des données en cas de panne, enregistrez les événements de façon persistante avant de les prendre en charge, puis supprimez-les après réception de l’accusé. Le tampon mémoire du SDK n’est pas une file d’attente persistante.
Les équipes peuvent utiliser Snowflake comme destination partagée et élastique pour les données opérationnelles de l’ensemble d’un parc ou d’un portefeuille d’applications, au lieu d’intégrer une logique de coordination à chaque producteur.
Des données continues aux résultats business
Le même modèle d’ingestion directe s’applique partout où de nombreux producteurs génèrent continuellement des données :
- Produits connectés et IoT : surveillez l’état des appareils et du réseau dans de vastes parcs, accélérez le passage de la télémétrie à la connaissance produit et intégrez de nouveaux producteurs sans attribuer un canal à chaque appareil.
- Opérations industrielles : transférez dans Snowflake les signaux issus des machines et des ateliers afin d’accélérer la détection des anomalies, la maintenance prédictive et l’optimisation opérationnelle.
- Sécurité et observabilité : diffusez en streaming les journaux, métriques, traces et événements comportementaux provenant d’agents distribués pour accélérer la détection des menaces et la réponse aux incidents.
- Applications numériques : capturez les événements de parcours de navigation et d’utilisation des produits depuis des services qui évoluent indépendamment, afin de soutenir la personnalisation, l’expérimentation et l’analyse client en quasi-temps réel.
HighByte Intelligence Hub aide les industriels à collecter et à contextualiser, à la périphérie du réseau, les données issues des équipements, des capteurs et des systèmes industriels, afin de les rendre directement exploitables dans Snowflake. Avec Elastic Channels, les clients peuvent augmenter le débit et simplifier la gestion de l’ingestion en acheminant des flux de données continus par des voies partagées. Ils n’ont ainsi plus à coordonner des canaux distincts pour chaque usine et chaque système producteur. Les accusés de réception persistants sont particulièrement importants pour les données industrielles, dont la perte est inacceptable. Ils permettent aux clients de conserver les données de manière fiable dans une mémoire tampon locale, puis de les transmettre à Snowflake dès que la connexion est rétablie. »
Jeffrey Schroeder
Director of Product Management, HighByte
Une sémantique flexible, sans complexité superflue
Snowpipe Streaming propose différentes fonctionnalités de streaming selon votre cas d’usage. Elastic Channels assure une livraison « en au moins une fois », sans garantir l’ordre. Les nouvelles tentatives ou relectures peuvent produire des doublons. Utilisez donc des identifiants d’événement stables lorsque la déduplication est essentielle. Les canaux nommés existants de Snowpipe Streaming répondent aux charges de travail qui exigent un ordre par canal et une livraison « en une seule fois ». Choisissez le modèle d’ingestion adapté aux exigences de votre application.
Natif sur la plateforme data Snowflake
Les données arrivent directement dans Snowflake, où les organisations peuvent appliquer des contrôles d’accès homogènes ainsi que des capacités de gouvernance, de transformation, d’analytique et d’intelligence artificielle. La suppression des couches de transit peut réduire le nombre de copies en double et limiter la durée pendant laquelle les données opérationnelles restent en dehors du périmètre de gouvernance de la plateforme.
Choisissez l’interface client et la table cible adaptées à votre application :
- SDK Python, Java et Node.js : ajoutez les événements à mesure qu’ils arrivent. Le SDK regroupe automatiquement les ajouts en lots selon des seuils de temps et de volume, puis relance les opérations après les défaillances temporaires. Les applications contrôlent le volume de données restant sans accusé de réception et attendent périodiquement la confirmation de leur persistance.
- API REST : idéale pour les services légers, les applications edge, les fonctions serverless, les webhooks et les langages sans SDK dédié. Les clients REST directs gèrent la création des lots NDJSON et leur compression. Une réponse positive confirme l’acceptation durable des données.
- Cibles d’ingestion : tables Snowflake et Iceberg Tables gérées par Snowflake.
Choisissez une table, ajoutez des lignes ou des lots de lignes, puis recevez un accusé de réception durable. Le SDK gère la création des lots pour le transport. L’exemple de code ci-dessous illustre un ajout unique et son accusé de réception.
Elastic Channels et les accusés de réception durables sont disponibles pour tous nos clients dans l’ensemble des régions commerciales AWS, GCP et Azure.
Elastic Channels est disponible sans coût supplémentaire. Snowpipe Streaming est facturé en fonction du volume de données non compressées ingérées, au tarif de 0,0037 crédit par Go. Pour plus d’informations, consultez Comprendre vos coûts dans la documentation Snowpipe Streaming.
Premiers pas avec Snowflake CoCo
Pour commencer, demandez à CoCo de vous aider à créer un pipeline Elastic Channels.
Demandez à CoCo : « Aide-moi à faire mes premiers pas avec Snowpipe Streaming Elastic Channels à l’aide de la documentation la plus récente https://docs.snowflake.com/fr/user-guide/snowpipe-streaming/data-load-snowpipe-streaming-overview »
CoCo peut générer la structure des objets Snowflake, le profil d’authentification, le code du producteur et les étapes de vérification.
Cet exemple Python minimal illustre un ajout unique et son accusé de réception. Les applications de production conservent les événements sans accusé de réception et attendent aux points de contrôle de persistance, plutôt qu’après chaque ligne :
from datetime import datetime, timezone
from snowflake.ingest.streaming import StreamingIngestClient

client = StreamingIngestClient.from_table(
    client_name="sensor_producer",
    db_name="MY_DATABASE",
    schema_name="MY_SCHEMA",
    table_name="SENSOR_READINGS",
    profile_json="profile.json",
)

channel = client.get_elastic_channel()
ack = channel.append_row_with_wait({
    "DEVICE_ID": 1,
    "READING_TS": datetime.now(timezone.utc),
    "TEMPERATURE": 21.5,
})
ack.result()  # Data has been durably accepted by Snowflake.
Vous pouvez également :
- Consulter notre documentation pour en savoir plus sur Snowpipe Streaming et faire vos premiers pas avec Elastic Channels
- Explorer les exemples d’applications Snowpipe Streaming pour Python, Java et Node.js.
- Consulter notre Guide de démarrage rapide officiel
Créez une table, connectez un producteur, ajoutez des lignes ou des lots de lignes et laissez Snowflake gérer l’évolution de l’ingestion et le cycle de vie des canaux.