29. Sept. 2026/Lesezeit: 5 MinutenProdukt & Technologie
Jenseits der Vorfallsreaktion: OpenTelemetry in ein Enterprise Data Asset verwandeln
Eine der interessantesten Veränderungen, die ich bei der Arbeit mit Kund:innen bei Snowflake beobachtet habe, ist die Entwicklung unserer Gespräche über Observability.
Vor einigen Jahren konzentrierten sich technische Führungskräfte auf Instrumentierung und Transparenz: Wie erfassen wir mehr Telemetrie? Wie reduzieren wir die mittlere Lösungszeit? Wie erhalten wir einen besseren Einblick in immer komplexere Systeme?
Heute machen OpenTelemetry und moderne Observability-Plattformen wie Observe by Snowflake die Beantwortung vieler dieser Fragen einfacher. Gespräche über Observability können nun mit Geschäftskennzahlen und -ergebnissen beginnen, nicht mit Protokollen, Metriken und Traces. Das Ziel ist nicht mehr nur zu verstehen, was in verteilten Systemen passiert, sondern technische Daten damit zu verknüpfen, was sie für das Unternehmen bedeuten.
Dieser Wandel wirft eine Reihe praktischer Fragen für Engineering-Teams auf:
- Wie lange sollten wir Telemetrie aufbewahren?
- Wie verbinden wir operative Daten mit Kunden- und Geschäftsdaten?
- Wie kann Telemetrie Analysen und KI unterstützen?
- Wie stellen wir sicher, dass Observability-Daten offen und unter unserer Kontrolle bleiben?
Diese Fragen sind nicht theoretisch. Sie tauchen auf, sobald die technischen Auswirkungen eines Vorfalls zu einer Frage von Kundenabwanderung, Umsatz und geschäftlichen Auswirkungen werden.
Observability endet nicht, wenn der Vorfall endet
Stellen Sie sich ein hypothetisches großes Finanzdienstleistungsunternehmen vor, das Millionen von Kund:innen bedient. Wie bei vielen digitalen Unternehmen können selbst wenige Minuten Leistungseinbußen das Kundenerlebnis beeinträchtigen, das Supportaufkommen erhöhen und den Umsatz gefährden.
Während eines Produktionsvorfalls bemerkte das Engineering-Team eine erhöhte Latenz bei einem kundenorientierten Zahlungsdienst. Zunächst war unklar, wo das Problem seinen Ursprung hatte: in der Anwendung, in einer vorgelagerten Abhängigkeit oder in der zugrunde liegenden Infrastruktur. Das Team hatte keine unmittelbare Möglichkeit festzustellen, welche Kund:innen oder Transaktionen betroffen waren.
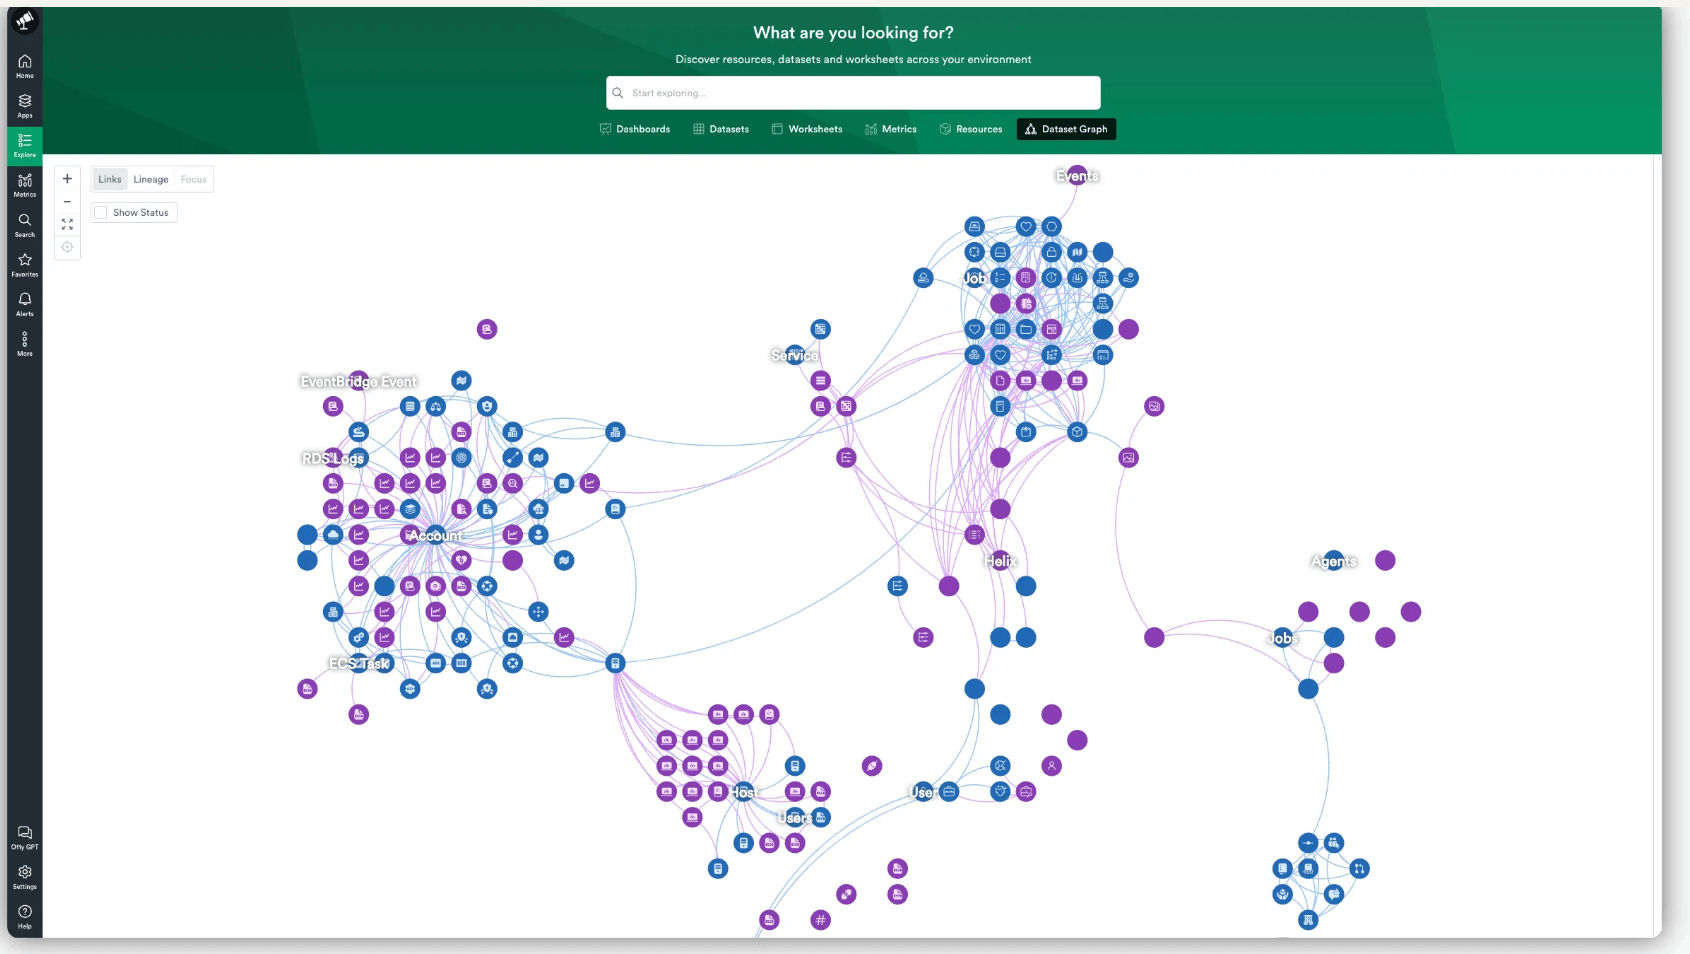
Das Team nutzte den Observability Context Graph von Observe und AI Site Reliability Engineering (AI SRE). Die Techniker:innen vereinten unterschiedliche Telemetrie-Streams, um die fehlerhafte Komponente zu isolieren, kartierten ihre nachgelagerten Auswirkungen durch komplexe Abhängigkeiten und brachten die Umgebung wieder in einen fehlerfreien Zustand.
Operativ war der Vorfall beendet. Aber strategisch gesehen fing er gerade erst an.
Das Engineering-Team hatte die Frage „Was ist kaputtgegangen?” beantwortet. Das Führungsteam begann jedoch sofort, Folgefragen zu stellen:
- Was waren die Auswirkungen auf die Kund:innen?
- Wie viel Umsatz war gefährdet?
- Waren bestimmte Zahlungsanbieter stärker betroffen als andere?
Ist dies ein isolierter Vorfall oder der Beginn eines breiteren Zuverlässigkeitstrends?
Um die Antworten zu erhalten, musste die operative Telemetrie mit Kundenkonten, Zahlungstransaktionen, Bereitstellungsverlauf und Produktnutzung kombiniert werden. Zu diesem Zeitpunkt war Observability nicht mehr nur ein operatives Problem, sondern wurde zu einem Datenproblem.
Von der Ursache zu den geschäftlichen Auswirkungen
Die Anreicherung der operativen Telemetrie mit Kunden-, Produkt- und Finanzkontext verschaffte den technischen und geschäftlichen Führungskräften des Unternehmens eine gemeinsame Sicht auf die Auswirkungen des Vorfalls. Anstatt bei der Ursachenanalyse stehen zu bleiben, konnte das Team die Auswirkungen auf seine Kund:innen quantifizieren, den gefährdeten Umsatz schätzen und die Behebung basierend auf den Geschäftsergebnissen priorisieren.
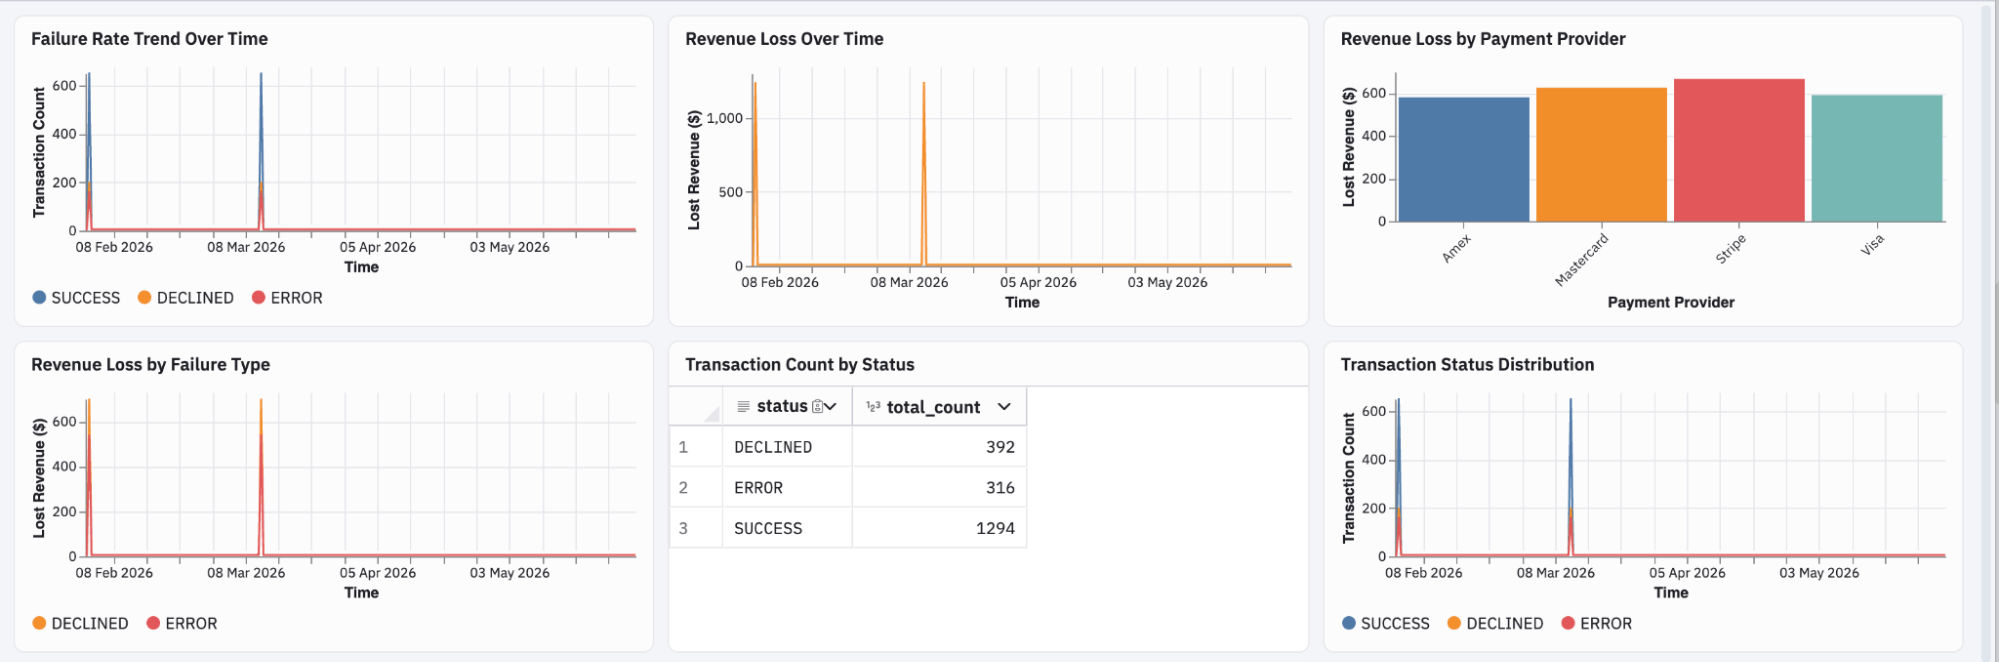
Dies ist die breitere Anwendung von Observability: Dieselben Daten, die Techniker:innen bei der Wiederherstellung der Produktion helfen, können Führungskräften auch dabei helfen, die Auswirkungen auf die Kund:innen zu verstehen, langfristige Zuverlässigkeitstrends zu erkennen, technische Entscheidungen zu verbessern und KI voranzutreiben.
Anstatt nur zu fragen, was fehlgeschlagen ist, können Unternehmen verstehen, was die Auswirkungen sind. Sobald Telemetrie mit dem Geschäftskontext verbunden ist, wird die Vorfallsreaktion zum Ausgangspunkt der Analyse, nicht zum Endpunkt. Die nächste Frage ist, wie Observability-Daten über Analysen, KI und operative Workflows hinweg aufbewahrt, kontrolliert und wiederverwendet werden können.
Warum offene Observability wichtig ist
Während technische Unternehmen ihre Observability-Praktiken weiterentwickeln, entdecken sie, dass Telemetrie weit über das Vorfallsfenster hinaus Wert hat. Protokolle, Metriken und Traces werden zu langlebigen Unternehmenswerten: Daten, die neben Kunden-, Produkt- und Geschäftsdaten aufbewahrt, kontrolliert und angereichert werden sollten.
Hier rückt offene Observability in den Fokus. Der OpenTelemetry-Standard bietet eine konsistente, herstellerneutrale Möglichkeit, Anwendungen zu instrumentieren. Offene Technologien wie Apache Iceberg™ verändern die Art und Weise, wie Unternehmen Unternehmensdaten speichern und verwalten, indem sie Speicher von Compute trennen und Interoperabilität über mehrere Engines hinweg ermöglichen. Erfahren Sie mehr über Observe auf Apache Iceberg (derzeit in der Private Preview).
Zusammen bilden diese Technologien eine Grundlage, auf der Telemetrie nicht ausschließlich innerhalb einer operativen Plattform leben muss. Unternehmen können sie als offenen Datensatz aufbewahren, den sie kontrollieren – einen, der konsistent kontrolliert, zusammen mit Unternehmensdaten analysiert und über Analysen, KI und operative Workflows hinweg verwendet werden kann.
Wie sich Snowflake und Observe ergänzen
Die Frage, die ich am häufigsten von technischen Führungskräften höre, ist, wie ihre Observability-Plattform und ihre Datenplattform zusammenarbeiten sollten. Die Antwort wird klar, wenn wir uns den Lebenszyklus eines Vorfalls genau ansehen.
Ein Missverständnis ist, dass das Einbringen von Telemetrie in Snowflake eine Observability-Plattform ersetzt. Was ich in der Praxis gesehen habe, ist, dass Kund:innen sie im Allgemeinen als ergänzend und nicht als ausschließend betrachten.
Wenn Techniker:innen auf einen Vorfall reagieren, benötigen sie operative Workflows, die Daten und Kontext zusammenbringen, um Probleme schnell zu verstehen und zu lösen. Snowflake bietet die Datengrundlage, während Observe speziell entwickelte Observability-Workflows, AI SRE und den Observability Context Graph hinzufügt, um Protokolle, Metriken, Traces und Infrastrukturbeziehungen zu verbinden – was Teams hilft, von Daten zu umsetzbarem Kontext zu gelangen und den Service schneller wiederherzustellen.
Die Analyse nach einem Vorfall ist eine andere Herausforderung. Teams müssen Telemetrie mit Kunden- und Finanzdaten verbinden, um langfristige Trends zu erkennen. Sobald sich Telemetriedaten in der Snowflake AI Data Cloud befinden, können sie als strategischer Unternehmenswert angereichert und analysiert werden.
Da KI für technische Workflows immer wichtiger wird, ermöglicht die Bereitstellung von Telemetrie neben Unternehmensdaten den Teams, Muster und Anomalien zu erkennen, die in nicht verbundenen Systemen schwer zu finden wären.
Während eines Vorfalls: Speziell entwickelte Observability mit Observe
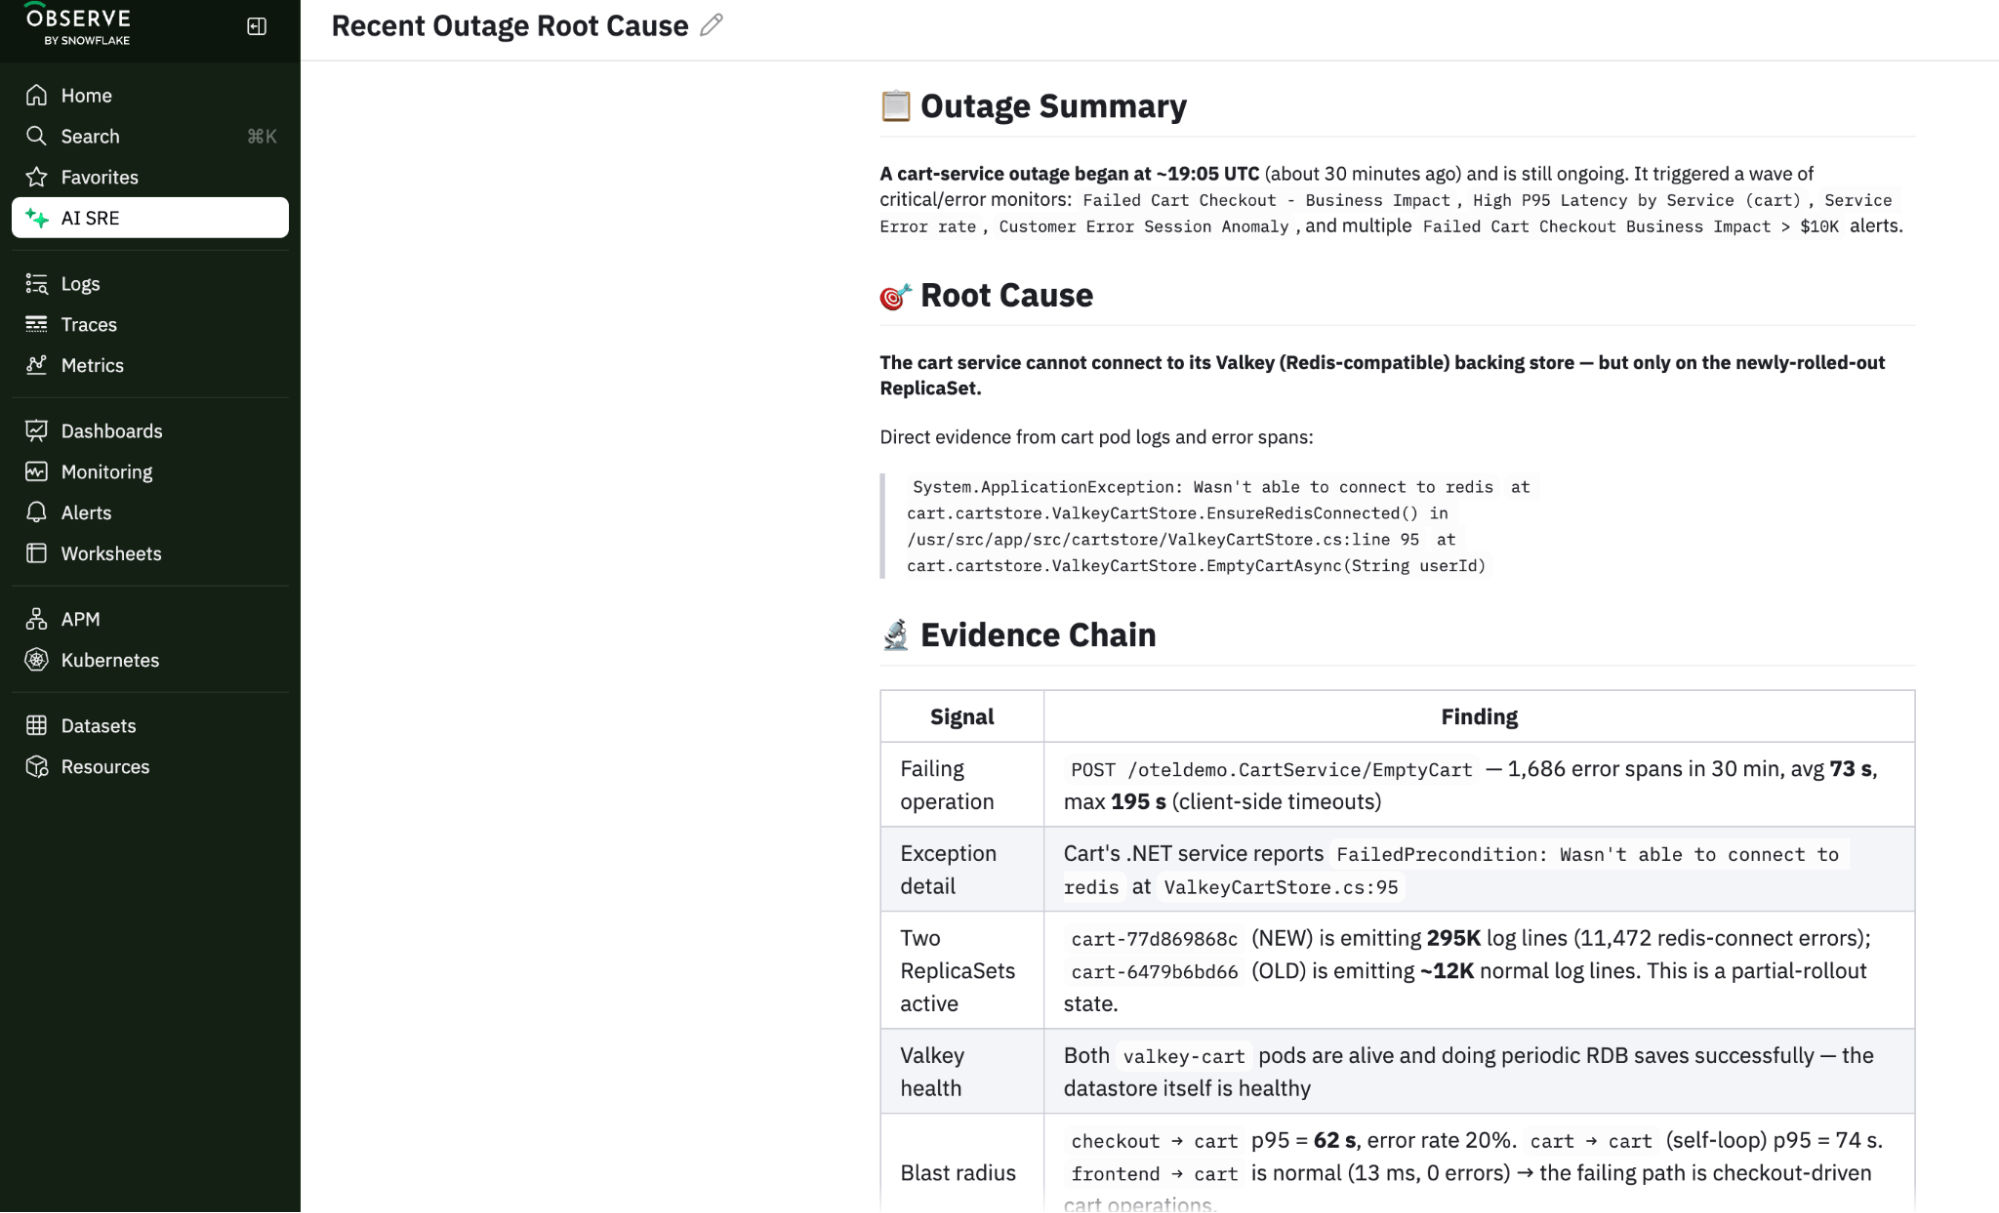
Wenn die Produktion beeinträchtigt ist, benötigen Techniker:innen sofort Antworten. Speziell entwickelte Observability-Plattformen wie Observe sind für diesen operativen Workflow konzipiert. AI SRE hilft Teams, Vorfälle zu untersuchen, Anomalien aufzudecken und Erkenntnisse zusammenzufassen, während der Context Graph Anwendungen, Infrastruktur, Protokolle, Metriken und Traces zu einer einheitlichen Sicht auf das System verbindet.
Zusammen geben diese Funktionen den Techniker:innen den Kontext, den sie benötigen, um zu verstehen, was passiert ist, und den Service so schnell wie möglich wiederherzustellen.
Nach dem Vorfall: Unternehmenskontext durch Snowflake
Sobald der Service wiederhergestellt ist, kann dieselbe Telemetrie mit Kunden-, Transaktions-, Finanz-, Produkt- und Bereitstellungsdaten verbunden werden. Teams können diesen breiteren Kontext nutzen, um die geschäftlichen Auswirkungen zu quantifizieren, wiederkehrende Muster zu erkennen und Zuverlässigkeitsinvestitionen zu priorisieren.
Hier erweitert Snowflake den Wert von Observability. Telemetrie kann zusammen mit dem Rest des Unternehmens aufbewahrt und analysiert werden, was kontrollierte Analysen und KI unterstützt, ohne technische Daten von dem Geschäftskontext zu trennen, der zu ihrer Interpretation erforderlich ist.
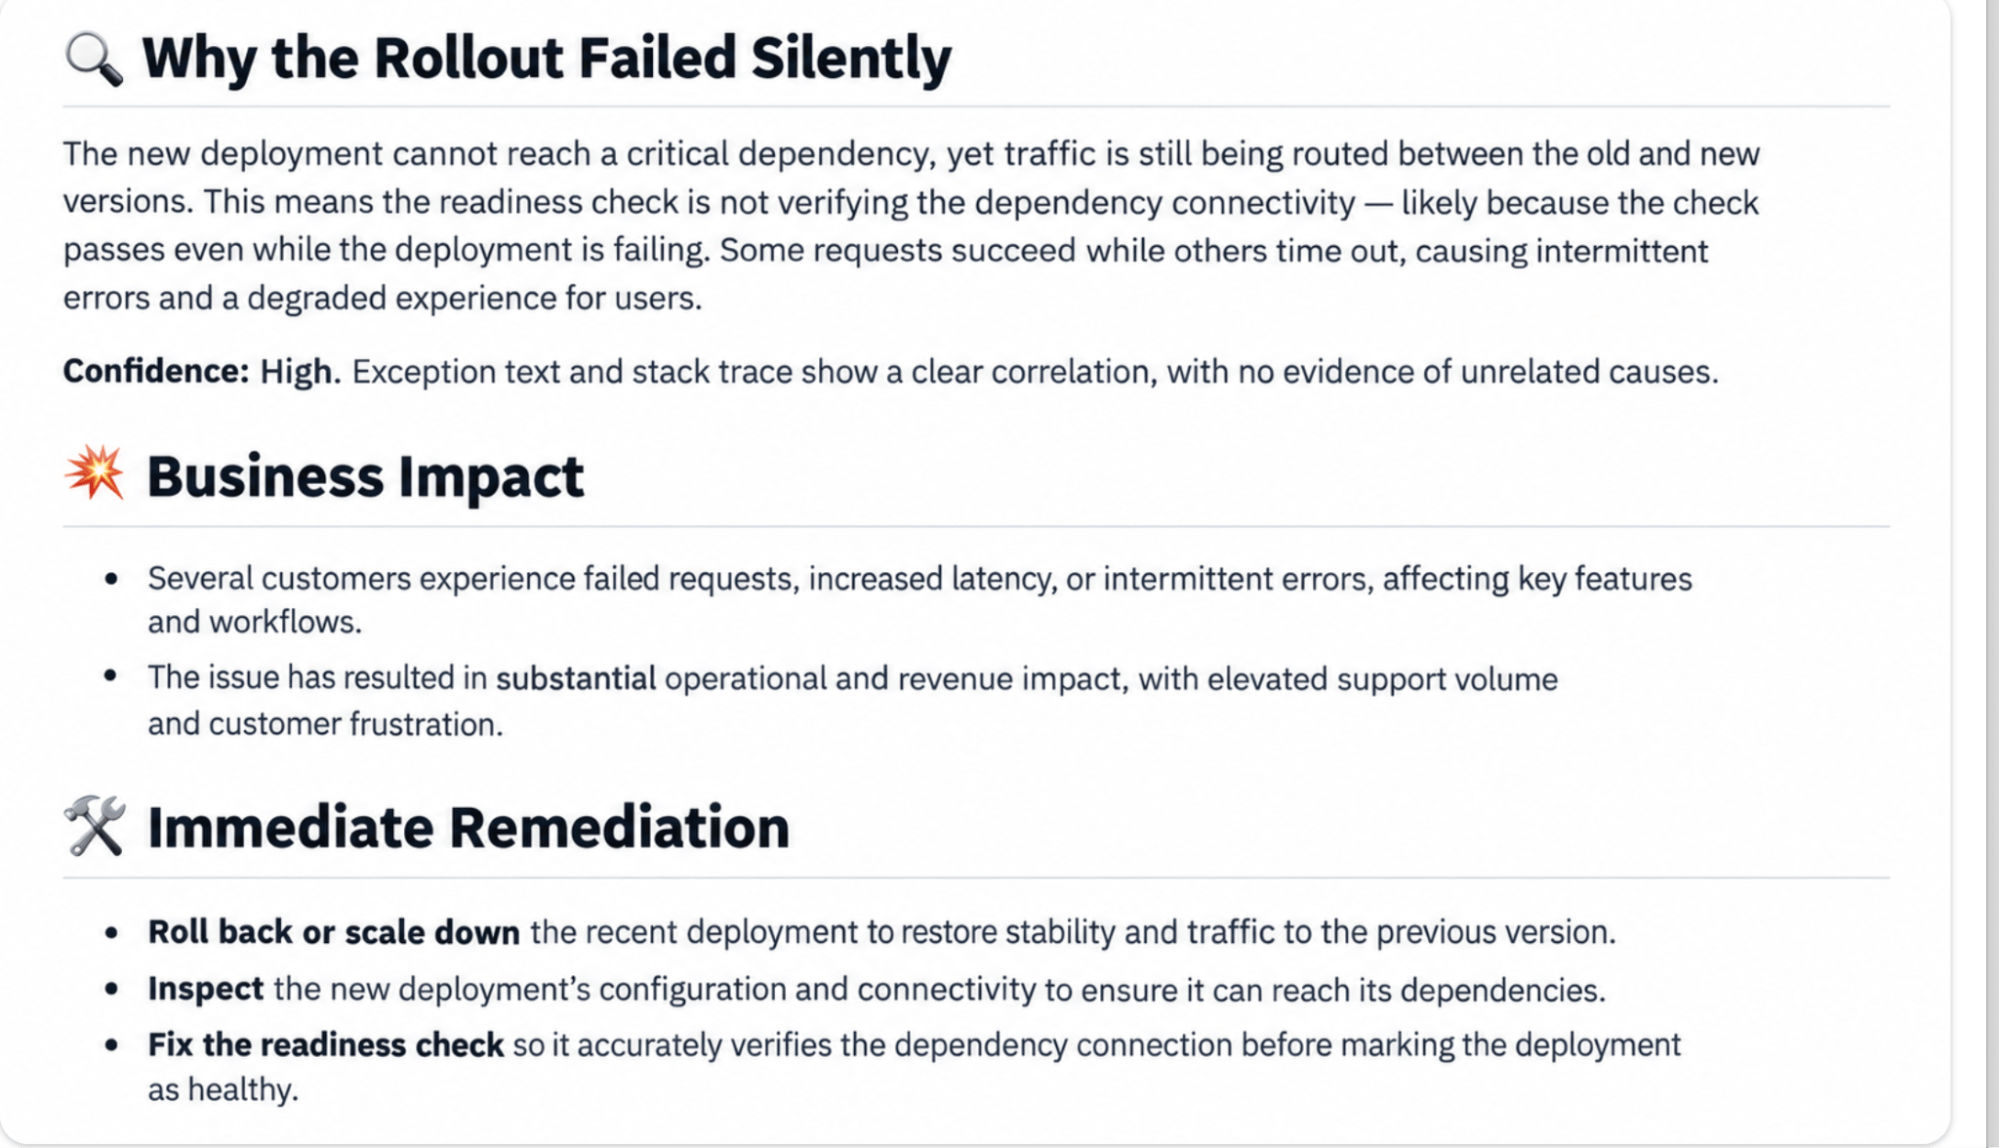
Snowflake und Observe ergänzen sich von Haus aus
Observe bietet operative Intelligenz für die Vorfallsbehebung in Echtzeit. Snowflake erweitert den Wert von Telemetrie als offenes, kontrolliertes Asset für langfristige Analysen und KI. Zusammen sind sie darauf ausgelegt, den gesamten Lebenszyklus von Observability zu unterstützen:
- Signale mit offenen Standards instrumentieren und erfassen
- Vorfälle mit schnellen, kontextbezogenen operativen Workflows untersuchen
- Telemetrie mit Geschäftsdaten verbinden, um die Auswirkungen zu quantifizieren
- Die resultierenden Daten für Analysen, Reliability Engineering und KI aufbewahren und kontrollieren
Das Ziel ist nicht, sich zwischen einer Observability-Plattform und einer Datenplattform zu entscheiden. Es geht darum, die Plattform, die Techniker:innen während eines Vorfalls nutzen, mit den Daten zu verbinden, die das Unternehmen danach nutzt.
Setzen Sie das Gespräch über Observability fort
Telemetriedaten sind nicht mehr nur operative Daten – es sind Unternehmensdaten. Wenn Unternehmen sie als solche behandeln, gehen sie über die Vorfallsreaktion hinaus und können beginnen, kontinuierlich aus ihren Systemen zu lernen.
Wie denkt Ihr Unternehmen über diese Entwicklung? Wie verbinden Sie operative Telemetrie mit dem Rest Ihrer Unternehmensdaten? Und wie könnte ein offenerer, kontrollierter Ansatz Ihren Teams helfen, Zuverlässigkeitssignale in geschäftliche Erkenntnisse zu verwandeln?
Erfahren Sie mehr über Observe by Snowflake oder kontaktieren Sie uns unter snowflake.com/en/product/observe/contact/.
Offenlegungen
Dieser Artikel enthält zukunftsgerichtete Aussagen, unter anderem über künftige Produktangebote. Diese Aussagen stellen keine Garantie dar, dass diese Angebote wirklich bereitgestellt werden. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten. Weitere Informationen finden Sie in unserem jüngsten 10-Q-Formular.