29 sept. 2026/Lecture : 5 minProduit et technologie
OpenTelemetry : du mode pompier à la stratégie data
Dans le cadre de mon travail avec les clients de Snowflake, l’une des évolutions les plus intéressantes que j’ai constatées concerne nos échanges sur l’observabilité.
Il y a quelques années, les responsables ingénierie se concentraient sur l’instrumentation et la visibilité : Comment collecter davantage de télémétrie ? Comment réduire le temps moyen de résolution ? Comment gagner en visibilité sur des systèmes toujours plus complexes ?
Aujourd’hui, OpenTelemetry et les plateformes d’observabilité modernes comme Observe by Snowflake permettent de répondre plus facilement à bon nombre de ces questions. Les échanges sur l’observabilité peuvent désormais commencer par les indicateurs et résultats métier, plutôt que par les journaux, les métriques et les traces. L’objectif n’est plus seulement de comprendre ce qui se passe dans les systèmes distribués, mais de relier les données techniques à leur signification pour l’entreprise.
Cette évolution soulève plusieurs questions concrètes pour les équipes d’ingénierie :
- Combien de temps devons-nous conserver la télémétrie ?
- Comment relier les données opérationnelles aux données clients et métier ?
- Comment la télémétrie peut-elle servir l’analytique et l’IA ?
- Comment garantir que les données d’observabilité restent ouvertes et sous notre contrôle ?
Ces questions sont loin d’être théoriques. Elles se posent dès que l’impact technique d’un incident soulève des enjeux d’attrition client, de chiffre d’affaires et d’impact métier.
L’observabilité ne s’arrête pas avec l’incident
Prenons l’exemple fictif d’une grande entreprise de services financiers comptant plusieurs millions de clients. Comme dans de nombreuses entreprises numériques, quelques minutes de baisse des performances peuvent suffire à dégrader l’expérience client, à multiplier les demandes d’assistance et à menacer le chiffre d’affaires.
Lors d’un incident en production, l’équipe d’ingénierie a constaté une latence élevée sur un service de paiement destiné aux clients. Au départ, l’origine du problème était difficile à déterminer : l’application, une dépendance en amont ou l’infrastructure sous-jacente. L’équipe ne pouvait pas déterminer immédiatement quels clients ou quelles transactions étaient affectés.
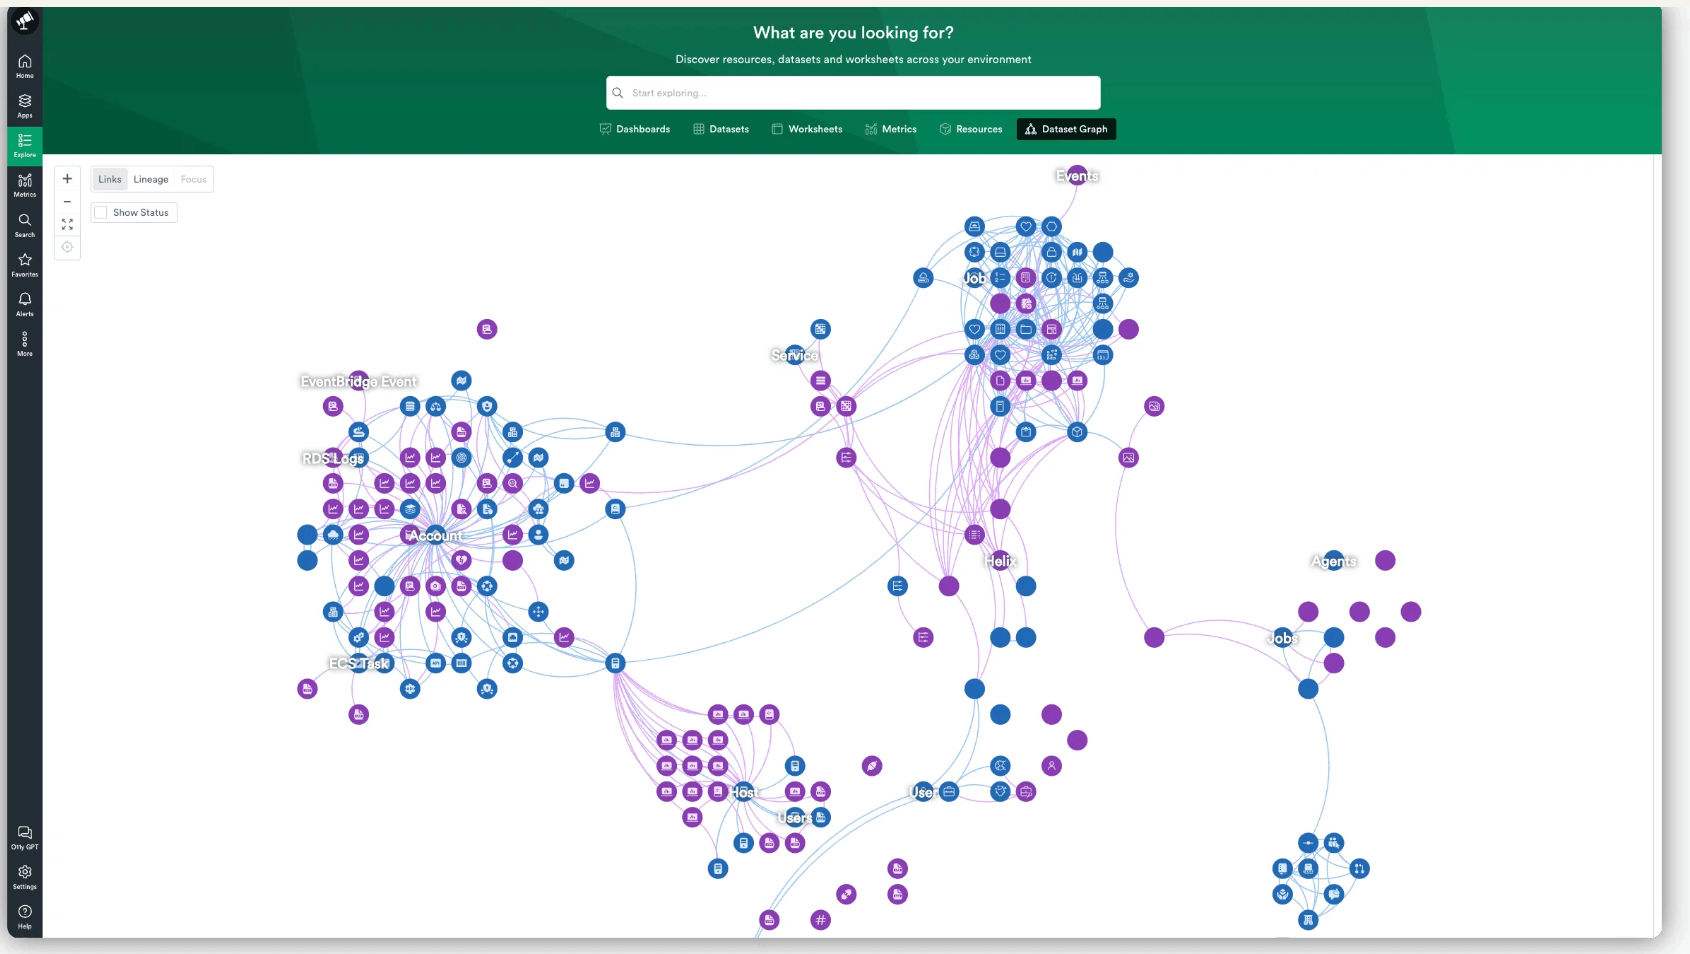
En s’appuyant sur l’Observability Context Graph d’Observe et sur le Site Reliability Engineering assisté par IA (SRE IA), l’équipe a unifié des Streams de télémétrie disparates pour isoler le composant défaillant, cartographier ses répercussions à travers des dépendances complexes et rétablir le bon fonctionnement de l’environnement.
Sur le plan opérationnel, l’incident était clos. Mais sur le plan stratégique, il ne faisait que commencer.
L’équipe d’ingénierie avait répondu à la question « Qu’est-ce qui est tombé en panne ? » L’équipe de direction a toutefois immédiatement posé d’autres questions :
- Quel a été l’impact sur les clients ?
- Quel montant de chiffre d’affaires était menacé ?
- Certains prestataires de paiement ont-ils été plus touchés que d’autres ?
S’agit-il d’un incident isolé ou du début d’une tendance plus générale en matière de fiabilité ?
Pour obtenir ces réponses, il fallait combiner la télémétrie opérationnelle avec les comptes clients, les transactions de paiement, l’historique des déploiements et l’utilisation des produits. À ce stade, l’observabilité n’était plus seulement un enjeu opérationnel : elle devenait un enjeu de données.
De la cause première à l’impact métier
En enrichissant la télémétrie opérationnelle avec des données contextuelles sur les clients, les produits et les finances, les responsables métier et de l’ingénierie de l’organisation financière ont obtenu une vision commune de l’impact de l’incident. Au-delà de l’analyse des causes premières, l’équipe pouvait ainsi quantifier l’impact sur les clients, estimer le chiffre d’affaires menacé et hiérarchiser les mesures correctives selon les résultats métier.
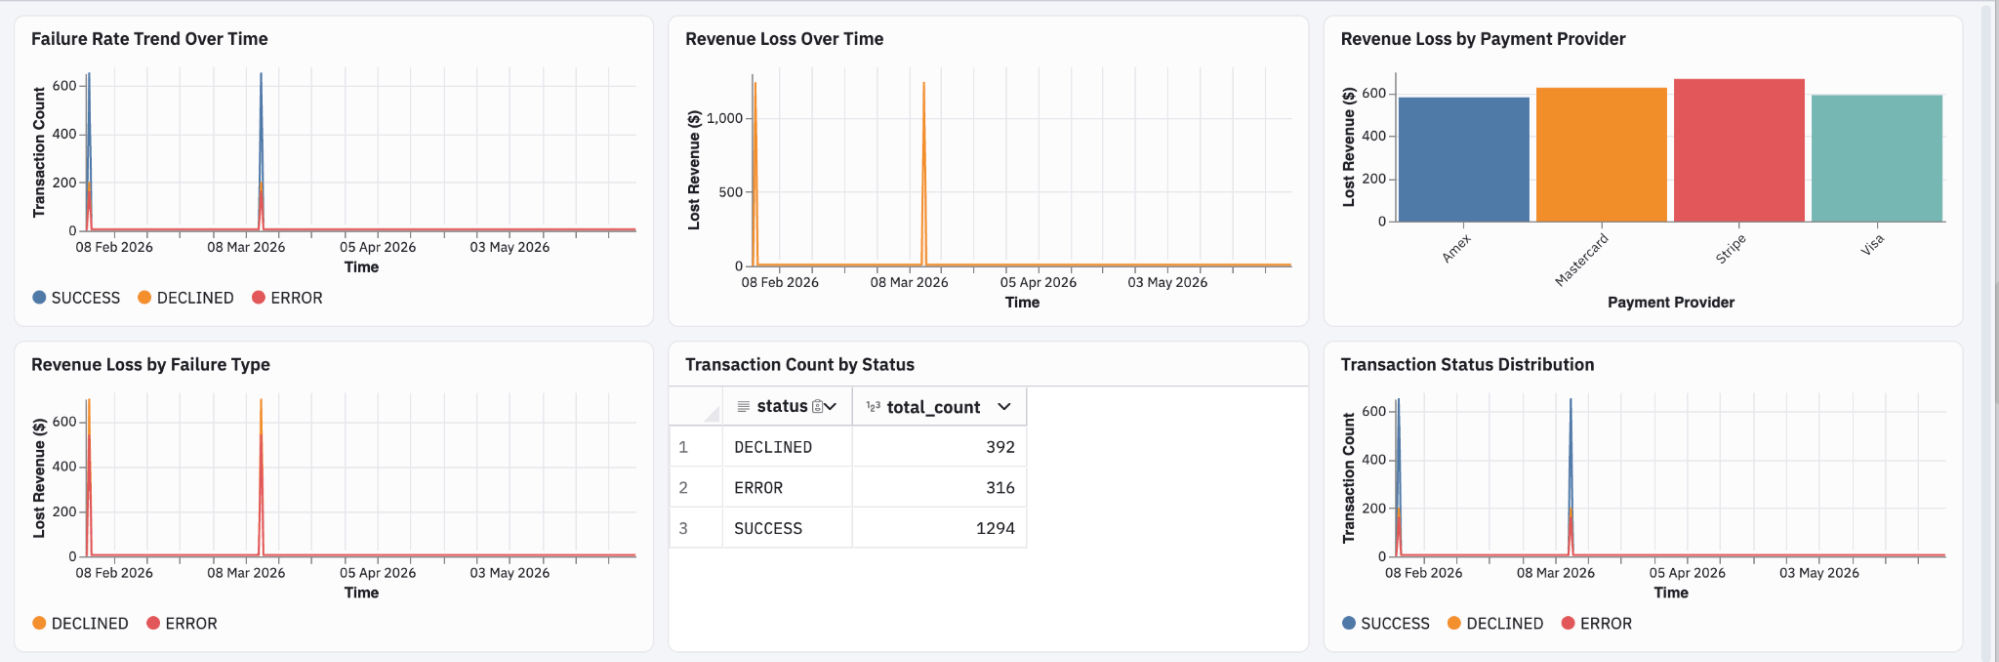
Voilà toute la portée de l’observabilité : Les données qui aident les équipes d’ingénierie à rétablir la production permettent également aux responsables de comprendre l’impact sur les clients, de dégager des tendances de fiabilité à long terme, d’améliorer les décisions d’ingénierie et d’alimenter l’IA.
Au lieu de simplement chercher la cause de la panne, les organisations peuvent aussi en mesurer l’impact. Une fois la télémétrie reliée au contexte métier, la réponse aux incidents devient le point de départ de l’analyse, et non son aboutissement. Il reste alors à déterminer comment conserver, gouverner et réutiliser les données d’observabilité dans les workflows analytiques, d’IA et opérationnels.
Pourquoi l’observabilité ouverte est essentielle
À mesure que leurs pratiques d’observabilité gagnent en maturité, les organisations d’ingénierie découvrent que la valeur de la télémétrie dépasse largement la durée d’un incident. Journaux, métriques et traces deviennent des actifs d’entreprise durables : des données à conserver, gouverner et enrichir aux côtés des données clients, produit et métier.
C’est là que l’observabilité ouverte prend tout son sens. Le standard OpenTelemetry offre une méthode cohérente et indépendante des fournisseurs pour instrumenter les applications. Les technologies ouvertes comme Apache Iceberg™ transforment la manière dont les organisations stockent et gèrent leurs données d’entreprise, en dissociant le stockage du calcul et en favorisant l’interopérabilité entre plusieurs moteurs. En savoir plus sur Observe sur Apache Iceberg (actuellement en private preview).
Ensemble, ces technologies créent un socle qui évite de confiner la télémétrie à une plateforme opérationnelle. Les organisations peuvent la conserver sous la forme d’un jeu de données ouvert qu’elles contrôlent, gouverner ces données de manière cohérente, les analyser avec leurs autres données d’entreprise et les exploiter dans leurs workflows analytiques, d’IA et opérationnels.
Comment Snowflake et Observe se complètent
La question que les responsables ingénierie me posent le plus souvent est la suivante : comment leur plateforme d’observabilité et leur plateforme de données doivent-elles fonctionner ensemble ? La réponse devient évidente lorsque l’on examine de près le cycle de vie d’un incident.
Une idée reçue consiste à penser que l’intégration de la télémétrie dans Snowflake remplace une plateforme d’observabilité. Sur le terrain, je constate au contraire que les clients considèrent généralement ces plateformes comme complémentaires, et non mutuellement exclusives.
Pour répondre à un incident, les équipes d’ingénierie ont besoin de workflows opérationnels qui réunissent les données et leur contexte afin de comprendre et de résoudre rapidement les problèmes. Snowflake fournit le socle de données, tandis qu’Observe y ajoute des workflows conçus pour l’observabilité, le SRE IA et l’Observability Context Graph afin de relier journaux, métriques, traces et dépendances d’infrastructure. Les équipes peuvent ainsi transformer les données en contexte exploitable et rétablir plus rapidement le service.
L’analyse post-incident relève d’une autre problématique. Les équipes doivent relier la télémétrie aux données clients et financières pour dégager des tendances à long terme. Une fois intégrées à l’AI Data Cloud de Snowflake, les données de télémétrie peuvent être enrichies et analysées comme un actif stratégique de l’entreprise.
À mesure que l’IA s’impose au cœur des workflows d’ingénierie, le rapprochement de la télémétrie et des données d’entreprise permet aux équipes de détecter des schémas et des anomalies difficiles à repérer dans des systèmes cloisonnés.
Pendant un incident : une observabilité conçue pour l’action avec Observe
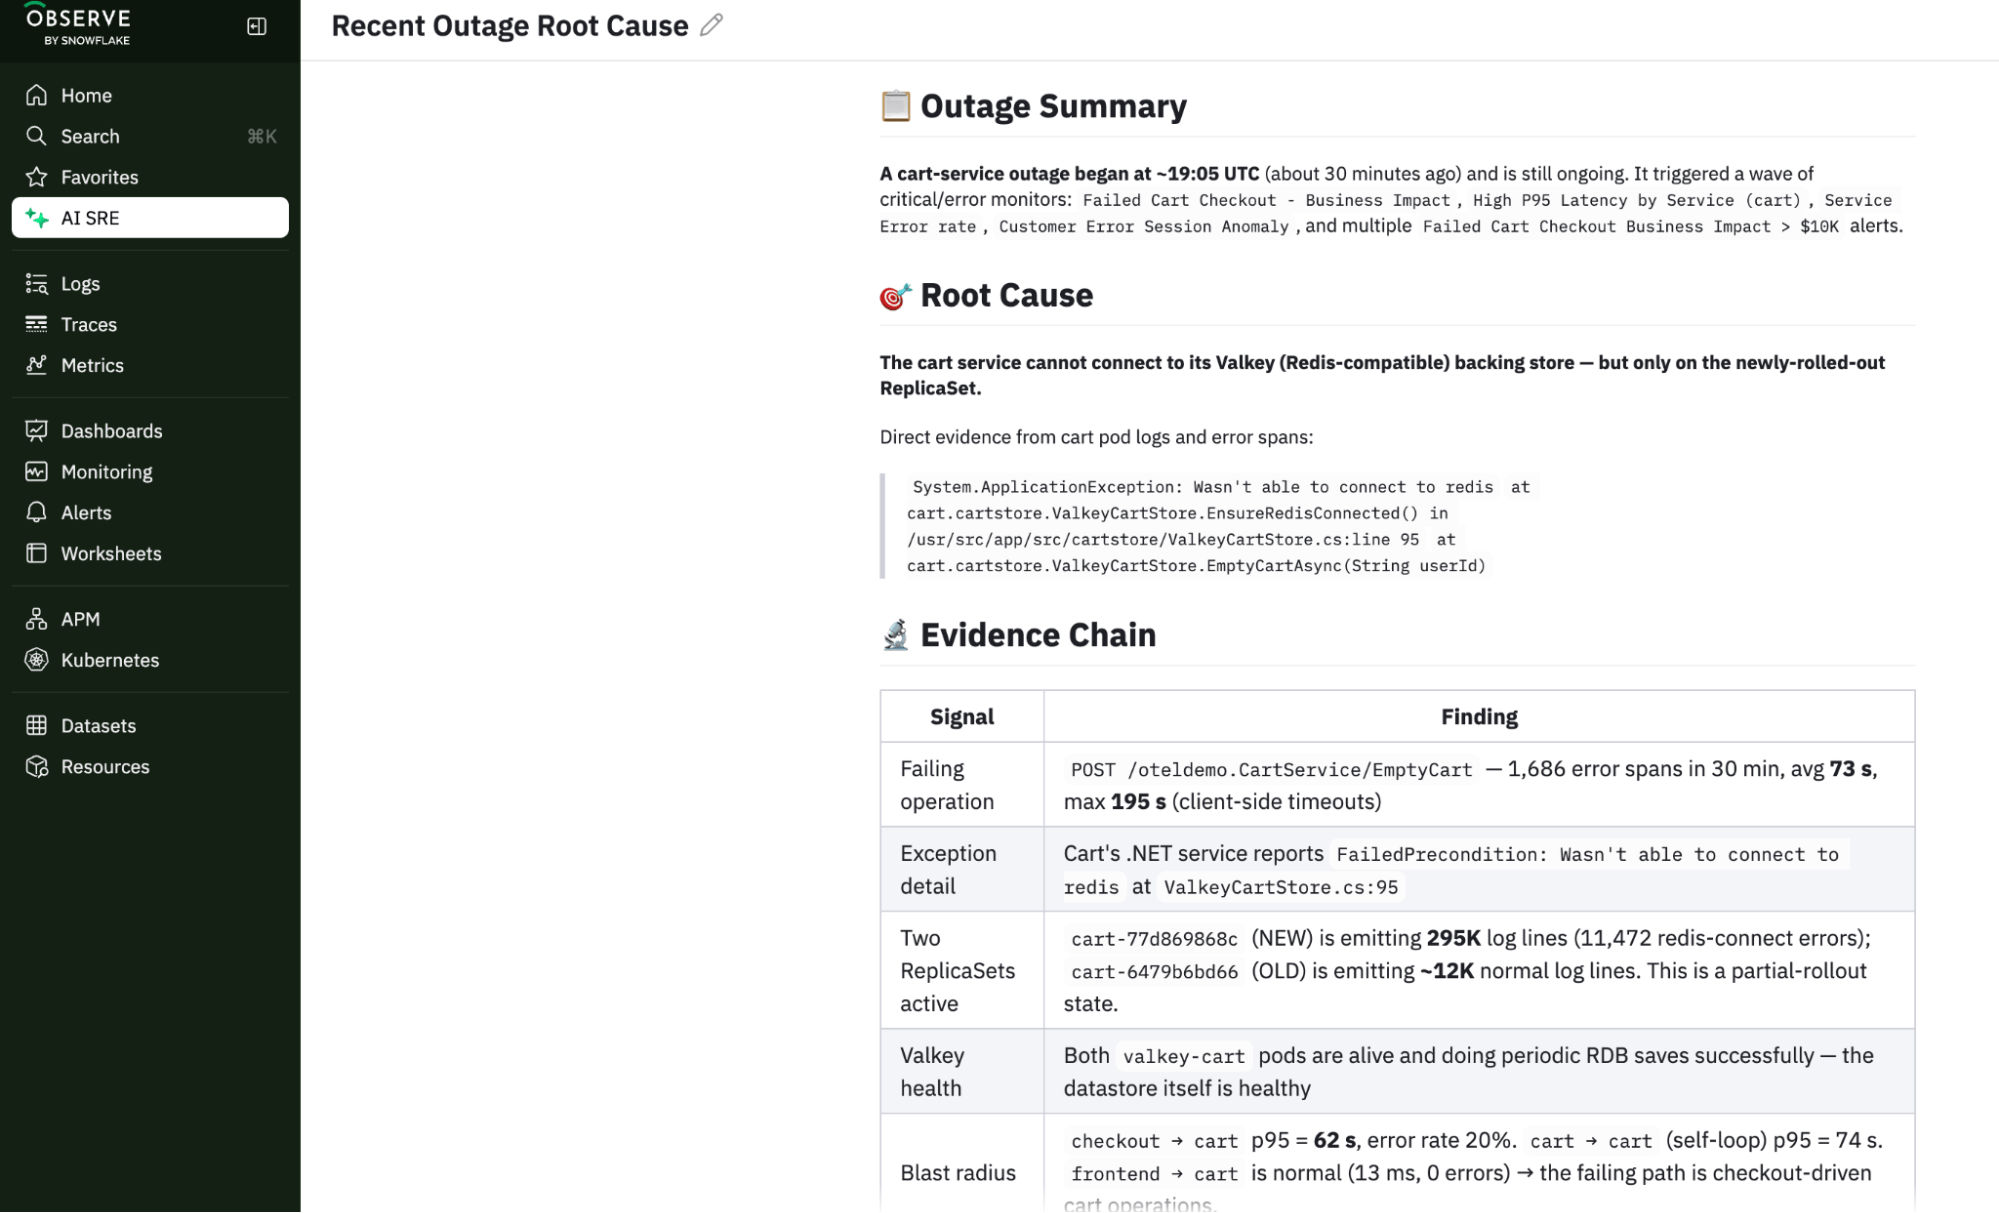
Lorsque la production est dégradée, les équipes d’ingénierie ont besoin de réponses immédiates. Les plateformes spécialisées dans l’observabilité, comme Observe, sont conçues pour répondre à ce workflow opérationnel. Le SRE IA aide les équipes à analyser les incidents, à détecter les anomalies et à synthétiser les enseignements, tandis que le graphe contextuel relie les applications, l’infrastructure, les journaux, les métriques et les traces dans une vue unifiée du système.
Ensemble, ces fonctionnalités apportent aux équipes d’ingénierie le contexte nécessaire pour comprendre ce qui s’est passé et rétablir le service aussi rapidement que possible.
Après l’incident : le contexte d’entreprise grâce à Snowflake
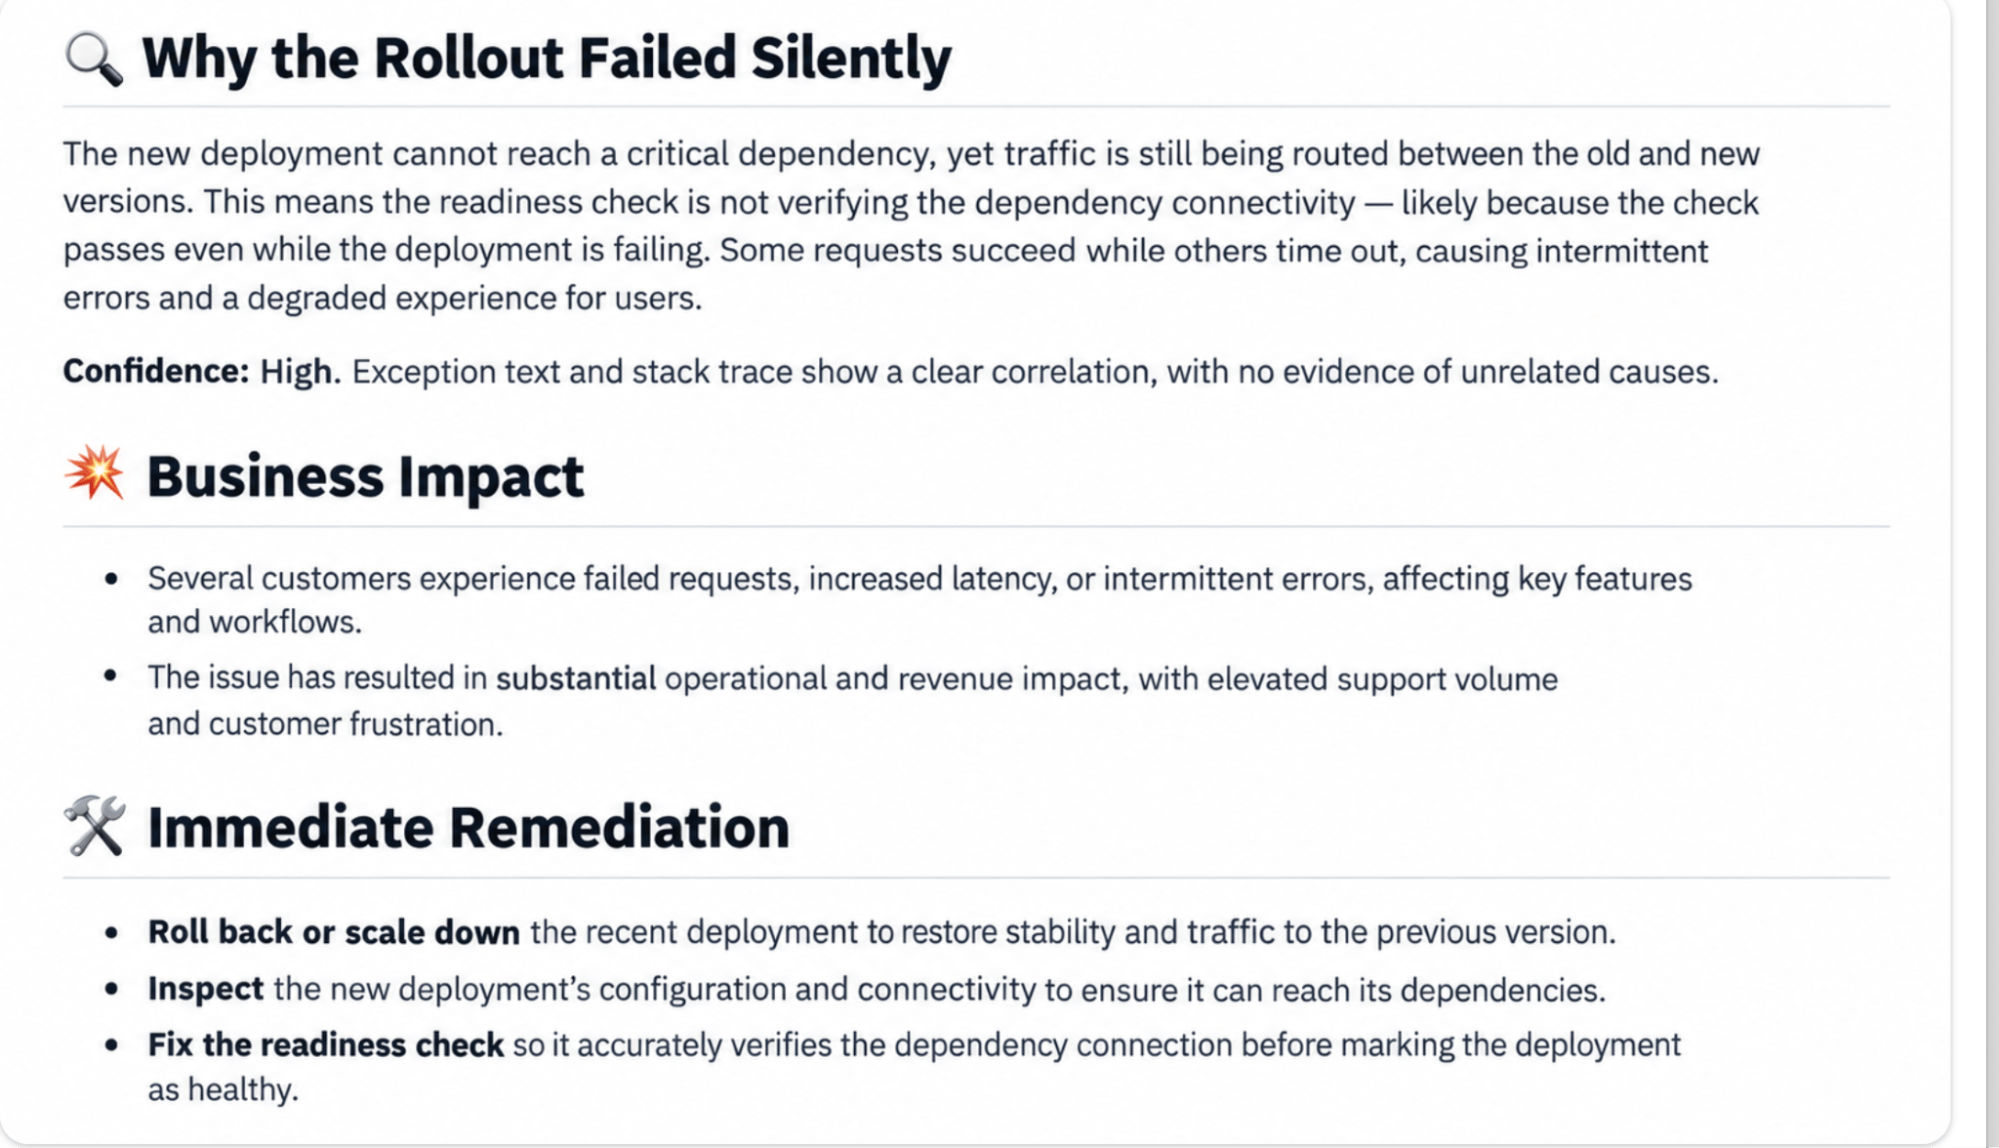
Une fois le service rétabli, cette même télémétrie peut être reliée aux données clients, transactionnelles, financières, produit et de déploiement. Les équipes peuvent exploiter ce contexte élargi pour quantifier l’impact métier, identifier les schémas récurrents et hiérarchiser les investissements consacrés à la fiabilité.
C’est ainsi que Snowflake prolonge la valeur de l’observabilité. La télémétrie peut être conservée et analysée avec les autres données de l’entreprise afin d’alimenter une analytique et une IA gouvernées, sans dissocier les données techniques du contexte métier nécessaire à leur interprétation.
Snowflake et Observe, complémentaires par nature
Observe fournit l’intelligence opérationnelle nécessaire pour résoudre les incidents en temps réel. Snowflake prolonge la valeur de la télémétrie en la transformant en un actif ouvert et gouverné au service de l’analyse à long terme et de l’IA. Ensemble, ces solutions couvrent l’ensemble du cycle de vie de l’observabilité :
- Instrumenter les systèmes et collecter les signaux à l’aide de standards ouverts
- Analyser les incidents grâce à des workflows opérationnels rapides et contextualisés
- Relier la télémétrie aux données métier afin de quantifier l’impact
- Conserver et gouverner les données obtenues pour l’analytique, l’ingénierie de la fiabilité et l’IA
L’objectif n’est pas de choisir entre une plateforme d’observabilité et une plateforme de données. Il s’agit de relier la plateforme utilisée par les équipes d’ingénierie pendant un incident aux données que l’entreprise exploite après celui-ci.
Poursuivons la conversation sur l’observabilité
La télémétrie n’est plus une simple donnée opérationnelle : c’est une donnée d’entreprise. En la considérant comme telle, les organisations dépassent la réponse aux incidents et peuvent tirer en continu des enseignements de leurs systèmes.
Comment votre organisation aborde-t-elle cette évolution ? Comment reliez-vous la télémétrie opérationnelle au reste de vos données d’entreprise ? Et comment une approche plus ouverte et mieux gouvernée pourrait-elle aider vos équipes à transformer les signaux de fiabilité en informations métier exploitables ?
En savoir plus sur Observe by Snowflake ou contactez-nous à l’adresse snowflake.com/en/product/observe/contact/.
Mentions légales
Cet article contient des déclarations prévisionnelles, notamment de futures offres de produits. Il ne constitue en aucun cas un engagement à fournir des offres de produits. Les offres et résultats réels peuvent varier et faire l’objet de risques connus et inconnus, ainsi que d’incertitudes. Découvrez notre dernier 10‑Q pour en savoir plus.