30. Juli 2026/Lesezeit: 6 MinutenProdukt & Technologie
Erschließung offener Observability mit Observe auf Apache Iceberg
Wir freuen uns, ankündigen zu können, dass Observe auf Apache Iceberg™ jetzt in Private Preview verfügbar ist. Ihre Observability-Daten können nun als Apache Iceberg Tables in Ihrem eigenen Amazon S3-Bucket gespeichert werden, wobei die volle Observe-Erfahrung darauf aufbaut. Dies ist Teil des umfassenderen Engagements von Observe by Snowflake für offene Standards in der Observability. Zusätzlich zur Nutzung der OpenTelemetry-nativen Ingestion liegen Ihre Daten nun in einem Format vor, das jede Iceberg-kompatible Engine lesen kann, und zwar in einem Speicher, den Sie besitzen und kontrollieren.
Das Volumen an Protokollen, Metriken und Traces, das von modernen Systemen generiert wird, ist dramatisch gewachsen. Führende Unternehmen nehmen heute täglich riesige Datenmengen auf. Doch traditionell befanden sich diese Daten fast immer in einem Datensilo – kodiert in anbieterspezifischen Formaten, abfragbar nur über die Schnittstelle des Anbieters und unzugänglich für den Rest des Unternehmens. Engineering-Teams führen die Fehlerbehebung in einem Tool durch, während Business- und Datenteams in einem anderen arbeiten, und die Verknüpfung von Telemetriesignalen mit Geschäftsdaten erfordert ETL, manuelle Exporte oder eine benutzerdefinierte Pipeline. Wenn Ihre Anforderungen über die Plattform des Anbieters hinauswachsen oder wenn Sie Analytics auf Basis Ihrer Telemetriedaten ausführen möchten, ist es oft schwieriger als es sein sollte, diese Daten herauszuholen.
Diese Probleme sind eine Folge der Architektur traditioneller Observability-Plattformen: Sie wurden entwickelt, um die Schnittstelle eines einzigen Anbieters zu bedienen, ohne die Erwartung, dass die Daten jemals irgendwo anders gespeichert werden müssten. Offene Tabellenformate wie Apache Iceberg ändern das. Wenn Ihre Telemetriedaten in Iceberg gespeichert sind, befinden sie sich neben dem Rest Ihrer Daten, unter Ihrer Kontrolle und zugänglich über die Tools, die Ihre Teams bereits verwenden. Dies minimiert die Notwendigkeit, Daten in ein separates System zu extrahieren oder zu replizieren – und die damit verbundenen Kosten dieses Prozesses.
Ihre Daten, in Ihrem Objektspeicher, in einem offenen Format
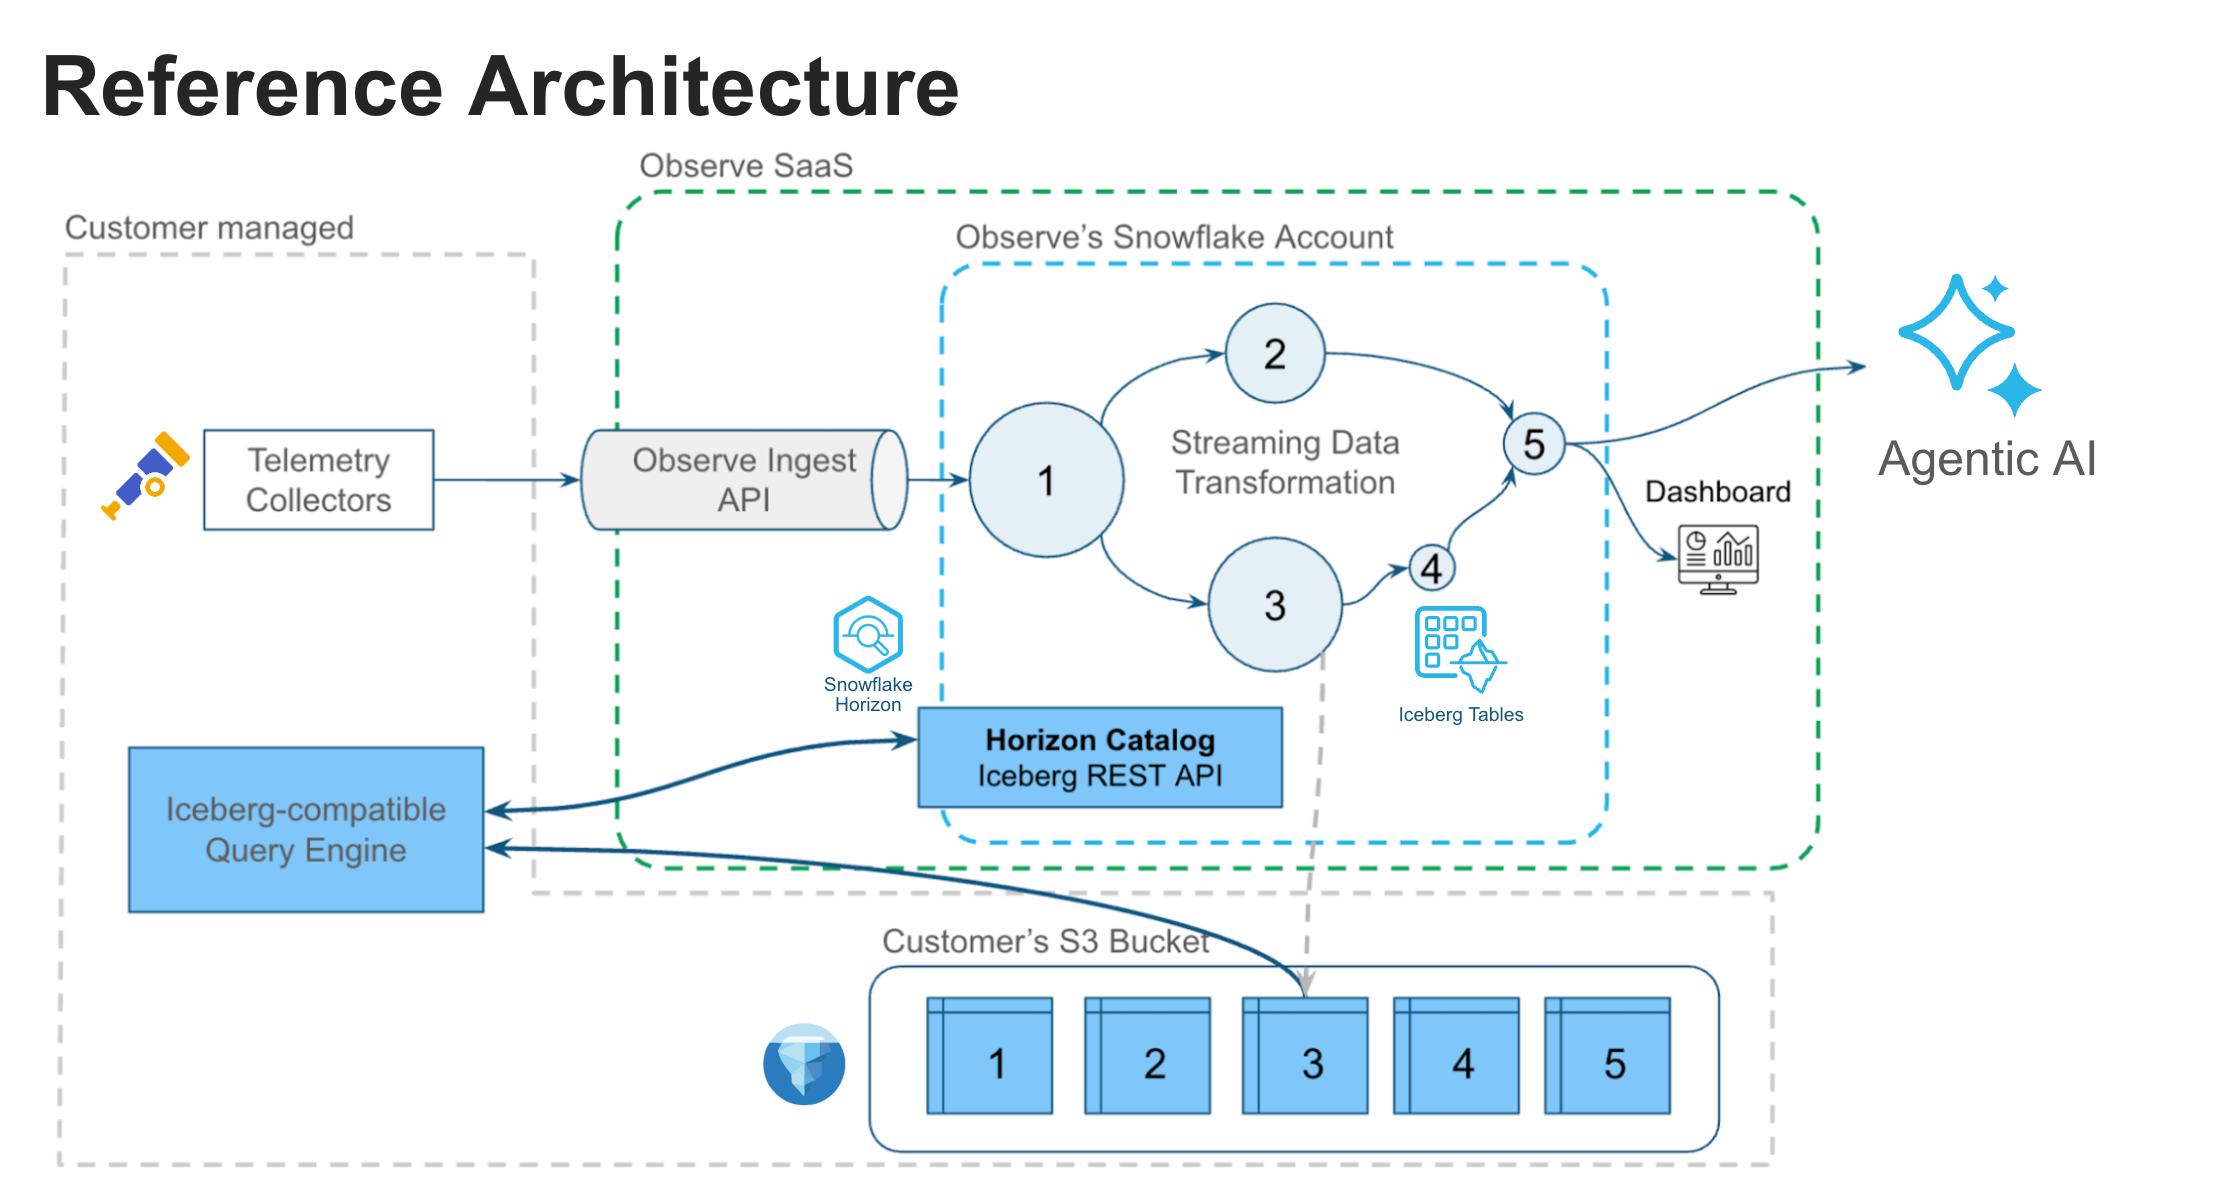
Mit Observe auf Iceberg werden Ihre Telemetriedaten als Iceberg Tables direkt in einen Amazon S3-Bucket in Ihrem AWS-Konto geschrieben. Observe greift auf diesen Bucket über eine IAM-Rolle zu, die Sie erstellen und kontrollieren. Wenn Sie diese Rolle widerrufen oder die Data Lake-Konfiguration entfernen, verliert Observe den Zugriff. Die Daten bleiben in Ihrem Bucket in einem offenen Format und gehören Ihnen. Sie können mehrere Data Lakes konfigurieren, und Datensätze über diese hinweg sind so konzipiert, dass sie isoliert bleiben.
Observe auf Iceberg basiert auf Snowflake-Managed Iceberg Tables unter Verwendung der v3-Tabellenspezifikation. Da diese Tabellen verwaltet werden, erfolgen Komprimierung, Dateigrößenanpassung sowie Snapshot- und Metadaten-Pflege automatisch – als Ergebnis erhalten Sie High-Performance-Abfragen, ohne die Tabellen selbst warten zu müssen. Die v3-Spezifikation bringt auch neue Tabellenfunktionen mit sich, einschließlich umfangreicherer Datentypen und Performance-Verbesserungen.
In der Private Preview können Sie:
Daten über die Observe-Pipeline in Iceberg aufnehmen, ohne einen separaten Export- oder ETL-Schritt: Ihr bestehendes Ingestion-Setup bleibt unverändert. Daten fließen durch die Observe-Ingestion-Pipeline und werden in Standard-Iceberg Tables in Ihrem eigenen S3-Bucket geschrieben.
Observability-Daten in einem offenen Format auf Ihrem eigenen Objektspeicher speichern: Datensätze werden als Standard-Iceberg Tables in Ihrem S3-Bucket geschrieben, unter Ihrer Governance, Ihren Aufbewahrungsrichtlinien und Zugriffskontrollen. Wenn Sie den Zugriff von Observe entfernen, bleiben die Daten in Ihrem Besitz.
Monitore, Dashboards und Korrelationen auf Basis Ihrer Daten innerhalb von Observe erstellen: Die volle Observe-Erfahrung – Monitoring, Dashboards, OPAL-Transformationen, KI-SRE und Korrelationen – ist so konzipiert, dass sie identisch auf Iceberg-gestützten Datensätzen funktioniert. Es ändert sich nichts daran, wie Sie Observe im Alltag nutzen.
Warum Iceberg das richtige Format für Observability-Daten ist
Observability-Daten eignen sich gut für spaltenbasierte Speicherung, und Iceberg speichert Daten standardmäßig in Parquet. Zeitstempel, Dienstnamen, Schweregrade und strukturierte Attribute wiederholen sich über Millionen von Ereignissen in Mustern, die sich effizient komprimieren und mit Partition Pruning gut scannen lassen.
Aber Iceberg ist mehr als nur Parquet. Parquet bietet spaltenbasierte Dateien, die einfach abzufragen sind, wenn Sie bereits wissen, wo sie sich befinden. Iceberg fügt die Tabellenschicht obenauf hinzu und bietet Schema-Evolution, Partitionierung, Snapshots und einen Katalog, den jede kompatible Engine ohne benutzerdefinierte Integration entdecken und lesen kann. Das macht Ihre Telemetriedaten offen und zugänglich, anstatt sie nur in einem effizienten Format zu speichern.
In unseren Tests laufen Observability-Workflows auf Iceberg Tables mit ähnlicher Performance wie auf Observe-nativen Daten, sodass Sie sich nicht zwischen Offenheit und Performance entscheiden müssen. Engineering-Teams können Observe weiterhin für die Untersuchung von Vorfällen, Dashboards, Monitore und KI-gestützte Ursachenanalysen verwenden, während der Rest Ihres Unternehmens direkten Zugriff auf dieselben Daten in den Tools erhält, die sie bereits nutzen.
Abfrage mit jeder Engine
Sobald sich Ihre Daten in Iceberg Tables befinden, sind sie nicht nur über Observe lesbar. Observe stellt einen schreibgeschützten Iceberg REST-Katalog über die Observe-API bereit, sodass jede Iceberg-kompatible Abfrage-Engine Ihre Tabellen direkt entdecken und lesen kann. Diese Interoperabilität wird durch den Snowflake Horizon-Katalog unterstützt. Apache Spark™, DuckDB, Trino und PyIceberg funktionieren alle heute schon. Externe Engines lesen Datendateien direkt aus Ihrem S3-Bucket, und der Datenpfad verläuft überhaupt nicht über Observe.
Dies eröffnet Workflows, die proprietäre Observability-Speicher in der Vergangenheit erschwert haben. In frühen Gesprächen mit Kunden sehen wir bereits Anwendungsfälle, die es Kunden ermöglichen:
Telemetriedaten mit internen Geschäftsdaten zu verknüpfen: Observability-Daten zusammen mit Umsatz-, Kunden- oder Produktdaten in einer einzigen Analyse abzufragen – ohne eine Pipeline zur Synchronisierung der beiden aufzubauen.
Regelmäßige Batch-Data Engineering-Jobs auszuführen: Transformationen oder Aggregationen auf historischen Telemetriedaten mit den Tools zu planen, die Ihr Datenteam bereits betreibt.
Observability-Daten für Compliance-Zwecke zu auditieren: Rohe Telemetriedaten direkt aus Ihrem eigenen Speicher mit Ihren eigenen Anmeldeinformationen abzufragen, ohne sie durch ein Drittanbietersystem zu leiten.
ML-Modelle mit operativen Daten zu trainieren: Einen Spark- oder PyIceberg-Job auf Ihre Telemetriehistorie zu richten, ohne dass ein separater Datenvorbereitungsschritt exportiert, kopiert oder ausgeführt werden muss.
Wenn Telemetriedaten im selben Data Lake wie Ihre Geschäftsdaten liegen, beginnt sich die Grenze zwischen Ihren operativen Daten und Ihren analytischen Daten aufzulösen. Die Korrelation eines Vorfalls mit Kundenauswirkungen, Umsatzmetriken oder einem kürzlichen Deployment wird zu einer einfachen Abfrage. Teams aus den Bereichen Engineering, Daten und Produkt können mit derselben Source of Truth arbeiten, ohne dass jemand eine Pipeline besitzen muss, die Daten zwischen Systemen kopiert.
Kosten in großem Maßstab senken und kontrollieren
Die Speicherung großer Mengen an Telemetriedaten in einem proprietären Observability-System ist in der Regel teuer, und die Kosten steigen mit zunehmendem Datenvolumen. Mit Iceberg liegen Ihre Daten auf Ihrem eigenen Objektspeicher und nicht in einem vom Anbieter verwalteten System mit eigenem Preismodell.
Da Iceberg die Speicherung von der Rechenressource entkoppelt, zahlen Sie nur für die Abfragen, die Sie ausführen. Das bedeutet, dass Sie monatelange Telemetriedaten zu einem Bruchteil der Kosten herkömmlicher proprietärer Observability-Plattformen aufbewahren können, ohne Tiering, Rehydrierung oder Kompromisse bei der Aufbewahrung eingehen zu müssen.¹
Und da dieselben Daten mehreren Teams dienen – Engineering-Teams für die Untersuchung von Vorfällen, Datenteams für Analytics, ML Engineers für das Modelltraining –, können Sie die Kosten für die Replikation oder das Verschieben von Daten zwischen Systemen eliminieren. Speichern Sie die Daten einmal und lesen Sie teamübergreifend aus derselben Quelle.
Starten Sie noch heute
Observe auf Iceberg ist jetzt in Private Preview verfügbar, eine breitere Verfügbarkeit folgt in Kürze. Wenn Sie einen offenen, portablen Speicher für Ihre Observability-Daten benötigen, möchten wir von Ihnen hören. Wir laden Sie ein:
Lesen Sie die Dokumentation zu Observe auf Iceberg
Wenden Sie sich an Ihr Observe-Account-Team, um Zugriff zu erhalten
Mehr über Observe erfahren
Egal, ob Sie nach langfristiger Aufbewahrung, Interoperabilität mit einem bestehenden Data Lake oder der Möglichkeit suchen, Ihre eigenen Analytics auf Telemetriedaten auszuführen, wir freuen uns darauf, zu hören, wie Observe auf Iceberg für Ihr Team funktioniert.
¹Die tatsächlichen Einsparungen bei den Speicherkosten können je nach Datenvolumen, Cloud-Anbieter, Region und bestehenden Anbieterverträgen variieren.
Dieser Artikel enthält zukunftsgerichtete Aussagen, unter anderem über künftige Produktangebote. Diese Aussagen stellen keine Garantie dar, dass diese Angebote wirklich bereitgestellt werden. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten.
Apache®, Apache Iceberg, Apache Spark und verwandte Marken sind entweder eingetragene Marken oder Marken der Apache Software Foundation in den Vereinigten Staaten und/oder anderen Ländern.