23 ottobre 2026/Lettura: 12 minAI e ML
Oltre l’adozione: come misurare se l’AI sta cambiando il lavoro che conta

Pensa a due organizzazioni che registrano entrambe 1.000 interazioni con l’AI in una settimana. Nella prima, la maggior parte di quelle interazioni consiste in spiegazioni e ricerche di informazioni. Nella seconda, le persone creano pipeline di dati, analizzano anomalie ed eseguono workflow multifase.
La maggior parte delle dashboard AI aziendali attribuirebbe a queste due organizzazioni lo stesso punteggio. La prima generazione di metriche per gli sviluppatori AI misurava accesso e attività: quante persone hanno una licenza, quante sono attive e quanti prompt inviano. Ma queste metriche non possono dirti se l’AI sta generando risultati di lavoro significativi.
Rispondere a questa domanda significa monitorare per cosa le persone usano l’AI e se questo cambia nel tempo. Ecco il framework che usiamo per misurare il valore dell’AI e cosa abbiamo scoperto applicandolo a due dei nostri team.
Un framework in quattro parti per misurare il valore dell’AI
1. Partire dal lavoro che l’AI sta svolgendo
Chiedere a un assistente di spiegare un’istruzione SQL è una richiesta diversa dal chiedere a un agente AI di creare una pipeline o investigare un errore. Raggruppa il lavoro svolto dall’AI in tre livelli:
- Lavoro di base: l’AI spiega il codice, risponde a domande e aiuta a comprendere un concetto non familiare.
- Sviluppo applicato: l’AI scrive e modifica codice, esplora i dati, risolve problemi e crea report o applicazioni.
- Lavoro agentico: si tratta di un processo multifase. L’AI ragiona sul contesto, usa strumenti e contribuisce a portare a termine un risultato invece di rispondere a una singola domanda.
Questa suddivisione descrive il lavoro, non il volume, e questo ti offre un elemento da verificare. Se l’AI sta creando capacità reale, le ore risparmiate dovrebbero riflettersi nel livello agentico.
2. Misurare adozione e AI fluency separatamente
La domanda successiva è se l’utilizzo a maggior valore si sia diffuso oltre a poche persone. Due dimensioni rispondono a questa domanda:
- Adozione: misura quanto ampiamente l’AI viene utilizzata nella popolazione idonea.
- AI fluency: mostra quanto sia diventato sofisticato il lavoro che le persone delegano all’AI.
Insieme, queste dimensioni descrivono quattro posizioni.
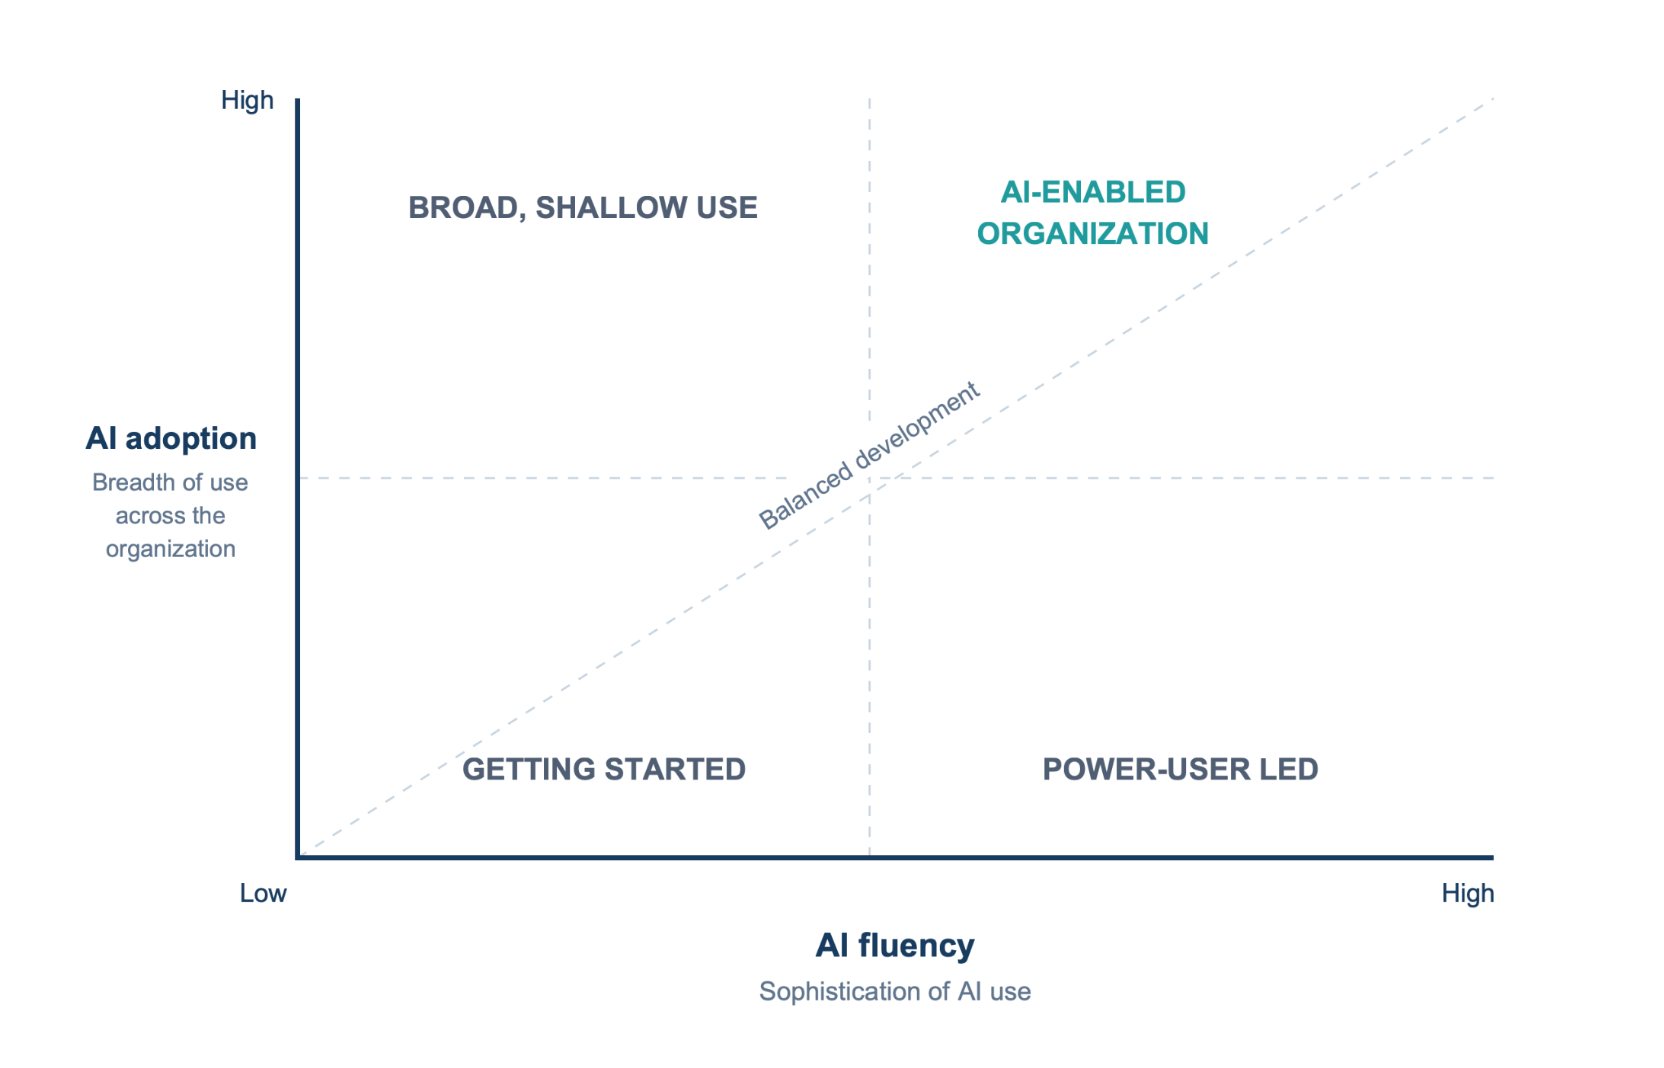
Figura 1. Misurazione di adozione e AI fluency.
3. Usare i benchmark di settore per il contesto
Un numero isolato è difficile da tradurre in azioni concrete. Se il 35% degli sviluppatori idonei utilizza attivamente un agente AI per il coding, questo dato da solo non ti dice se il 35% sia un buon risultato. Dipende da cosa fanno le organizzazioni comparabili, e le aspettative variano in base al settore. Un’azienda software e un assicuratore regolamentato non partono dalla stessa base di riferimento.
Il confronto con organizzazioni simili ti offre una visione relativa su entrambe le dimensioni. Invece di limitarsi a indicare che l’adozione è al 35%, può dirti se questo ti colloca tra le organizzazioni emergenti, in crescita, competenti o leader del tuo settore.
Lo stesso vale per l’AI fluency. Un’organizzazione può avere un’adozione ampia ma poco lavoro agentico. Un’altra può avere una manciata di utenti che svolgono un lavoro sofisticato che non si è diffuso. Questi due risultati richiedono risposte diverse.
4. Osservare il divario tra i tuoi utenti migliori e tutti gli altri
I tuoi utenti più avanzati sono il segnale da osservare.
Nella maggior parte delle organizzazioni, alcune persone individuano workflow AI efficaci prima dei colleghi. Imparano a delegare attività più ampie, fornire un contesto migliore e combinare strumenti. Considera questi pattern come una roadmap, non come una raccolta di aneddoti.
La domanda pratica è come trasferire un comportamento da una persona a 100. Per noi hanno funzionato quattro tattiche:
- Fai in modo che i power user insegnino, non solo che facciano demo: un workshop pratico guidato da una persona del team che ottiene già risultati è più efficace di una sessione di formazione del fornitore. Verifica se l’utilizzo settimanale si mantiene un mese dopo, non se la sala era piena. Un workshop che cambia le abitudini è diverso da uno che produce solo un picco.
- Trasforma i loro workflow in ricette e template: quando qualcuno risolve bene un problema, fallo scrivere come qualcosa che un collega possa eseguire, non solo leggere. Il test è se la persona successiva riesce a eseguirlo senza fare domande all’autore.
- Organizza uno show-and-tell periodico: prevedi uno spazio fisso in cui le persone presentano un workflow che hanno costruito, incluse le cose che non hanno funzionato. I fallimenti si diffondono meglio dei successi, perché indicano a tutti gli altri quali problemi vale la pena affrontare.
- Rendi la libreria facilmente trovabile: è il passaggio che la maggior parte dei team salta. Quando hai decine di workflow riutilizzabili, il limite non è più la creazione ma la scoperta, e una libreria che nessuno può cercare è una libreria che nessuno riutilizza.
L’obiettivo è diffondere le pratiche comprovate da poche persone a molte, e il meccanismo conta più dell’entusiasmo.
Cosa fare con la risposta
La misurazione ha senso solo quando indica un’azione, non semplicemente uno stato. Esistono tre posizioni comuni, e ciascuna suggerisce un diverso corso d’azione:
- Sofisticato ma limitato: i primi utilizzatori usano agenti AI per lavori avanzati, mentre la maggior parte delle persone idonee non ha ancora iniziato. Riduci gli attriti di accesso, condividi esempi interni ed espandi l’enablement.
- Ampio ma superficiale: molte persone usano l’AI, soprattutto per spiegazioni e generazione di codice semplice. Mostra loro come delegare attività più ampie attraverso esempi, template e formazione pratica.
- Ampio e sofisticato: aumentare ulteriormente l’adozione non è più la priorità. Individua i workflow ripetibili, crea agenti AI riutilizzabili e misura risultati come la velocità di sviluppo o l’efficienza operativa.
Le stesse metriche possono portare a consigli diversi, in base alla tua situazione di partenza.
Applicare il framework ai nostri team
Abbiamo dedicato due trimestri all’utilizzo di questo framework su Snowflake CoCo, il nostro assistente di sviluppo AI agentico, all’interno di Snowflake. Due team con attività molto diverse sono arrivati a risultati simili, e in entrambi i casi i vantaggi sono derivati da workflow agentici piuttosto che da un utilizzo di base.
Data science di prodotto: automatizzare un runbook diagnostico
Il nostro team di data science di prodotto gestisce migliaia di pipeline di dati. Nel primo trimestre del FY27, quelle pipeline hanno richiesto attenzione 960 volte, un dato normale su questa scala. Ogni caso richiedeva a un ingegnere esperto circa 30 minuti di diagnosi. Questo corrisponde a circa 160 ore al mese di tempo di esperti dedicate alla diagnosi.
Ora CoCo esegue questa diagnosi. Nel corso del Q1 e del Q2, lavorando al fianco del team, CoCo ha:
- Migliorato più di 500 pipeline
- Fatto il merge di centinaia di PR
- Ridotto il tempo dall’incidente a una correzione testata e verificabile a meno di 16 minuti
- Ridotto sprechi di centinaia di crediti ogni giorno.
Ottimizzare una pipeline costosa è utile ma raramente urgente, quindi è il tipo di lavoro che aspetta all’infinito. Un agente AI che propone queste modifiche come prassi non ha bisogno di una settimana tranquilla per occuparsene.
Il team aveva già svolto il lavoro importante prima che CoCo entrasse in gioco. Disponevano di un runbook diagnostico rigoroso, scritto nel corso di centinaia di incidenti e sufficientemente generale da risultare utile per arrivare al nocciolo di molti tipi diversi di incidenti. Questa disciplina è il motivo per cui gli incidenti venivano risolti in modo coerente. Il runbook era già abbastanza valido da poter essere scalato. Quello che mancava era un modo per eseguirlo senza dover aspettare che qualcuno fosse disponibile.
Così il team ha affidato il runbook a CoCo, facendolo attivare da un avviso invece che da una pressione di tasto. Stessi passaggi, stesso standard, ma veniva eseguito secondo i tempi dell’incidente e non quelli del team.
Questo è lo schema del passaggio dalla frontiera al mainstream nella sua forma più letterale. Un metodo che apparteneva a un solo team è diventato un workflow che funziona in autonomia. Se un metodo è chiaro abbastanza da poter formare una nuova risorsa, è chiaro abbastanza da poter essere affidato all’AI. E se attualmente esiste solo nell’esperienza di un esperto, metterlo per scritto ha valore di per sé.
Come funziona la revisione
CoCo propone, le persone decidono. Ogni modifica arriva sotto forma di pull request, revisionata e approvata da un responsabile designato. Il merge e il deployment restano in mano al team.
Questo confine è intenzionale e si sposta a seconda di dove si trova il lavoro. L’attenzione di chi revisiona diventa la risorsa da gestire, e un team che produce più proposte di quante ne possa leggere ha spostato il proprio collo di bottiglia, non lo ha eliminato. In cambio, gli ingegneri hanno trasferito 160 ore di diagnosi nella decisione finale, la parte che effettivamente richiedeva il loro intervento.
La lezione pratica: progettare il lavoro in modo che il suo risultato sia sempre qualcosa che una persona può revisionare. La revisione diventa il controllo, ed è questo che rende semplice eseguirlo su pipeline di produzione.
Marketing: dall'11,6% di fiducia al 70% di utilizzo settimanale
La prova più evidente che questo approccio si generalizza è arrivata da una parte dell’azienda che non ha quasi nessun ingegnere. L’organizzazione marketing Snowflake conta quasi 600 persone, la maggior parte più a proprio agio con uno slogan di campagna che con un’istruzione SQL.
Nel febbraio 2025, un sondaggio interno al team marketing del Nord America ha rilevato che l'11,6% si sentiva molto sicuro nell’usare l’AI nel proprio ruolo. Quando Snowflake CoCo è arrivato come research preview alla fine di quell’anno, otto addetti marketing del Nord America lo usavano settimanalmente.
A maggio 2026, l’utilizzo settimanale di CoCo nel team marketing globale aveva raggiunto il 70%. Separatamente, il 93% ha dichiarato di utilizzare strumenti di AI ogni giorno. Il primo dato è un comportamento osservato, il secondo è autodichiarato: per questo partiamo dal primo.
Cosa hanno creato:
Una pipeline di esportazione per motion graphics che ha trasformato un’intera settimana di lavoro per il Summit in 20 minuti.
Un’app di reporting win-loss su CoCo e Streamlit che pianifica i colloqui e genera il deck trimestrale per la leadership. Tre ore al mese di identificazione dei candidati più una settimana di lavoro sul deck sono ora automatizzate per circa il 90%.
Un motore di automazione per le richieste in entrata che gestisce da 2000 a 3000 risposte email giornaliere alle campagne globali senza alcun intervento umano, sostituendo un acquisto software già pianificato.
Da allora, gli addetti marketing hanno creato più di 600 skill personali e a livello di progetto, e da 100 a 200 ne hanno costruite di proprie da zero. L’utente mediano utilizza sette skill a settimana.
Entrambe le dimensioni sono cambiate. L’adozione è passata da una piccola minoranza sicura di sé a un utilizzo settimanale del 70%, e l’AI fluency è passata dal fare domande alla creazione di workflow che funzionano senza la presenza di chi li ha creati. Una dashboard che monitorasse solo l’adozione ne avrebbe colto solo metà.
Questo risultato è arrivato grazie agli AI Day trimestrali, agli hackathon regionali, a una newsletter e a sessioni di office hours, tutti gestiti dai colleghi stessi.
Perché il contesto della piattaforma è importante
Qualsiasi assistente AI capace può leggere un messaggio di errore. Questi risultati si confermano in produzione perché CoCo lavora dall’interno della piattaforma dati, dove il contesto necessario per una vera correzione è già disponibile.
Legge il catalogo dati e il lineage, verifica se i dati sono aggiornati e individua quali parti dell’azienda dipendono da una determinata tabella. Nell’uso interattivo funziona con le autorizzazioni della persona che lo utilizza, quindi il suo ambito corrisponde al loro. È questo ancoraggio che permette a un runbook scritto per le persone di essere trasferito a un agente AI.
Abbiamo pubblicato la misurazione invece di limitarci ad affermarla. Snowflake AI Research ha creato data-eng-bench, un benchmark aperto di 103 task reali di data engineering, valutati in base al funzionamento della pipeline risultante. Su questo benchmark, CoCo supera gli assistenti di coding general-purpose che abbiamo testato in termini di qualità rispetto al costo.
Come definire il primo workflow
Lo schema alla base di questi risultati è più ristretto del semplice “adotta l’AI”, e proprio per questo ha funzionato:
- Iniziare con lavoro ripetibile e ben definito: rispondere a una categoria conosciuta di avviso, alla pulizia di routine, all’analisi ricorrente che qualcuno esegue ogni lunedì. Il prerequisito è un metodo documentato, non una tecnologia specifica.
- Mantenere interattivo il lavoro che richiede giudizio: i problemi nuovi sono il terreno in cui una persona e un assistente insieme superano entrambi presi singolarmente, e saper riconoscere a quale categoria appartiene un task è gran parte dell’abilità richiesta.
- Monitorare la costanza d’uso piuttosto che il volume: monitorare la costanza d’uso piuttosto che il volume. Il numero di giorni in cui una persona decide di usare un assistente dice più del numero di prompt che invia, e il segnale è più forte quando il lavoro produce qualcosa di riutilizzabile.
Stiamo ancora imparando dove si applica questo schema. Riportiamo le pipeline migliorate e i problemi risolti. Il rapporto tra proposte avanzate e proposte accettate è il prossimo dato che intendiamo pubblicare, perché mostra quanta attenzione da parte dei revisori richiede questo schema in cambio. Lo stiamo strumentando proprio ora.
Utilizzo, comprensione, benchmarking, azione, impatto
Il numero di prompt, gli utenti attivi e il consumo restano importanti come punto di partenza. Un quadro più completo risponde a quattro domande:
- Chi utilizza l’AI?
- Per quale lavoro la utilizzano?
- Quanto è sofisticato quel lavoro, rispetto al lavoro dei colleghi e dei migliori utenti della propria organizzazione?
- Cosa bisogna fare dopo?
Questi quattro passaggi si susseguono in sequenza: utilizzo, comprensione, benchmarking, azione, impatto. Ciascuno dipende da quello precedente.
Questa sequenza spiega anche le due organizzazioni con cui abbiamo iniziato. La differenza tra loro non è mai stata il numero di interazioni. Una aveva trasferito un metodo documentato in un lavoro agentico, l’altra no, e solo il secondo tipo di misurazione lo rende visibile.
Scegli quindi un processo ripetibile e ben documentato che il tuo team già esegue, e misura quanto ti costa oggi.
Scopri come misuriamo la qualità e il costo degli agenti AI su lavori reali di data engineering in data-eng-bench, il benchmark aperto di Snowflake AI Research composto da 103 task di livello produttivo.