1週間に1,000回のAIインタラクションを記録する2つの組織を考えてみましょう。1つ目の組織では、そのインタラクションのほとんどが説明や検索です。2つ目の組織では、データパイプラインの構築、異常の調査、マルチステップのワークフローの実行が行われています。
ほとんどのエンタープライズAIダッシュボードでは、これら2つの組織は同じスコアになります。第1世代のAI開発者メトリクスは、アクセスとアクティビティ(ライセンスを保有している人数、アクティブな人数、送信されたプロンプト数)を測定するものでした。しかし、これらのメトリクスでは、AIが意味のある業務成果をもたらしているかどうかはわかりません。
その問いに答えるには、人々がAIを何に使用しているか、そしてそれが変化しているかを追跡する必要があります。ここでは、AIの価値を測定するために使用しているフレームワークと、それを社内の2つのチームに適用した結果をご紹介します。
AIの価値を測定するための4つの要素からなるフレームワーク
1.AIが実行している業務から始める
アシスタントにSQL文の説明を求めることと、エージェントにパイプラインの構築や障害の調査を求めることは、異なるリクエストです。AIが実行している業務を次の3つのレベルに分類します。
- 基礎的な業務:AIがコードを説明し、質問に答え、なじみのない概念の理解を支援します。
- 応用開発:AIがコードの記述と変更、データの探索、トラブルシューティングを行い、レポートやアプリケーションを構築します。
- エージェント型業務:これはマルチステップのプロセスです。AIはコンテキスト全体を推論し、ツールを使用し、単に1つの質問に答えるのではなく、成果の達成を支援します。
この分類は、量ではなく業務内容を説明するものであり、確認すべき指標となります。AIが真のキャパシティを生み出している場合、節約された時間はエージェント型レベルに現れるはずです。
2.導入と習熟度を個別に測定する
次の課題は、より価値の高い使用方法が一部の人々を超えて広がっているかどうかです。これには2つの側面があります。
- 導入:これは、対象となる人々の間でAIがどの程度広く使用されているかを測定します。
- AIの習熟度:これは、人々がAIに委任する業務がどの程度高度になっているかを示します。
これらの側面を組み合わせることで、4つのポジションが説明されます。
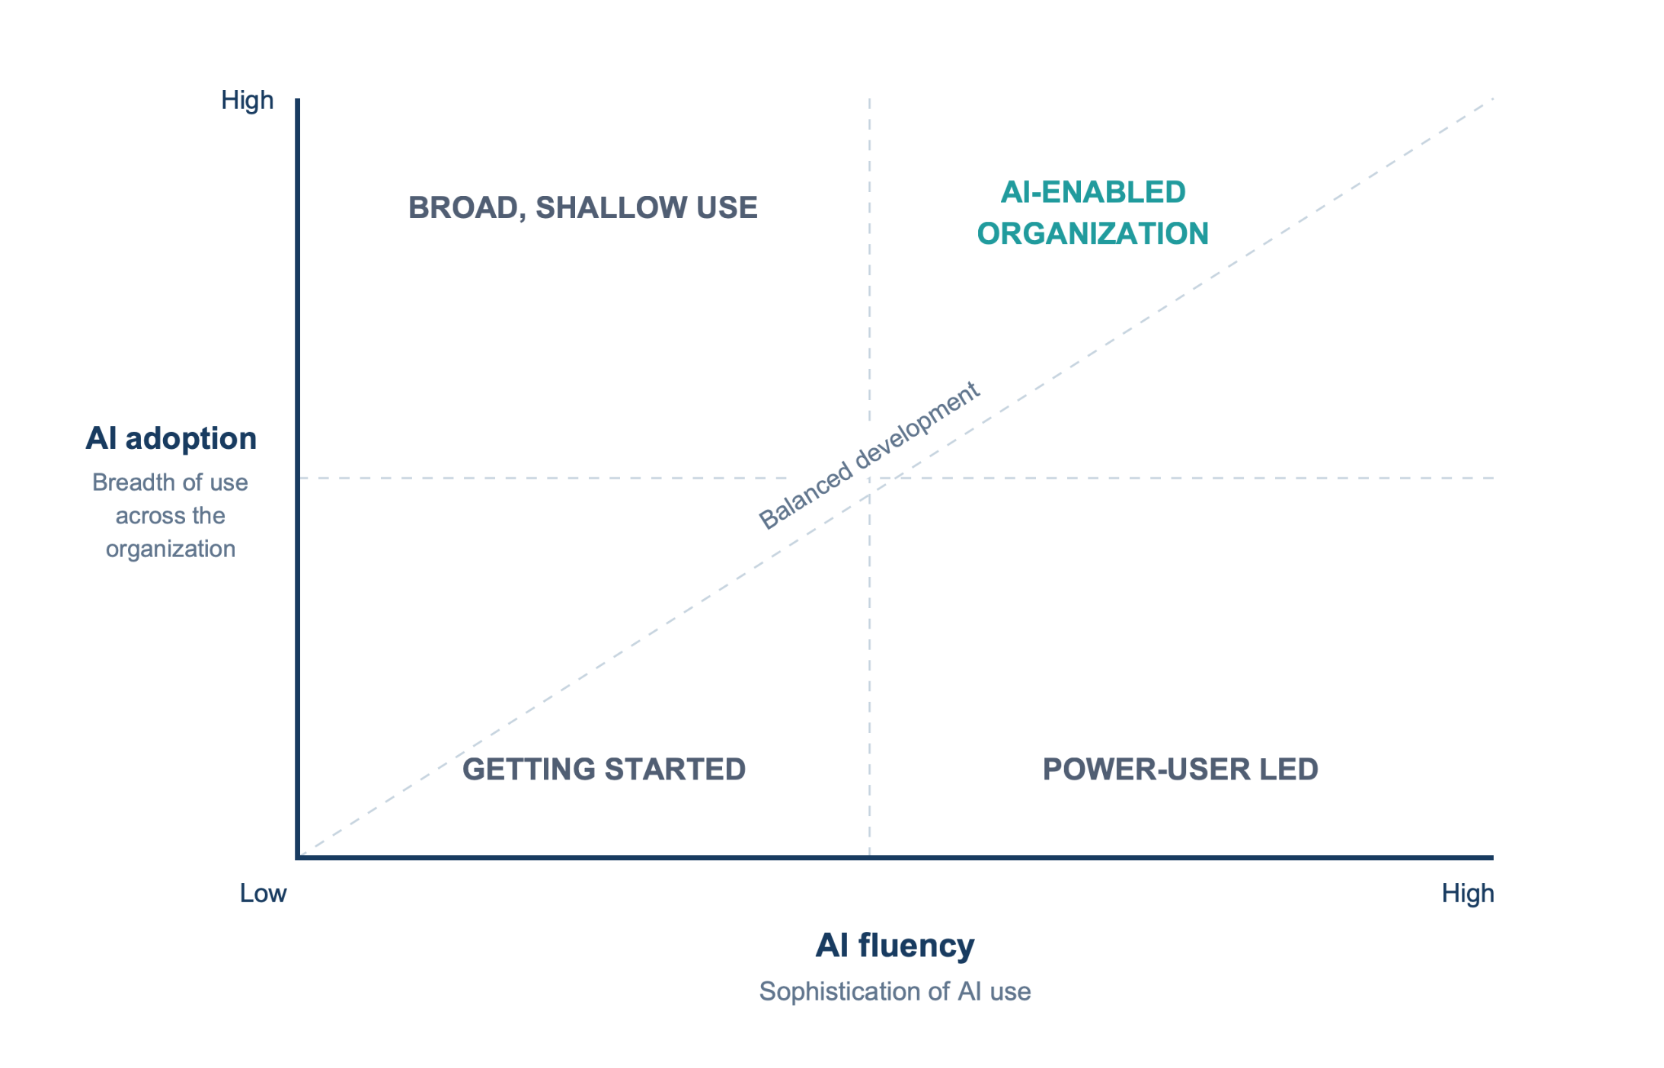
図 1:AIの導入とAIの習熟度の測定
3.コンテキストとして業界ベンチマークを使用する
数値だけでは行動を起こすのは困難です。対象となる開発者の35%がAIコーディングエージェントを積極的に使用している場合、その数値だけでは35%が良いかどうかはわかりません。それは同等の組織が何をしているかによって異なり、期待値は業界によって異なります。ソフトウェア企業と規制対象の保険会社では、同じベースラインで業務を行っているわけではありません。
ピアベンチマークにより、両方の側面について相対的な見方が得られます。導入率が35%であると報告する代わりに、それが業界内で新興、発展途上、熟練、またはリードしている組織のいずれに位置するかを知ることができます。
習熟度についても同様です。ある組織では導入が広く進んでいても、エージェント型業務がほとんどない場合があります。別の組織では、少数のユーザーが高度な業務を行っていても、それが広がっていない場合があります。これら2つの結果には、異なる対応が求められます。
4.最も優れたユーザーと他のユーザーとのギャップに注目する
最も高度なユーザーは、注目に値するシグナルです。
ほとんどの組織では、少数の人々が同僚よりも先に効果的なAIワークフローを見つけます。彼らは、より大きなタスクを引き継ぎ、より良いコンテキストを提供し、ツールを組み合わせることを学びます。これらのパターンを、単なる逸話の集まりではなく、ロードマップとして扱います。
実践的な課題は、1人の行動を100人にどのように広げるかです。当社では次の4つの戦術が効果的でした。
- 単なるデモではなく、パワーユーザーに教えさせる:すでに結果を出しているチームメンバーが主導する実践的なワークショップは、ベンダーのトレーニングセッションよりも優れています。部屋が満員だったかどうかではなく、1か月後も毎週の使用量が維持されているかどうかに注目します。習慣を変えるワークショップは、一時的な急増を生み出すものとは異なります。
- ワークフローをレシピやテンプレートに変える:誰かが問題をうまく解決したときは、同僚が読むだけでなく実行できるものとして書き留めてもらいます。テストは、次の人が作成者に質問することなくそれを実行できるかどうかです。
- 定期的な発表会を開催する:うまくいかなかったことも含め、構築したワークフローを説明する定期的な枠を設けます。失敗は成功よりもよく伝わります。なぜなら、どの問題が試みる価値があるかを他の全員に教えてくれるからです。
- ライブラリを見つけやすくする:これはほとんどのチームがスキップするステップです。再利用可能なワークフローが数十個になると、作成ではなく発見が制約となり、誰も検索できないライブラリは誰も再利用しないライブラリになります。
目的は、実証済みの実践を少数の人々から多くの人々に広げることであり、熱意よりもメカニズムが重要です。
答えをどう活用するか
効果測定は、ステータスではなくアクションを示すときにその価値を発揮します。一般的なポジションは3つあり、それぞれ異なる行動方針を示唆しています。
- 高度だが限定的:アーリーアダプターは高度な業務にエージェントを使用していますが、対象となるほとんどの人はまだ始めていません。アクセスの摩擦を取り除き、社内の事例を共有し、イネーブルメントを拡大します。
- 広範だが浅い:多くの人がAIを使用していますが、主に説明や簡単なコード生成のためです。事例、テンプレート、実践的なトレーニングを通じて、より大きなタスクを引き継ぐ方法を示します。
- 広範かつ高度:導入の拡大はもはや優先事項ではありません。反復可能なワークフローを見つけ、再利用可能なエージェントを構築し、開発速度や運用効率などの成果を測定します。
同じメトリクスでも、現在の状況によって異なる推奨事項がサポートされます。
自社のチームへのフレームワークの適用
当社は2四半期を費やして、Snowflake社内でエージェント型AI開発アシスタントであるSnowflake CoCoにこのフレームワークを使用しました。まったく異なる業務を行う2つのチームが似たような結果に落ち着き、どちらの場合も、基礎的な使用ではなくエージェント型ワークフローから利益が得られました。
プロダクトデータサイエンス:診断ランブックの自動化
当社のプロダクトデータサイエンスチームは、何千ものデータパイプラインを実行しています。2027年度第1四半期には、これらのパイプラインで960回の対応が必要でしたが、この規模では通常の範囲です。各ケースの診断には、熟練したエンジニアが約30分かかりました。これは、専門家が診断に費やす時間が月に約160時間になる計算です。
現在はCoCoがその診断を実行しています。第1四半期と第2四半期を通じて、チームと協力してCoCoは次のことを行いました。
- 500以上のパイプラインを改善
- 100以上のマージされたPRを生成
- インシデント発生からテストおよびレビュー可能な修正までの時間を16分未満に短縮
- 毎日無駄になっていた数百のクレジットを削減
コストのかかるパイプラインの最適化は価値がありますが、緊急を要することはまれであるため、無期限に後回しにされる業務です。そのような変更を当然のこととして提案するエージェントであれば、それに取り組むための静かな1週間を必要としません。
チームは、CoCoが関与する前に重要な業務を完了していました。彼らには、何百ものインシデントを通じて作成され、さまざまな種類のインシデントの真相を究明するのに役立つほど汎用的な、厳密な診断ランブックがありました。そのような規律があったからこそ、インシデントは一貫して解決されていました。ランブックはすでにスケールするのに十分な品質でした。必要だったのは、誰かの手が空くのを待たずに実行する方法でした。
そこでチームはランブックをCoCoに渡し、キーストロークの代わりにアラートでトリガーするようにしました。同じ手順、同じ基準ですが、チームのスケジュールではなくインシデントのスケジュールで実行されました。
これは、最先端から主流へのパターンを最も文字通りに表したものです。1つのチームに存在していたメソッドが、自律的に実行されるワークフローになりました。新入社員のオンボーディングに十分なほど明確なメソッドであれば、AIに引き継ぐのにも十分明確です。また、それが現在1人の専門家の経験の中に存在している場合、それを書き留めること自体に価値があります。
レビューの仕組み
CoCoが提案し、人が決定します。すべての変更はプルリクエストとして届き、指名された所有者がレビューして承認します。マージとデプロイはチームが行います。
その境界は意図的なものであり、業務が存在する場所に移動します。レビュアーの注意力が管理すべき対象となり、読める以上の提案を生み出すチームは、制約を取り除いたのではなく、制約の場所を移動させたことになります。その代わりに、エンジニアは160時間の診断を、彼らを必要とする部分である最後の判断に移行しました。
実践的な教訓:出力が常に人がレビューできるものになるように業務を設計します。レビューが制御となり、それが本番パイプラインに対して実行することを容易にします。
マーケティング:自信のある11.6%から毎週70%の使用へ
これが一般化することの最も明確な証拠は、エンジニアがほとんどいない社内の部門から得られました。Snowflakeのマーケティング組織は約600人で構成されており、そのほとんどはSQL文よりもキャンペーンスローガンに慣れ親しんでいます。
2025年2月に北米マーケティングチームを対象に行われた社内調査では、自分の役割でAIを使用することに非常に自信を持っていると答えたのは11.6%でした。その年の後半にSnowflake CoCoがリサーチプレビューとして登場したとき、北米の8人のマーケターが毎週それを使用していました。
2026年5月までに、グローバルマーケティングチーム全体でのCoCoの毎週の使用率は70%に達しました。これとは別に、93%がAIツールを毎日使用していると回答しました。前者は観察された行動であり、後者は自己申告であるため、前者を優先しています。
構築したもの:
Summitでの丸1週間の作業を20分に短縮したモーショングラフィックスエクスポートパイプライン。
インタビューをスケジュールし、四半期ごとのリーダーシップ向け資料を生成する、CoCoとStreamlit上の勝敗レポートアプリ。月に3時間の候補者特定と1週間の資料作成作業が、現在では約90%自動化されています。
計画されていたソフトウェアの購入に代わり、グローバルキャンペーンに対する毎日2,000〜3,000件のEメールの返信を人の介入なしで処理するインバウンド自動化エンジン。
その後、マーケターは600以上の個人およびプロジェクトレベルのスキルを作成し、100〜200人がゼロから独自のスキルを構築しました。中央値のユーザーは週に7つのスキルを実行します。
両方の側面が変化しました。導入は自信のある少数の人々から毎週70%の使用へと拡大し、習熟度は質問をすることから、作成者がいなくても実行されるワークフローを作成することへと進化しました。導入のみを監視するダッシュボードでは、その半分を見逃していたでしょう。
これは、四半期ごとのAI Days、地域のハッカソン、ニュースレター、オフィスアワーなど、すべてピア主導の取り組みから生まれました。
プラットフォームのコンテキストが重要である理由
有能なAIアシスタントであれば、エラーメッセージを読むことができます。これらの結果が本番環境で維持されるのは、CoCoがデータプラットフォームの内部から機能し、実際の修正が依存するコンテキストがすでにそこに存在しているためです。
データカタログとリネージを読み取り、データが最新であるかどうかを確認し、ビジネスのどの部分が特定のテーブルに依存しているかを確認します。インタラクティブな使用では、使用する人の権限で実行されるため、そのスコープはユーザーのスコープと一致します。そのような基盤があるからこそ、人向けに書かれたランブックをエージェントに移行できるのです。
当社はそれを主張するのではなく、効果測定を公開しました。Snowflake AI Researchは、結果として得られたパイプラインが機能するかどうかで評価される、103の実際のデータエンジニアリングタスクのオープンベンチマークであるdata-eng-benchを構築しました。そのベンチマークにおいて、CoCoはコストに対する品質の面で、当社がテストした汎用コーディングアシスタントをリードしています。
最初のワークフローのスコープを設定する方法
これらの結果の背後にあるパターンは「AIの導入」よりも限定的であり、それがうまくいった理由です。
- 反復可能で明確に指定された業務から始める:既知のカテゴリのアラートへの対応、定期的なクリーンアップ、誰かが毎週月曜日に実行する定期的な分析などです。前提条件は文書化されたメソッドであり、特定のテクノロジーではありません。
- 判断を要する業務はインタラクティブに保つ:新しい問題は、人とアシスタントが協力することで単独よりも優れた結果を出せる領域であり、タスクがどのカテゴリに該当するかを知ることがスキルの大部分を占めます。
- 量よりも一貫した使用を追跡する:量よりも一貫した使用を追跡します。誰かがアシスタントを使用することを選択した日数は、送信したプロンプトの数よりも多くのことを教えてくれます。また、業務が再利用可能なものを生み出すときに、そのシグナルは最も強くなります。
当社は、このパターンがどこに適用されるかをまだ学習中です。改善されたパイプラインと解決された問題を報告します。提起された提案に対する承認された提案の割合は、次に公開する予定の数値です。なぜなら、このパターンがその見返りとしてレビュアーの注意をどれだけ要求するかを示しているからです。現在、そのための計測を行っています。
使用、理解、ベンチマーキング、アクション、影響
プロンプト数、アクティブユーザー数、消費量は、出発点として依然として重要です。より全体的な状況を把握することで、次の4つの質問に答えることができます。
- 誰がAIを使用しているか
- どのような業務に使用しているか
- 同業他社や自社の最も優れたユーザーの業務と比較して、その業務はどの程度高度か
- 次に何をすべきか
これら4つのステップは、使用、理解、ベンチマーキング、アクション、影響というシーケンスで実行されます。それぞれが前のステップに依存しています。
このシーケンスは、冒頭で紹介した2つの組織についても説明しています。両者の違いは、インタラクション数ではありませんでした。一方は文書化されたメソッドをエージェント型業務に移行していましたが、もう一方はそうではありませんでした。そして、2番目の種類の効果測定のみがそれを可視化します。
したがって、チームがすでに実行している、反復可能で十分に文書化されたプロセスを1つ選び、現在それにどれだけのコストがかかっているかを測定してください。
103の本番環境レベルのタスクからなるSnowflake AI Researchのオープンベンチマークであるdata-eng-benchで、実際のデータエンジニアリング業務におけるエージェントの品質とコストを当社がどのように測定しているかをご確認ください。