29 jul 2026/14 min de lectura
De Iceberg a la inteligencia: lakehouse sin fronteras preparado para la IA con Snowflake y Google Cloud

Iceberg: de los silos a la interoperabilidad
Antes, cada base de datos era propietaria de sus datos, lo que funcionaba cuando las organizaciones tenían un único motor de analíticas. Hoy en día, los equipos de datos suelen combinar Apache Spark™, BigQuery, Gemini Enterprise Agent Platform, Snowflake (incluidos CoCo y CoWork de Snowflake) y otros servicios en función de la tarea, a menudo dentro del mismo pipeline.
Esto creó una disyuntiva: elegir entre flexibilidad y coherencia.
- Permitir que cada equipo use su motor preferido y replique los datos entre sistemas, lo que genera redundancia, incoherencias y riesgos.
- Obligar a todos a usar un único motor y sacrificar la especialización y la autonomía que ofrecen las arquitecturas con varios motores.
El sector necesitaba una tercera opción, que surgió de una idea fundamental conocida como el principio de localidad de los datos: es más rápido, económico y seguro trasladar una pequeña porción de código ejecutable hasta donde ya se encuentran los datos que mover volúmenes masivos de datos a través de una red.
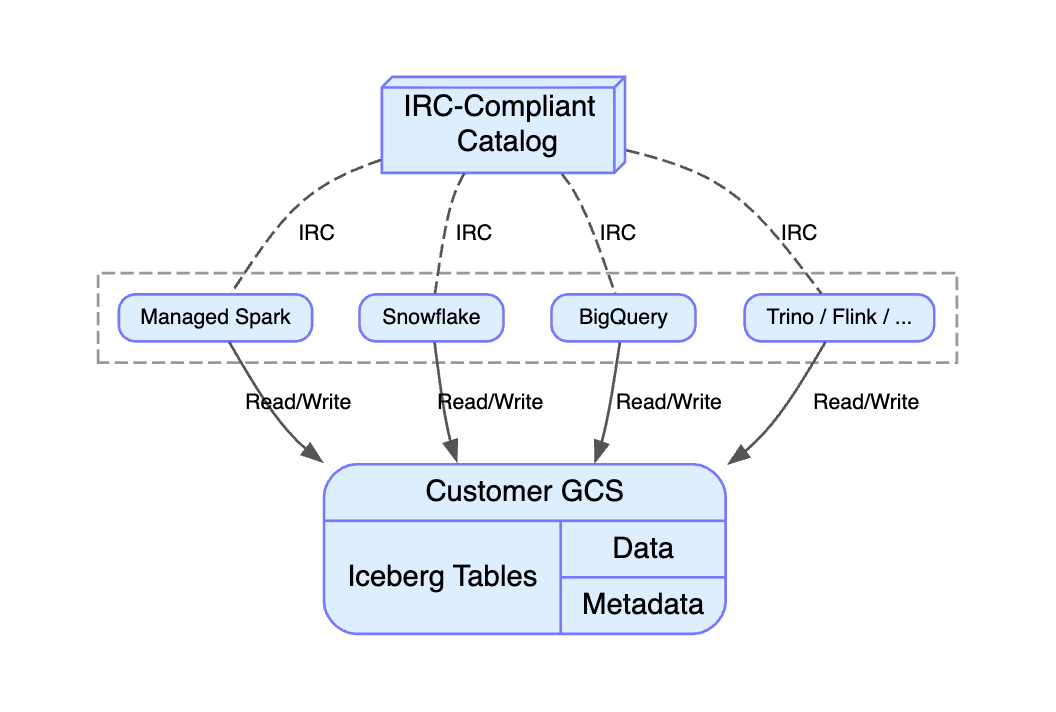
Estas ideas convergen en un único patrón: en lugar de copiar los datos en cada motor, lleva el procesamiento de cada motor hasta los datos. Todos los datos se encuentran en el bucket de almacenamiento del cliente y todos los motores siguen la misma organización física, de modo que cada uno puede leer y escribir directamente en la misma tabla.
Para ello, se necesita un formato de tabla abierto acordado: un lenguaje compartido que todos los motores comprendan.
El sector adoptó Apache Iceberg™ como ese formato. Iceberg, desarrollado en Netflix para gestionar tablas a escala de petabytes y posteriormente donado a Apache Software Foundation, es compatible con Spark, Trino, Flink, BigQuery, Snowflake y decenas de otros motores. Con Iceberg como lenguaje compartido, todos los motores pueden participar sin adaptadores propietarios.
Catálogo: de Iceberg al lakehouse
Un formato abierto resuelve en gran medida la interoperabilidad, pero plantea una nueva pregunta: ¿quién está a cargo? Cuando varios motores pueden leer y escribir en los mismos archivos, alguien debe gestionar los metadatos de las tablas, aplicar las políticas de acceso, coordinar las escrituras simultáneas y garantizar que ningún motor vea un estado obsoleto o incoherente. Esa función corresponde al catálogo, que actúa como la capa de gobernanza del lakehouse. Es la única autoridad que sabe qué tablas existen, cómo son sus esquemas, quién puede acceder a ellas y dónde se encuentran físicamente los archivos de datos. Sin un catálogo, los datos abiertos carecen de gobernanza.
El catálogo también controla el acceso al almacenamiento mediante credenciales delegadas. Cuando un motor solicita datos de una tabla, el catálogo devuelve tokens de almacenamiento de corta duración y alcance limitado en lugar de credenciales permanentes del bucket, para que los motores no obtengan acceso persistente a la capa de almacenamiento subyacente.
Para que este modelo funcione con motores creados por distintos proveedores, los catálogos necesitan un protocolo de integración estandarizado. Sin él, cada motor necesitaría una integración personalizada con cada catálogo. Iceberg REST Catalog (IRC) es la especificación de API abierta que resuelve este problema: define cómo los clientes detectan espacios de nombres, cargan los metadatos de las tablas y confirman las actualizaciones. Cada catálogo expone un punto de conexión de IRC y cada motor se conecta como cliente.
Esta combinación de credenciales delegadas y un protocolo estándar permite que los motores traspasen los límites entre catálogos, lo que el sector denomina federación. Cuando una consulta de Snowflake accede al catálogo de Lakehouse de Google Cloud o un trabajo de BigQuery lee datos de Snowflake Horizon, cada catálogo emite únicamente los tokens de alcance limitado y duración determinada que realmente necesita el motor solicitante. Así, la gobernanza se aplica independientemente del motor que inicie la solicitud. La verdadera interoperabilidad requiere que esto funcione en ambas direcciones: federación entrante, en la que los motores externos a tu catálogo pueden leer y escribir en tus tablas de Iceberg, y federación saliente, en la que tu procesamiento puede leer y escribir en tablas de Iceberg gestionadas por otro catálogo.
Juntos, el catálogo y las credenciales delegadas proporcionan una capa de gobernanza con una única autoridad que aplica la seguridad, controla el acceso y centraliza las auditorías. Ahora los clientes pueden obtener acceso bidireccional a tablas de Iceberg entre catálogos, lo que permite una arquitectura sin copia entre motores compatibles con Iceberg.
La pregunta arquitectónica clave pasa a ser: ¿quién gestiona el catálogo? Los clientes pueden implementar y gestionar por sí mismos un catálogo o, lo que es más probable, utilizar un Iceberg REST Catalog gestionado.
Las empresas que prefieran hacerlo por sí mismas pueden implementar Apache Polaris™, una conocida implementación de IRC de código abierto creada originalmente de forma conjunta por Snowflake y Dremio y donada a Apache Software Foundation. Esto proporciona a estas organizaciones un control total, pero también transfiere toda la responsabilidad operativa —incluidos la infraestructura, el escalado, la aplicación de parches y la disponibilidad— al equipo del cliente. A diferencia de las soluciones gestionadas, los catálogos gestionados por el propio cliente no son serverless ni reducen su escala a cero cuando no se utilizan, lo que genera un costo operativo continuo.
En la práctica, la mayoría de las organizaciones eligen un IRC gestionado para poder centrarse en los datos en lugar de en las operaciones del catálogo. Cuando se utilizan tanto Snowflake como Google Cloud, cada uno ofrece una opción idónea:
- El catálogo de entorno de ejecución de Lakehouse (el catálogo de Iceberg gestionado de Google Cloud, que forma parte de Lakehouse for Apache Iceberg) es un metastore sin servidor y escalable que actúa como única fuente de verdad para tu data lakehouse. Permite que varios motores —BigQuery, Spark gestionado por Google, Apache Spark, Trino y Snowflake— accedan a la misma copia de los datos mediante formatos abiertos como Apache Iceberg. La federación permite que los agentes y motores de Google Cloud accedan a datos más allá de sus límites desde catálogos de Snowflake, Databricks y AWS Glue.
- Snowflake Horizon Catalog integra Apache Polaris e incorpora puntos de conexión de IRC conformes con los estándares en cada cuenta de Snowflake, sin necesidad de configuración adicional. Además de las operaciones básicas del catálogo, Horizon añade gobernanza empresarial: control de acceso basado en roles (RBAC), enmascaramiento a nivel de columna, políticas de acceso a filas, linaje de datos y registros de auditoría. Permite que motores compatibles con Iceberg, como Trino, BigQuery, Apache Flink y muchos otros, lean y escriban en tablas de Iceberg gestionadas por Snowflake.
Federación: del lakehouse al lakehouse abierto
El catálogo de entorno de ejecución de Lakehouse, Snowflake Horizon Catalog y otras opciones de catálogo gestionado no son mutuamente excluyentes. Pueden coexistir en la misma organización mediante la federación de catálogos, lo que permite que las organizaciones comiencen con un único catálogo y amplíen la federación de forma gradual a medida que evolucionan sus necesidades.
Cada catálogo gestiona sus propias tablas, mientras que todos los motores acceden a ellas mediante IRC.
Cuando Google Cloud gestiona el catálogo a través del catálogo de entorno de ejecución de Lakehouse, Snowflake se conecta mediante una base de datos vinculada a un catálogo (CLD) que detecta y sincroniza automáticamente las tablas desde sus puntos de conexión de IRC. Los usuarios de Snowflake interactúan con esas tablas de Iceberg de Lakehouse de Google Cloud mediante SQL estándar (SELECT, INSERT, UPDATE, DELETE) o a través de CoCo o CoWork de Snowflake como si fueran tablas nativas, con la gobernanza de Snowflake (RBAC, enmascaramiento y linaje) añadida por encima.
Del mismo modo, cuando Snowflake gestiona el catálogo mediante Horizon, los servicios de Google Cloud acceden a esas tablas a través de la federación de catálogos de Lakehouse: BigQuery, Managed Service for Apache Spark y otros motores compatibles con Iceberg de Google Cloud se conectan al punto de conexión de IRC de Horizon y leen y escriben directamente en las tablas de Iceberg gestionadas por Snowflake.
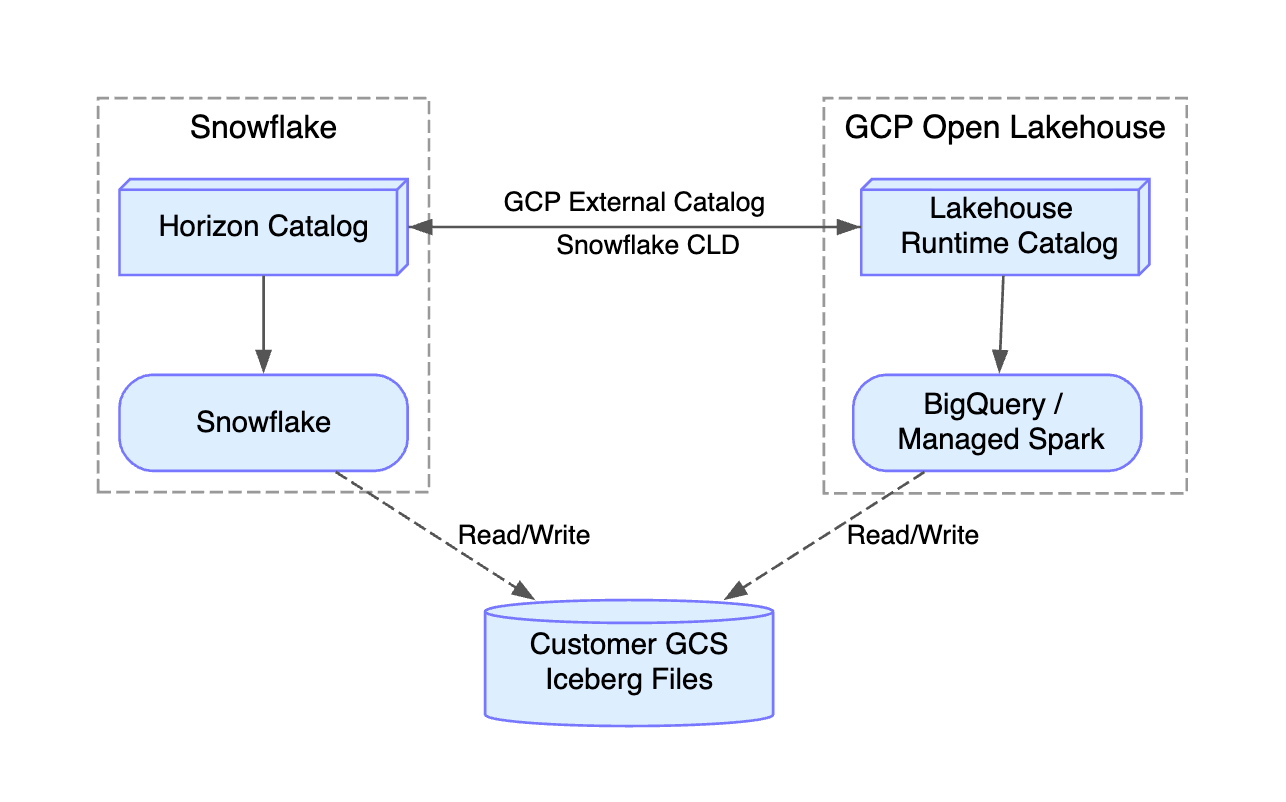
El resultado es una plataforma de datos completamente abierta e interoperable: todos los motores leen y escriben directamente en el Cloud Storage Bucket de los clientes, sin procesos de extracción, transformación y carga (ETL) entre sistemas, y cada equipo elige la mejor herramienta para la tarea según sus propias preferencias. Mientras tanto, la capa del catálogo aplica una gobernanza unificada en todos ellos.
Contexto semántico: del lakehouse abierto al lakehouse preparado para la IA
Un lakehouse con una arquitectura adecuada resuelve en gran medida la interoperabilidad de los datos, pero la interoperabilidad por sí sola no hace que los datos sean útiles para la IA. Entre “los datos son accesibles” y “la IA genera respuestas y acciones precisas y confiables” existen tres brechas:
- Acceso programático
- Fundamentación semántica
- Inteligencia contextual
Acceso programático
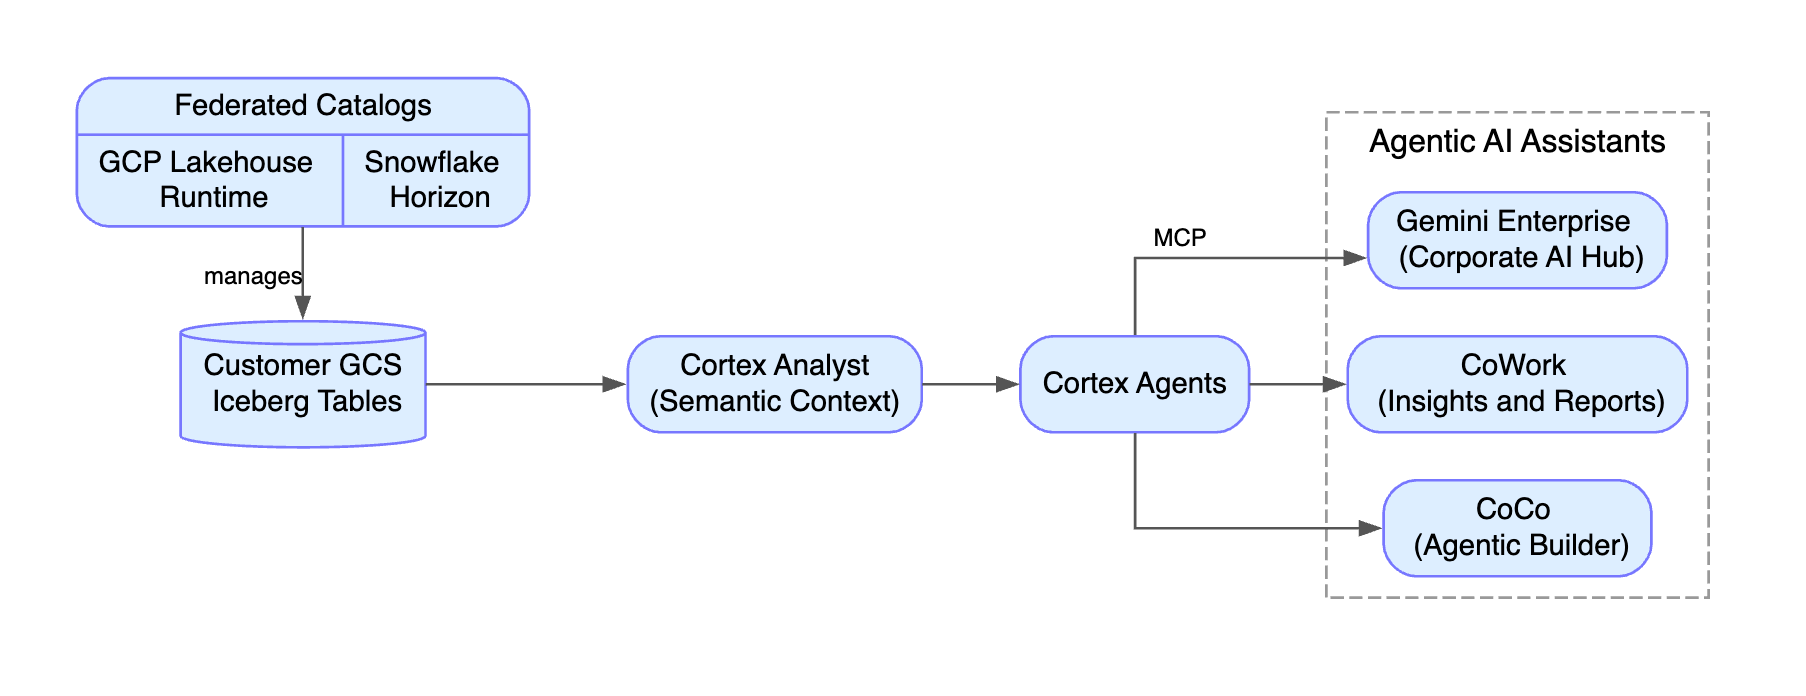
Los analistas humanos consultan las tablas mediante su motor preferido, pero los agentes de IA necesitan sus propios canales. Snowflake incluye servidores del protocolo de contexto de modelo (MCP) que permiten a cualquier cliente compatible con MCP descubrir y consultar los datos del lakehouse, así como razonar sobre ellos. MCP es un estándar abierto que proporciona una interfaz universal entre las aplicaciones de IA y las fuentes de datos. Esto significa que Gemini Enterprise, los asistentes de programación y los frameworks de agentes personalizados se conectan mediante el mismo protocolo, sin necesidad de integraciones específicas. Asimismo, BigQuery ofrece un servidor MCP al que pueden acceder agentes de IA propios y de terceros, lo que permite el acceso programático a los activos del lakehouse para flujos de trabajo con agentes en Google Cloud y entornos multinube.
Las aplicaciones que necesitan un control programático directo, como los frameworks de orquestación, los pipelines personalizados o las analíticas integradas, también pueden acceder a Cortex Agents y a los agentes de Gemini Enterprise mediante REST API. En conjunto, MCP y REST proporcionan a los agentes de IA el mismo acceso autenticado y sujeto a gobernanza a las tablas de Iceberg que tienen los analistas humanos, independientemente del catálogo que las gestione.
Fundamentación semántica
Los sistemas de IA generan alucinaciones cuando no comprenden qué representan los datos. Los modelos semánticos subsanan esta carencia al definir la lógica de negocio sobre las tablas físicas: métricas con reglas de cálculo, dimensiones con jerarquías, relaciones entre entidades y patrones de consulta verificados que codifican el conocimiento institucional. La idea clave es que la lógica de negocio debe residir en la capa de datos, no en los prompts de IA. Cuando las definiciones residen en un modelo semántico sobre los datos, todos los sistemas de IA heredan la misma lógica correcta, lo que reduce la deriva, las incoherencias y la incertidumbre.
Semantic View Autopilot, que forma parte de Horizon Context, hace que este enfoque sea sostenible a escala. En lugar de exigir que los analistas definan manualmente cientos de modelos semánticos, Autopilot los descubre y mantiene automáticamente al aprender de los patrones de consulta, el comportamiento de los usuarios, las relaciones entre tablas, las integraciones con herramientas de inteligencia empresarial (BI) y el uso de informes. Para los equipos que prefieren crear y perfeccionar modelos en lenguaje natural, el asistente CoCo integrado en Semantic Studio funciona junto con un editor visual y de YAML integrado con Git, de modo que las definiciones semánticas puedan someterse a control de versiones y revisarse como cualquier otro activo de código. A medida que evolucionan los datos, los modelos semánticos se mantienen actualizados para que la precisión de la IA no se deteriore con el tiempo. El resultado son menos alucinaciones, mayor precisión y una lógica de negocio fundamentada en los datos reales. Del mismo modo, se puede aprovechar la capa semántica universal de Google Cloud gracias a la nueva compatibilidad de Looker con los modelos de analíticas en la base de datos, que incluyen una nueva integración con BigQuery Graph y vistas semánticas de Snowflake y ofrecen la potencia de los modelos de grafos a los usuarios de negocio en procesos clave con agentes.
Inteligencia contextual
El contexto es el conocimiento circundante que indica a un sistema de IA no solo qué son los datos, sino también cómo interpretarlos correctamente. Snowflake Horizon Context crea y aplica esta capa contextual: descripciones de tablas y columnas en términos de negocio, indicadores de calidad de los datos (actualidad, integridad y salvedades), patrones de uso (qué tablas son las fuentes autorizadas para cada pregunta) y relaciones entre dominios en todo el lakehouse. Como este contexto reside en Horizon, hereda la misma gobernanza que los propios datos, por lo que los agentes y usuarios solo reciben el contexto y las respuestas que están autorizados a ver. Del mismo modo, Google Cloud Lakehouse proporciona contexto confiable mediante Knowledge Catalog, que ofrece información generada por Gemini sobre las tablas del lakehouse para ayudar a mitigar las alucinaciones de los agentes de IA y permitir que los usuarios conviertan esa información en acciones. Este contexto se aplica a cualquier tabla de Iceberg, ya sea nativa de Snowflake, esté vinculada mediante CLD o federada desde Google Cloud. La IA recibe los datos junto con el contexto necesario para interpretarlos correctamente. Esto es lo que distingue una respuesta genérica de un LLM (“los ingresos podrían ser...”) de una respuesta fundamentada (“Los ingresos del cuarto trimestre fueron de 47,2 millones de USD según la tabla de referencia finance.revenue, con el filtro de la definición de trimestre fiscal”).
Agentes de IA: de los datos a la acción
Con el contexto empresarial y las vistas semánticas implementados, los agentes de IA operan con datos estructurados y no estructurados con gran precisión. Snowflake CoWork es un agente de trabajo personal para cada profesional del conocimiento, capaz de razonar en profundidad, automatizar tareas rutinarias y acelerar el camino de las ideas a las decisiones y a la acción. En lugar de esperar instrucciones, CoWork trabaja de forma proactiva: saca a la luz información valiosa, ejecuta análisis en segundo plano y ofrece respuestas gobernadas y trazables basadas en cómo tu empresa define realmente sus datos.
Snowflake CoCo lleva estas capacidades al flujo de trabajo de desarrollo y funciona como un agente de programación nativo de datos para las tareas del ciclo de vida de los datos empresariales: crear y mantener pipelines, crear Cortex Agents y aplicaciones de Streamlit, y generar código SQL y Python validado y basado en los metadatos reales del catálogo. Tanto los profesionales del conocimiento como los ingenieros de datos se benefician de la misma fundamentación semántica y trabajan con gobernanza y observabilidad tanto en las acciones humanas como en las de los agentes.
Esa misma base federada también permite disponer de forma nativa de las capacidades de IA de Google Cloud. Como el lakehouse se ejecuta en Google Cloud, Gemini está disponible de forma nativa en todo el stack tecnológico. Gracias a la comprensión multimodal de Gemini (texto, imágenes, video y código en un único contexto), los datos del lakehouse no se limitan a tablas estructuradas: los documentos de GCS, las imágenes y el contenido no estructurado también forman parte del flujo de trabajo de IA. Sus amplias ventanas de contexto procesan simultáneamente esquemas extensos, definiciones de modelos semánticos e historiales de consultas, lo que mejora la precisión de las respuestas a preguntas analíticas complejas.
Gemini Enterprise se conecta al lakehouse mediante MCP, a través de los servidores MCP de Snowflake o del servidor MCP de BigQuery, con Lakehouse for Apache Iceberg. Los empleados que usan Gemini Enterprise plantean preguntas en lenguaje natural que se responden con datos gobernados de las tablas de Iceberg, y sus consultas se canalizan a través de Cortex Agents y modelos semánticos para garantizar respuestas fundamentadas. Ya sea que un usuario interactúe mediante CoWork, Cortex Code, Gemini Enterprise o un agente REST personalizado, se aplican la misma capa semántica, el mismo contexto y la misma gobernanza.
El resultado no es solo un lakehouse abierto, sino un lakehouse abierto preparado para la IA, donde los datos son interoperables, están gobernados, cuentan con riqueza semántica y son accesibles tanto para las personas como para los agentes de IA mediante protocolos estandarizados.
Seguir aprendiendo
- Descubre las mejoras más recientes del producto para crear un lakehouse interoperable en Snowflake
- Lakehouse entre nubes con Snowflake y Google Cloud
- Descubre más contenido de Snowflake en Google Cloud
Nota: Apache Iceberg, Apache Polaris y Apache Spark son marcas comerciales de Apache Software Foundation.