


Blog
Turbinando Scikit-Learn e Pandas no Snowflake com GPUs
Veja como agilizar os ciclos de desenvolvimento de modelos para scikit-learn, pandas, UMAP e HDBSCAN com GPUs. Sem necessidade de alteração de código.
Recurso
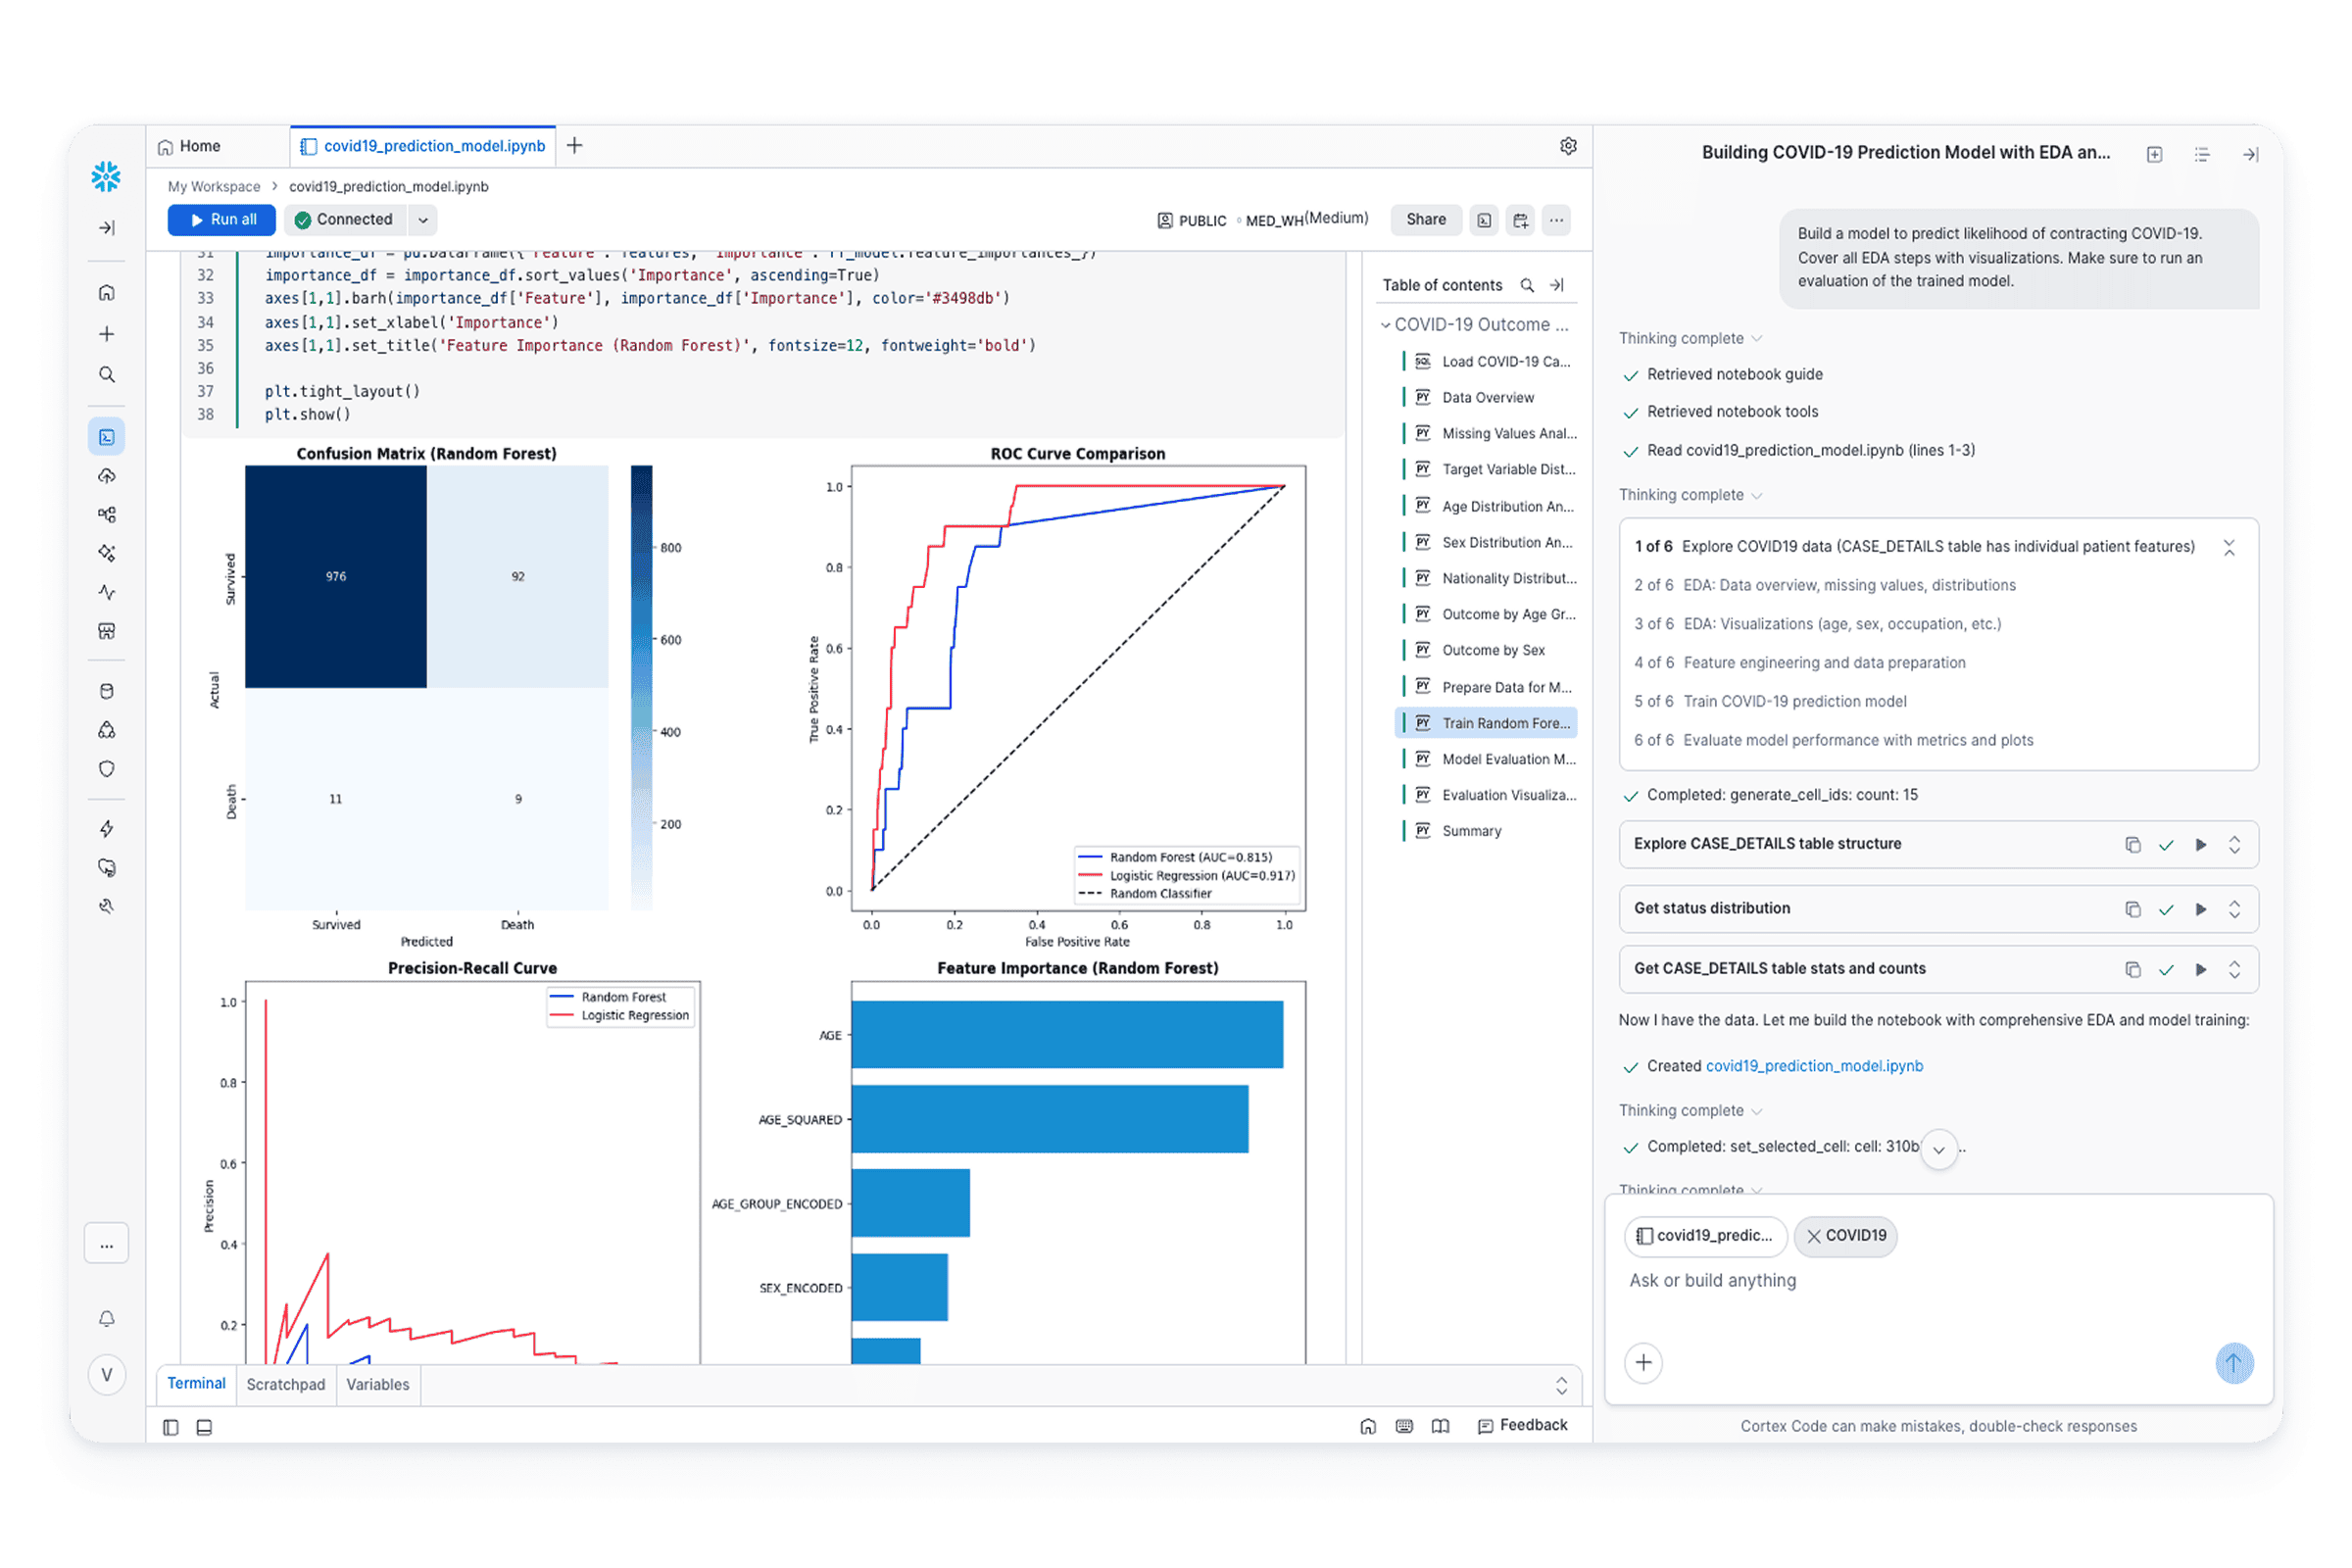
Use o Snowflake CoCo para transformar seus dados em insights preditivos, com mais rapidez. Crie pipelines de ML prontos para produção, em linguagem natural (exatamente onde seus dados governados residem).
Visão geral
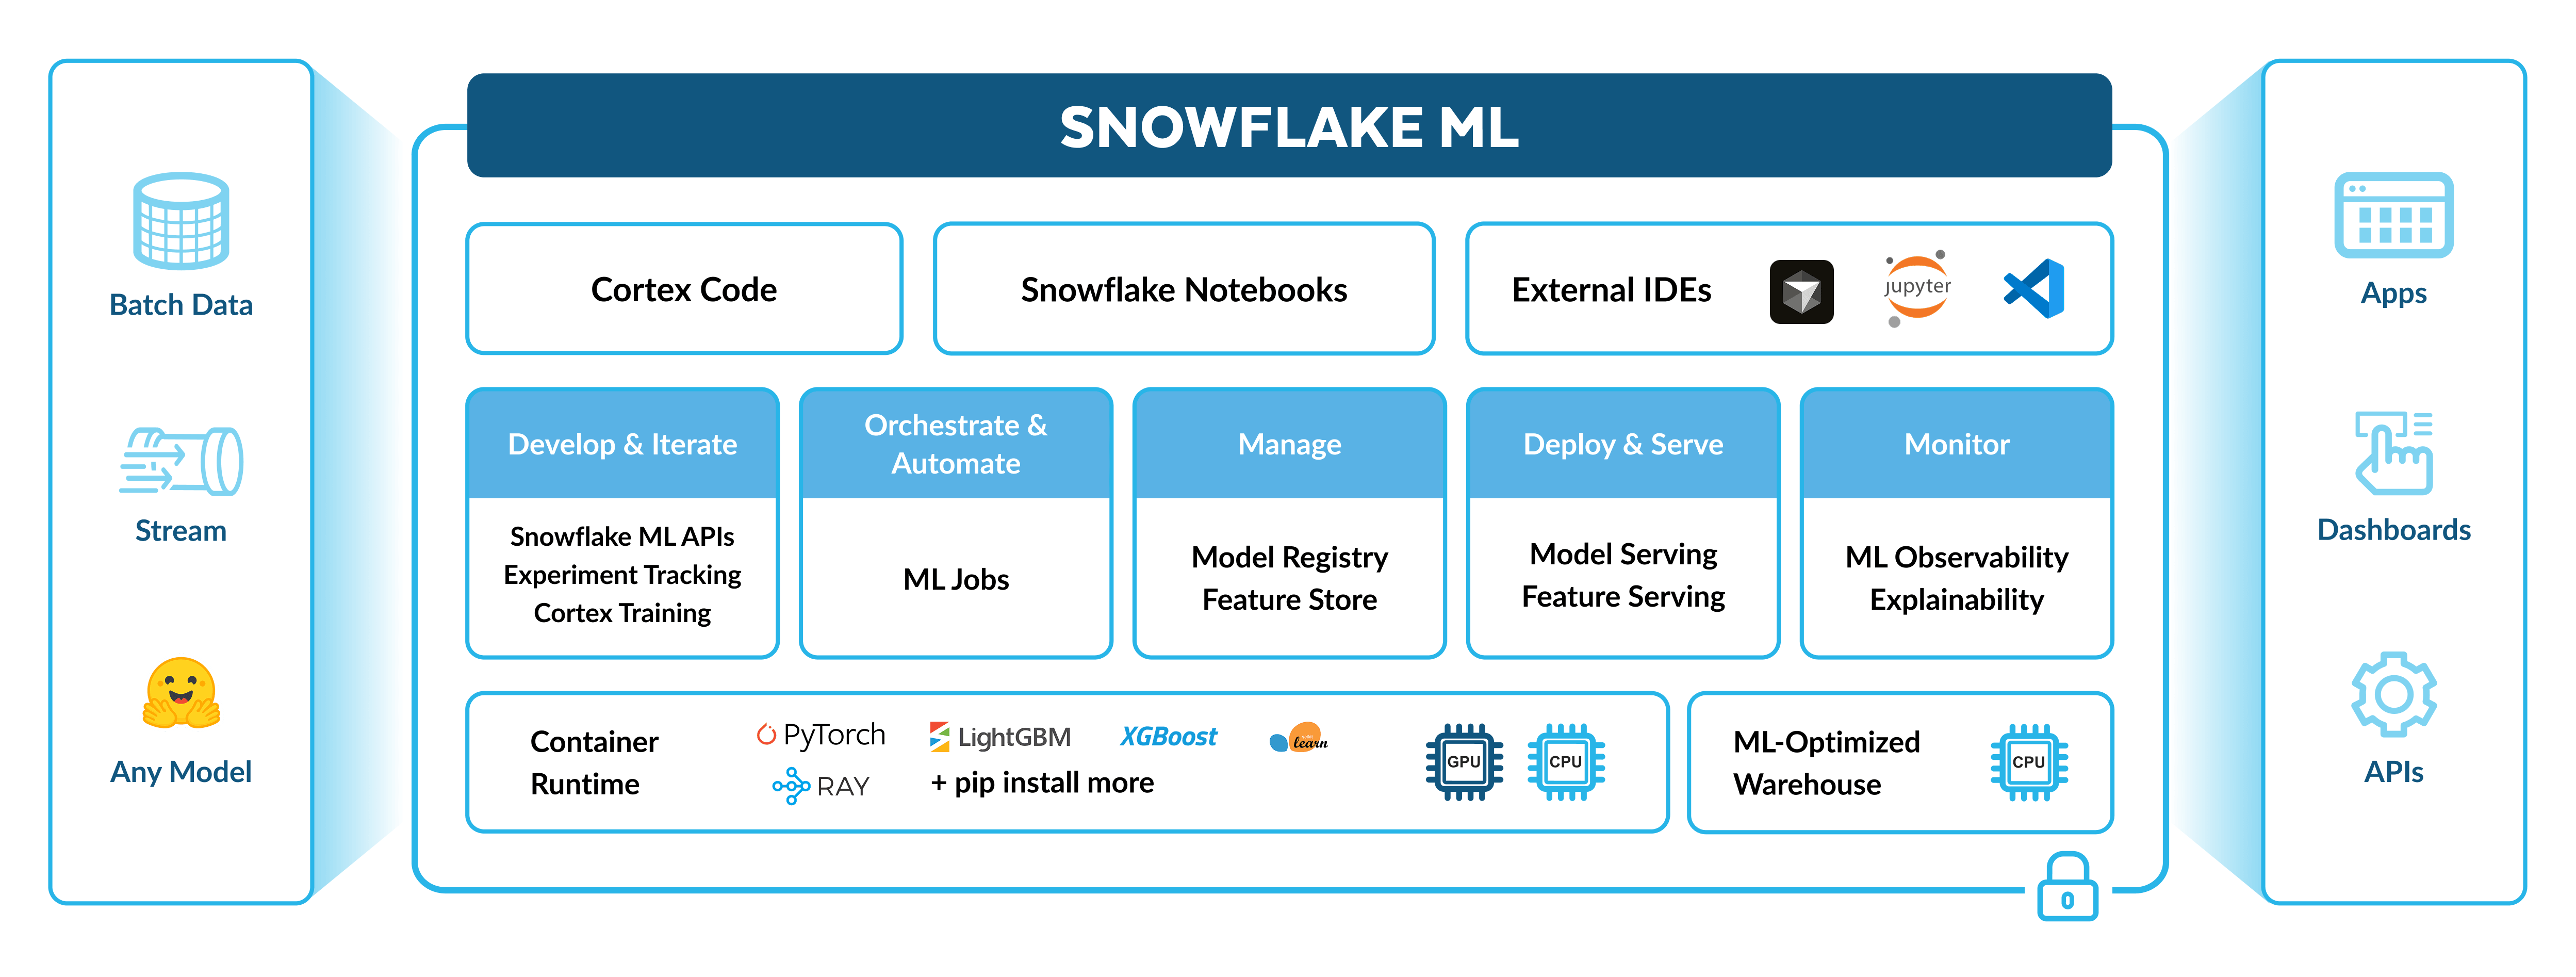
Agilize o ciclo de vida do modelo com pipelines automatizados de ML. Gere insights preditivos personalizados para sua empresa com contexto nativo em seus dados, recursos, modelos e notebooks, tudo em uma plataforma unificada e governada.

Unifique os fluxos de trabalho durante o desenvolvimento, a inferência e as operações onde seus dados já estão.

Distribua pipelines de ML entre CPUs e GPUs com otimizações integradas que aceleram o treinamento, a inferência em lote e em tempo real, sem precisar de ajustes manuais.

Descubra, gerencie e controle os recursos e modelos do Snowflake durante todo o ciclo de vida com linhagem centralizada e controle de acesso baseado em função (RBAC).


Fluxo de trabalho de ML
Desenvolvimento de modelos
Otimize a carga de dados e agilize o treinamento a partir do Snowflake Notebooks ou diretamente do VS Code usando a extensão de código VS do Snowflake ou por meio do Cursor.†
Use bibliotecas pré-instaladas, como XGBoost e PyTorch, ou use “pip install” a partir de hubs de código aberto, como PyPI e HuggingFace.
Personalize e treine modelos de base de peso aberto com o Cortex Training.*

Gerenciamento de recursos
Crie, gerencie e forneça recursos de ML com atualização contínua e automatizada de dados em lote ou de streaming, em menos de 20 milisegundos, usando o Snowflake Feature Store.
Facilite a descoberta, a reutilização e a governança de recursos durante o treinamento e a inferência.
Com facilidade, rastreie visualmente e procure por recursos em todo o pipeline por meio da interface de usuário integrada do Feature Store.
Gerenciamento de modelos
Registre modelos de qualquer origem no Snowflake Model Registry e disponibilize-os para previsões em lote ou em tempo real sobre dados do Snowflake, utilizando CPUs ou GPUs.
Ofereça serviço aos modelos em menos de 100 milissegundos para viabilizar casos de uso online de baixa latência, incluindo valor da vida útil do cliente e detecção de fraudes.


"Antes, treinar os modelos e gerar previsões levava meia hora. Com o modelo super-rápido e unificado no Snowflake, o processo leva poucos minutos para centenas de milhares de clientes. Essa agilidade libera recursos para previsão de cenários e simulações.”
Dan Shah
Manager of Data Science

"Ter tudo unificado dentro do Snowflake ML, trabalhar de modo contínuo sem precisar pensar em segurança ou governança, é um facilitador de produtividade."
Tuhin Ghosh
Head of Data Science, Platform Product Group, Coinbase
Conheça melhor os recursos integrados para desenvolvimento
e produção no Snowflake ML.
Por onde começar

ML de ponta a ponta
Tem dúvidas sobre Snowflake ML? Nós temos as respostas. Confira aqui algumas das perguntas mais comuns para ajudar você a entender como funciona e como começar.
Sim, pode. Cientistas de dados e engenheiros de ML podem criar e implementar modelos com processamento distribuído em CPUs ou GPUs. Isso é possível graças à infraestrutura moderna de contêineres baseada em Ray, que alimenta a plataforma Snowflake ML.
Sim, oferece. O Snowflake ML lida tanto com cargas de trabalho online e em lote. Para necessidades em tempo real, lojas de recursos e inferência de modelos estão disponíveis online para aprimorar casos de uso, incluindo recomendações personalizadas, detecção de fraudes, otimização de preços e detecção de anomalias.
Não, é possível trazer modelos de outras origens para executar em produção com base em dados do Snowflake. Durante a inferência, você pode usar os recursos integrados de MLOps, como observabilidade de ML e governança de RBAC.
É sim. O Snowflake ML é compatível com todas as bibliotecas de código aberto. Você pode acessar, com segurança, repositórios de código aberto por meio de comando pip e importar qualquer modelo de hub, como o Hugging Face.
A Snowflake adota um modelo de preços com base no consumo. Consulte a mais recente tabela de preços de créditos.
Sim, pode. Você pode testar qualquer um dos nossos quickstarts de ML diretamente durante o seu período de avaliação gratuita.


