14 oct 2026/5 min de lecturaProducto y tecnología
Por qué la observabilidad necesita un grafo de contexto

La observabilidad moderna genera enormes cantidades de telemetría, pero la telemetría por sí sola no explica cómo se relacionan las distintas partes de un sistema. Cuando se produce un incidente, lo más difícil no suele ser encontrar la alerta, sino entender qué ha ocurrido en los servicios, la infraestructura y las dependencias. El grafo de contexto de observabilidad de Observe by Snowflake cubre esa carencia al transformar la telemetría sin procesar en conjuntos de datos consultables que puedes interconectar. Así, cuando se produce un incidente, los usuarios pueden rastrear por qué ha fallado algo, no solo qué ha fallado.
El grafo de contexto es la capa arquitectónica de Observe que organiza la telemetría en un mapa conectado, lo que permite a los usuarios recorrer con rapidez todo el sistema para obtener información útil en lugar de examinar manualmente cada evento. Permite a los usuarios explorar visualmente las conexiones de sus datos sin procesar para ver qué ocurre en su entorno.
Obtén más información sobre Observe by Snowflake y descubre cómo transforma con rapidez la telemetría en información útil.
Componentes básicos del grafo de contexto: conjuntos de datos, enlaces y etiquetas de correlación
El grafo de contexto de observabilidad se sitúa sobre el data lakehouse, el destino único de todos tus datos de observabilidad. La interacción entre ambos es fundamental para que Observe ayude a los equipos a investigar con mayor rapidez.
En primer lugar, la telemetría sin procesar se envía desde la infraestructura externa al Telemetry Data Lakehouse mediante una integración o un recopilador. A continuación, Observe organiza y estructura estos datos en conjuntos de datos, que se conectan directamente mediante enlaces y también mediante etiquetas de correlación compartidas:
- Conjuntos de datos: Observe estructura la telemetría entrante en conjuntos de datos, como registros de Kubernetes, métricas de Prometheus y spans de trazas. Los conjuntos de datos de recursos identifican recursos concretos (objetos virtuales o físicos, como pods y contenedores de Kubernetes, usuarios, productos y carritos de compra) mediante una clave principal, que puede contener un campo o una combinación de campos.
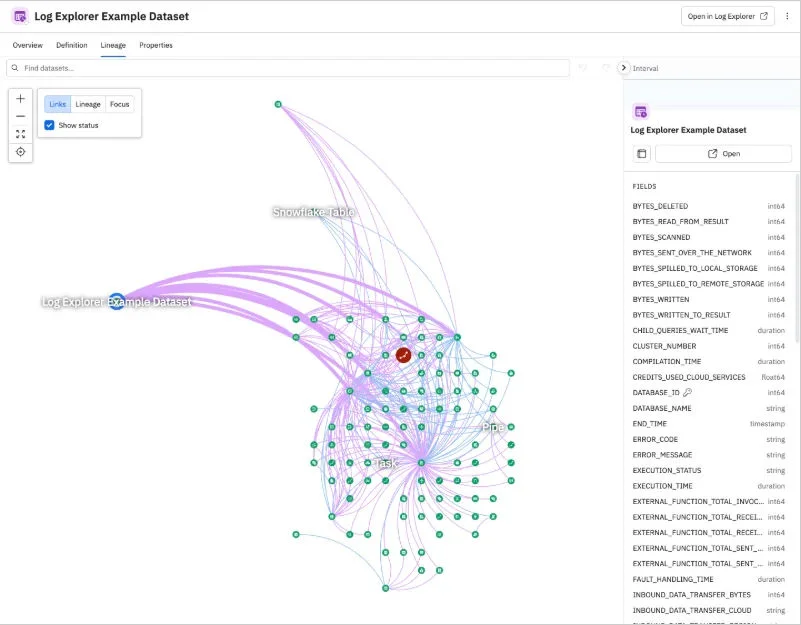
- Los enlaces conectan conjuntos de datos: Los enlaces de claves principales y externas conectan conjuntos de datos según la identidad de los recursos. Por ejemplo, un recurso de pod puede vincularse al nodo en el que se ejecuta. Lineage muestra una relación diferente entre conjuntos de datos: qué conjuntos de datos se utilizaron para crear otro conjunto de datos. Puedes explorar estas relaciones mediante las vistas Links, Lineage y Focus, que se describen brevemente más adelante.
- Las etiquetas de correlación conectan datos de distintos conjuntos de datos: Las etiquetas de correlación marcan campos, como “cluster.name” o “service.name”, que representan el mismo concepto en distintos conjuntos de datos. Cuando varios campos comparten una etiqueta de correlación, Observe puede utilizar valores coincidentes para encontrar datos relacionados. Muchas etiquetas se aplican automáticamente según las convenciones admitidas. Estas etiquetas, en las que se pueden realizar búsquedas, también ayudan al ingeniero de fiabilidad de sitios con IA (AI SRE) de Observe a asociar un término como “apiserver” con los datos correctos.
En conjunto, estas conexiones forman el grafo de contexto de observabilidad: los conjuntos de datos son sus “nodos”, y los enlaces y el linaje entre ellos son sus “aristas”. Las etiquetas de correlación añaden una capa complementaria para navegar entre conjuntos de datos mediante conceptos compartidos. Los enlaces, el linaje y las etiquetas permiten investigar conjuntos de datos conectados en lugar de examinar cada uno por separado.
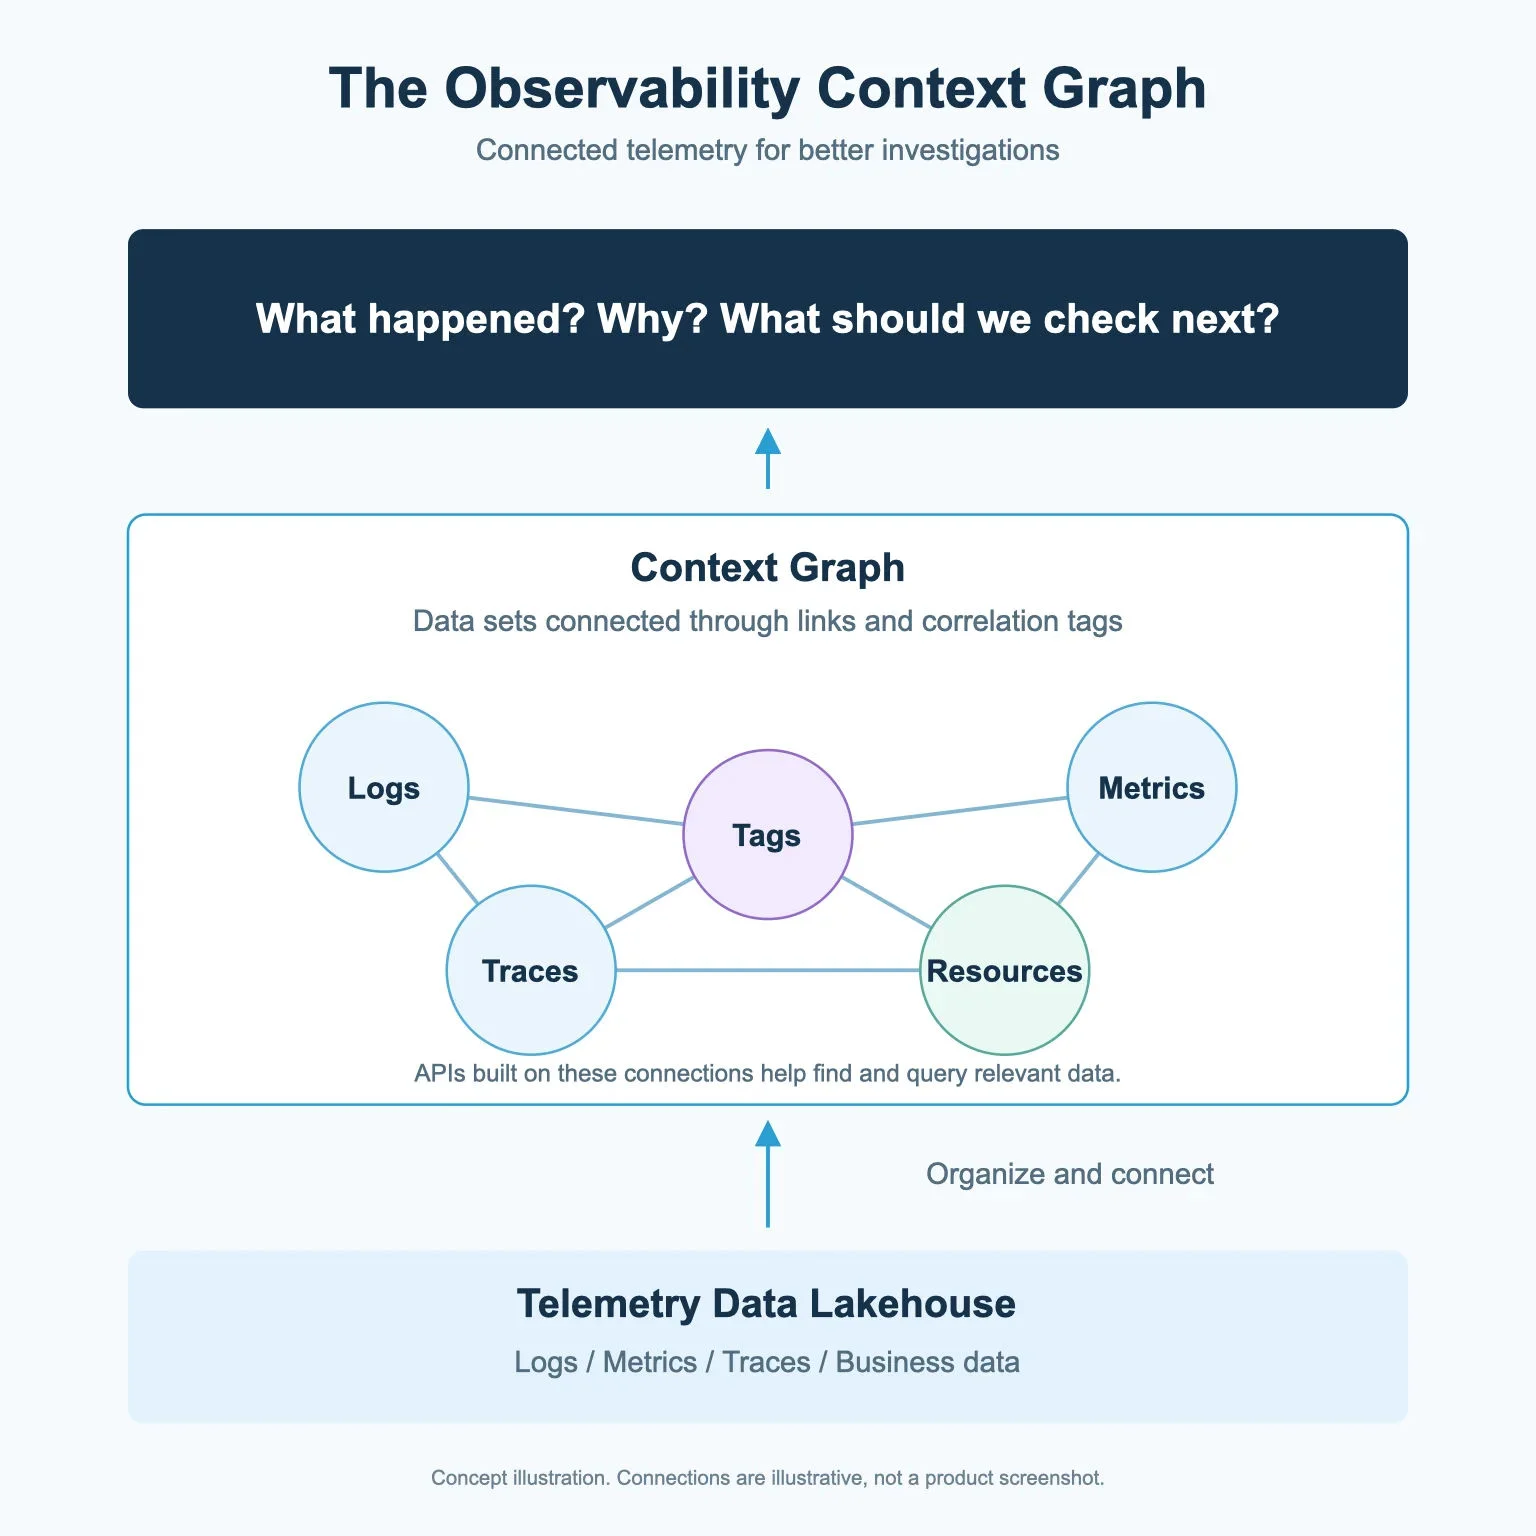
El AI SRE utiliza estas conexiones para encontrar datos relevantes y ayudar a los equipos a investigar por qué ha fallado algo, no solo qué ha fallado. ¿Por qué dejó de funcionar el servicio de pagos a las 3 de la madrugada? ¿Qué impacto tuvo la última implementación en los clientes que dependen de él? ¿Tenemos que aumentar el número de nodos después de implementar la última característica? El grafo de contexto de observabilidad aporta el contexto necesario para investigar estas cuestiones y reduce el trabajo que, de otro modo, los equipos tendrían que realizar manualmente para correlacionar eventos y recursos.
Cómo explorar visualmente las conexiones del grafo de contexto de observabilidad
El grafo de contexto funciona en segundo plano, pero puedes acceder a los datos en los que se basa mediante la interfaz de usuario de Observe.
En la página del conjunto de datos, puedes inspeccionar el esquema, las propiedades, las etiquetas de correlación y las relaciones de un conjunto de datos. Las vistas Links y Focus muestran las conexiones entre conjuntos de datos, mientras que la vista Lineage indica cómo se han derivado los conjuntos de datos. Observe también dispone de una página independiente de gestión de etiquetas en la que puedes ver todas las etiquetas de correlación en un mismo lugar. Estas vistas ayudan a los usuarios a inspeccionar las relaciones entre conjuntos de datos y rastrear el origen de los datos.
Cómo convierte el grafo de contexto de observabilidad las conexiones en respuestas mediante API
El grafo de contexto se puede consultar mediante API que recorren las mismas conexiones que lo forman: conjuntos de datos, enlaces y etiquetas de correlación. Estas API ayudan a los agentes a identificar servicios y recursos, encontrar datos relacionados y utilizar los resultados para continuar una investigación.
El grafo de contexto es una superficie para agentes; como no se trata simplemente de una interfaz de usuario, las API del grafo deben ser fáciles de usar para los agentes. Están diseñadas para devolver respuestas precisas y pertinentes con rapidez, sin utilizar tokens innecesarios.
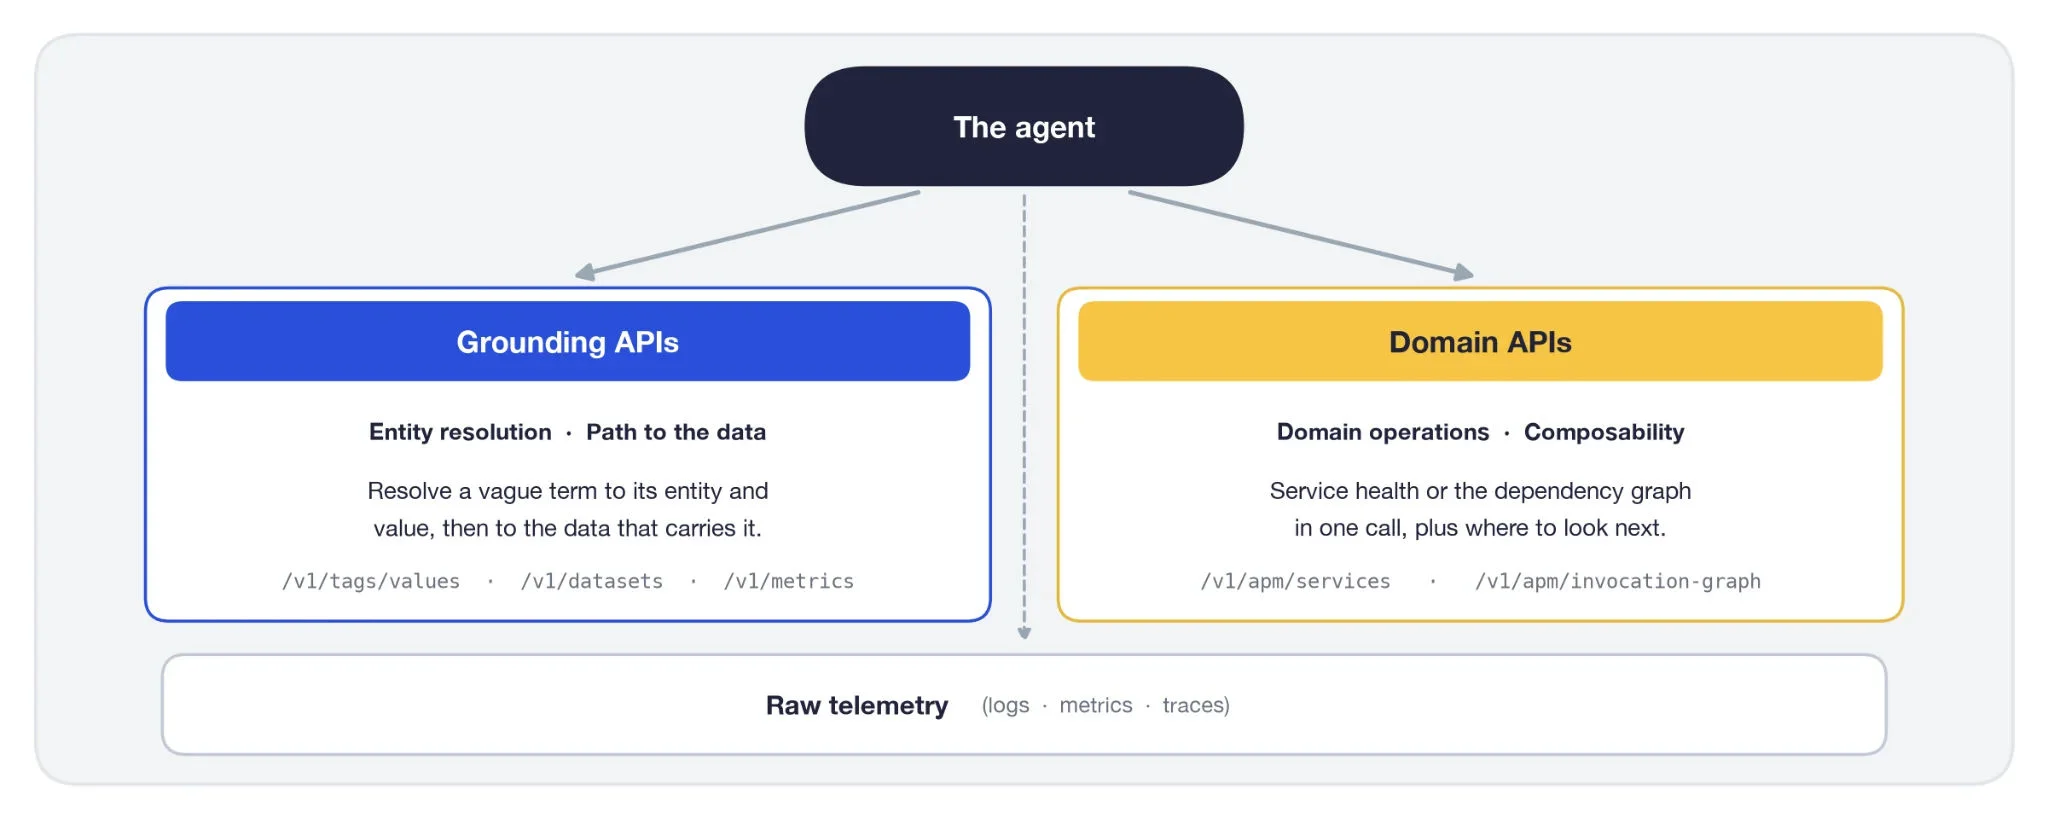
Mientras que las vistas Links, Lineage y Focus permiten explorar manualmente esas conexiones, las API permiten recorrer el grafo mediante código o dejar que el AI SRE de Observe lo haga en tu nombre. Esto permite consultar el grafo.
Un recorrido (traversal) avanza por el grafo del mismo modo que lo haría una investigación. Comienza con un término (“payments”, “apiserver”) y utiliza la API “search tag values” para traducirlo a los valores de las etiquetas de correlación que identifican el servicio o recurso: las mismas etiquetas que vinculan ese concepto entre distintos conjuntos de datos. A partir de ahí, las API “list of data sets” y “list metrics” ayudan a localizar los conjuntos de datos y las métricas asociados a él. Como las etiquetas de correlación son metadatos en los que se pueden realizar búsquedas, esto funciona incluso cuando un entorno contiene miles de ellas.
El grafo también incorpora directamente conocimientos especializados sobre observabilidad, por lo que las investigaciones habituales no requieren volver a ensamblar manualmente la telemetría sin procesar. Una sola llamada a la API “list APM services with RED metrics” puede devolver la tasa, los errores y la duración de un servicio, mientras que la API “invocation graph” representa las relaciones de llamadas entre servicios. Como cada respuesta remite al conjunto de datos, la métrica y el intervalo temporal en los que se basa, el siguiente paso de la investigación es específico en lugar de una búsqueda a ciegas.
Empezar a utilizar Observe by Snowflake
Para aprovechar las ventajas del grafo de contexto de observabilidad, primero debes incorporar los datos de infraestructura al Telemetry Data Lakehouse. Recomendamos utilizar Observe Agent para recopilar tus datos, aunque también puedes usar integraciones personalizadas o un recopilador de OpenTelemetry existente.
Explora Observe by Snowflake para descubrir cómo la telemetría conectada agiliza las investigaciones.

