24. Aug. 2026/Lesezeit: 8 MinutenData Engineering
Einfaches Streamen zu Apache Iceberg mit Snowpipe Streaming
Umfassende Streaming-Evaluierung ohne Infrastrukturaufwand
Wenn ein Team herausfinden möchte, ob Snowpipe Streaming bei über 1 Mio. TPS standhält, sucht es den kürzesten Weg zu einer echten Antwort. Streaming im großen Maßstab hat einen gewissen Ruf. Es ist der Workload, den Teams aufschieben, da die Einrichtung S3-Buckets, einen EKS-Cluster, Kafka-Topics, IAM-Richtlinien, eine Sicherheitsüberprüfung und die Freigabe von drei Plattform-Teams erfordert, die jeweils ihre eigenen Backlogs haben. Diese Einrichtung kann zusätzliche Infrastrukturbereitstellung und Koordination erfordern, bevor die Tests beginnen. Zu beweisen, dass diese Pipelines in diesem Maßstab funktionieren und das Produktionsvolumen bewältigen, ist normalerweise ein eigenes Projekt.
In unserer Demo-Umgebung konnten wir diese Evaluierung an einem Nachmittag einrichten und durchführen. Sie können unsere Snowpipe Streaming High-Performance Architecture nutzen, um Daten mit über 1 Mio. TPS in das Apache Iceberg™-Format zu streamen, und zwar vollständig innerhalb der Snowflake-Infrastruktur. Ein Container, der in Snowpark Container Services (SPCS) ausgeführt wird, generiert die Last, leitet sie über das SDK als Streams weiter und speichert sie in einer von Snowflake verwalteten Apache Iceberg-Tabelle. Dadurch können die Daten sofort in Snowflake abgefragt werden, wobei Role-Based Access Control (RBAC), Lineage und Maskierung bereits beim Eintreffen angewendet werden. In unserer Testumgebung haben wir die Demo eingerichtet, End-to-End getestet, den Durchsatz gemessen und sie an einem Nachmittag wieder abgebaut, genau wie in unserem Test.
Dieser Beitrag zeigt Ihnen, wie Sie mithilfe dieses GitHub-Repos eine End-to-End-Demo für das Streaming zu Iceberg erstellen. Dieses Beispiel ist in Python, aber Sie können die SDK-Optionen (Java, Python, Node, REST) testen, sodass Sie dies Ihrem Unternehmen mit echten Ergebnissen glaubwürdig empfehlen können.
Architekturdiagramm: Das Muster
Wir wollten eine Demo erstellen, bei der alles innerhalb der Snowflake-Infrastruktur ausgeführt wird. Mehrere Docker-Container, die in Snowpark Container Services (SPCS) ausgeführt werden, generieren synthetische Testdaten mit den gewünschten Transaktionen pro Sekunde und streamen sie mithilfe des Snowpipe Streaming SDK. Sie landen in einer von Snowflake verwalteten Apache Iceberg-Tabelle: offenes Format, innerhalb von Sekunden nach dem Eintreffen abfragbar, in Snowflake verwaltet. Die Authentifizierung ist einfach: SPCS fügt ein kurzlebiges OAuth-Token in den Container ein, das dem Streaming SDK mitteilt, es zu verwenden. Sie müssen keine Secrets verwalten.
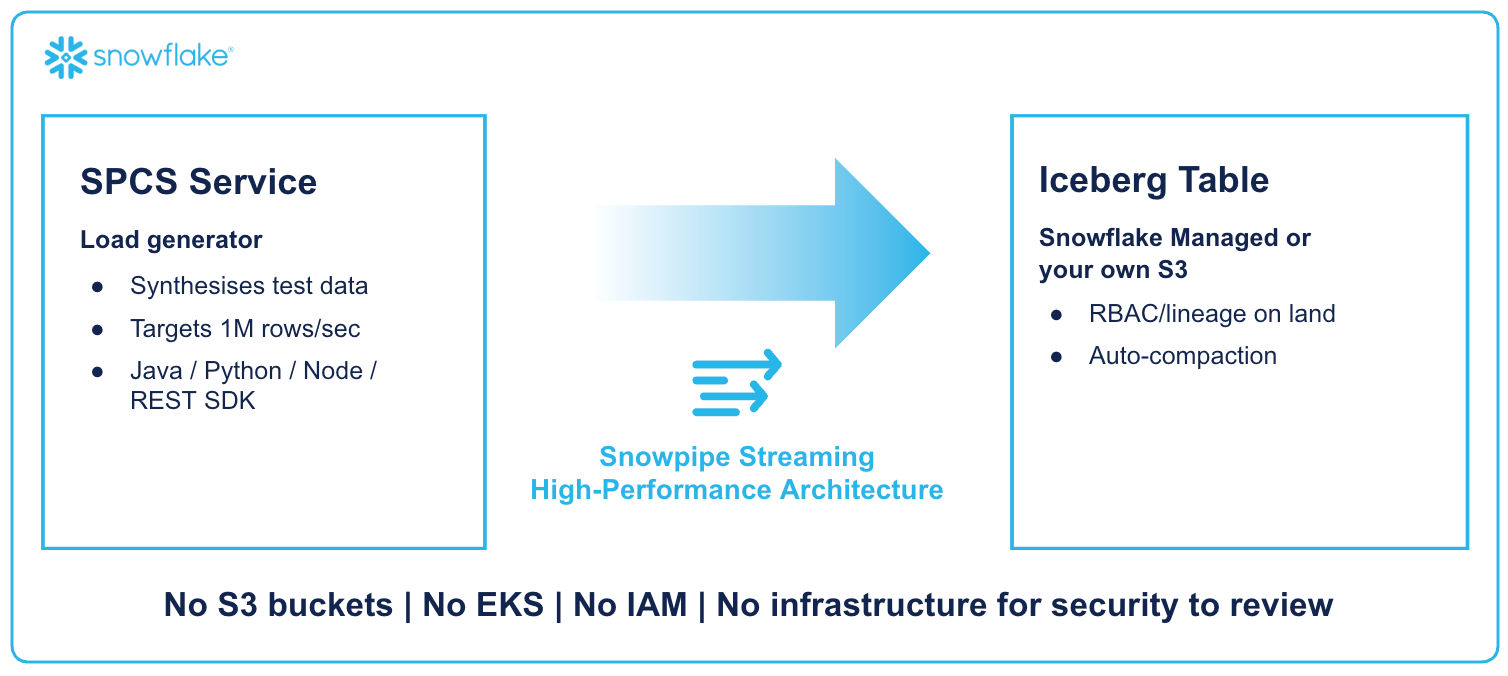
Warum SPCS zur Generierung der Last?
Um es klar zu sagen: Snowpipe Streaming benötigt SPCS nicht. Das SDK läuft überall: auf Ihrem Laptop, einer EC2-Instanz, einem Kubernetes-Pod.
Die Bereitstellung in SPCS bringt Sie schneller zum Test, da der Dienst vollständig auf einer Infrastruktur ausgeführt wird, die Snowflake bereits verwaltet, ohne dass für den Test selbst etwas Neues bereitgestellt oder zusätzliche Freigaben verwaltet werden müssen.
Direktes Speichern in Iceberg
Das Ziel ist eine von Snowflake verwaltete Apache Iceberg-Tabelle. Zeilen strömen über das SDK ein und landen als Parquet mit Iceberg-Metadaten, verwaltet von Snowflake. Verweisen Sie später auf Ihr eigenes externes S3-Volume, wenn Sie möchten, oder lassen Sie es nach der Evaluierung verwaltet. Der Code bleibt in beiden Fällen gleich.
Für die Evaluierung bedeutet dies weniger Einrichtungsaufwand. Eine Tabelle im von Snowflake verwalteten Speicher überspringt das externe Volume, die Speicherintegration und die Cloud-Speicherberechtigungen, die Sie andernfalls zuerst konfigurieren müssten.
Wenn Sie bereit für die Produktion sind, haben Sie drei klare Wege:
- Von Snowflake verwaltetes Iceberg mit einem externen Volume: Parquet-Dateien werden in Ihrem S3-Bucket gespeichert. Eine externe Engine liest die Parquet-Dateien direkt aus S3 und verwendet den Horizon REST Catalog für Metadaten.
- Von Snowflake verwaltetes Iceberg auf Snowflake-Speicher: Die Dateien befinden sich im internen Speicher von Snowflake. Diese Option vermeidet die Konfiguration eines externen Volumes und des zugehörigen Cloud-Speichers. Nutzt Iceberg-Funktionen für zukünftige Kompatibilität.
- Native Snowflake-Tabelle: Für diese Konfiguration ist keine separat verwaltete externe Speicherinfrastruktur erforderlich.
Demo: Sehen Sie es in Aktion
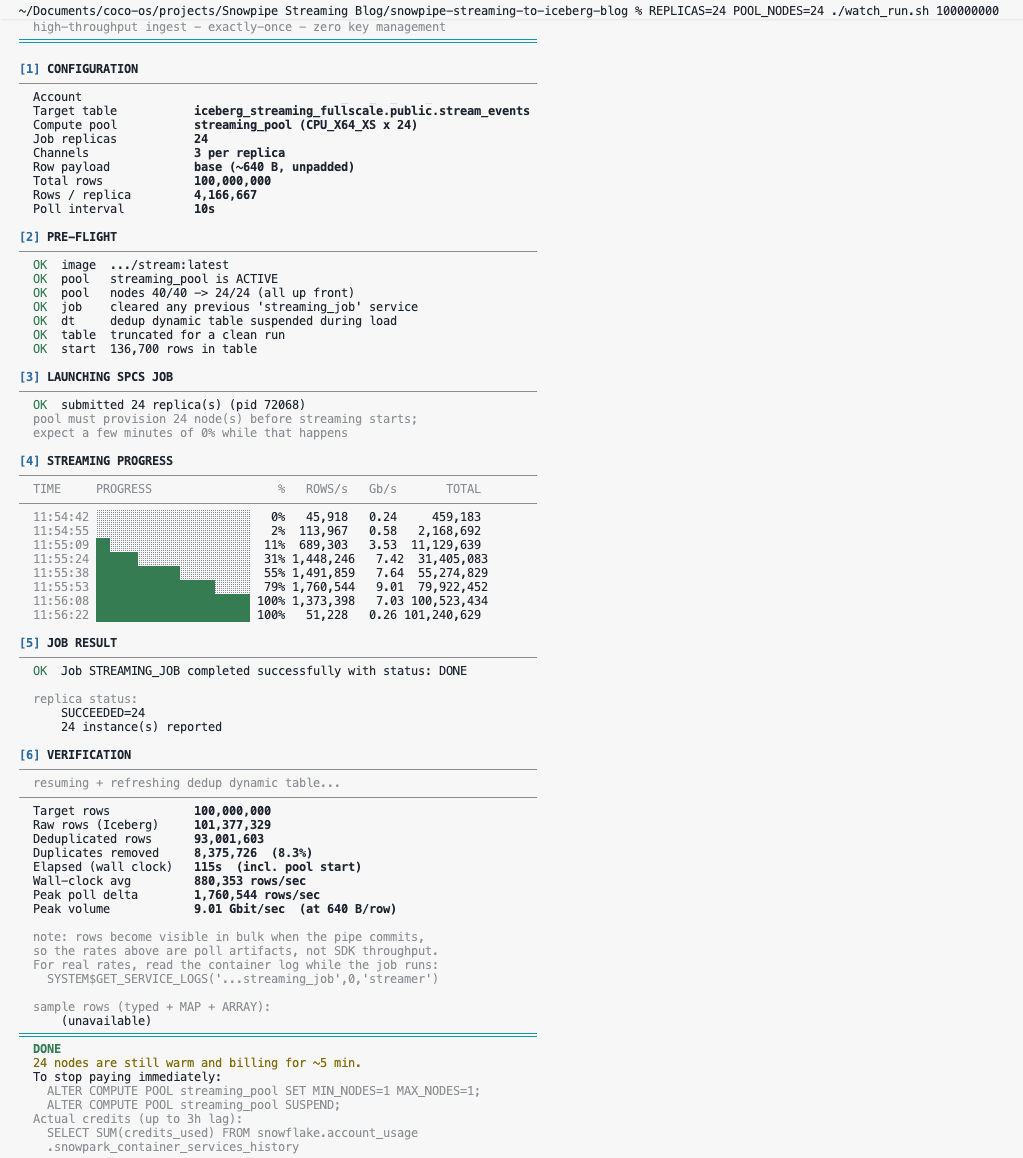
Wenn Sie das Demo-Skript ausführen, können Sie sehen, wie der SPCS-Dienst startet, der Producer mit der Generierung der Last beginnt und der Consumer sie als Streams in die Apache Iceberg-Tabelle leitet.
Sie können zu Snowsight wechseln und sehen, wie die Zeilenanzahl auch hier steigt – Millionen von Zeilen, die abfragbar sind, sobald sie eintreffen.
Der Code: Selbst erstellen
Um zu verstehen, wie das alles funktioniert, finden Sie hier etwas Pseudocode zur Veranschaulichung. Der vollständige Code befindet sich im Repo, und unten sind mehrere alternative Demos verlinkt.
Beginnen Sie mit einer von Snowflake verwalteten Apache Iceberg-Tabelle und einer Pipe:
-- 1. The target table
CREATE OR REPLACE ICEBERG TABLE events (
    event_id STRING,
    event_ts TIMESTAMP_NTZ,
    payload  VARIANT
)
CATALOG = 'SNOWFLAKE'
BASE_LOCATION = 'events/'
ICEBERG_VERSION = 3;


-- 2. The streaming pipe (extracts typed fields from the SDK's VARIANT payload)
CREATE OR REPLACE PIPE events_pipe
AS COPY INTO events (event_id, event_ts, payload)
FROM (
    SELECT $1:event_id::STRING,
           $1:event_ts::TIMESTAMP_NTZ,
           $1:payload::VARIANT
    FROM TABLE(DATA_SOURCE(TYPE => 'STREAMING'))
);
Die High-Performance-Architektur von Snowpipe Streaming unterstützt sowohl v2 als auch v3, aber wenn der Parameter weggelassen wird, wird die Tabelle standardmäßig auf v2 gesetzt.
Als Nächstes der Consumer:
from snowflake.ingest.streaming import StreamingIngestClient


# SPCS injects credentials automatically - no keys, no secrets
props = {
    "account": "YOUR_ACCOUNT",
    "user": "YOUR_USER",
    "role": "STREAMING_SERVICE_ROLE",
    "url": "https://YOUR_ACCOUNT.snowflakecomputing.com",
    "authorization_type": "SPCS",
    "spcs_token_path": "/snowflake/session/token",
}


# Connect to the pipe
client = StreamingIngestClient(
    client_name="my_consumer",
    db_name="STREAMING_DEMO",
    schema_name="PUBLIC",
    pipe_name="events_pipe",
    properties=props,
)


# Open a channel and stream rows
channel, status = client.open_channel("ch_1")


for i, row in enumerate(generate_load()):
    channel.append_row(row, offset_token=str(i))


# Close cleanly
channel.close()
client.close()
Dann stellen Sie den Consumer mit einer kurzen Dienstspezifikation in SPCS bereit. Und Sie sehen zu, wie es ankommt:
SELECT
COUNT(*) AS rows_landed,
MAX(event_ts) AS latest_event
FROM
streaming_demo.public.events;
Java, Node und die REST-Schnittstelle folgen demselben Muster: Kanal öffnen, Zeilen einfügen, leeren. Im Repo gibt es für jedes ein funktionierendes Beispiel, sodass Sie testen können, was zu Ihrem Stack passt.
Um dies selbst auszuprobieren, können Sie sich das Repo ansehen.
Beachten Sie jedoch, dass das Streaming SDK einen separaten Ingest-Endpunkt über HTTPS verwendet. Selbst wenn Sie innerhalb von Snowflake arbeiten, müssen Sie eine externe Zugriffsintegration gewähren, die den ausgehenden Datenverkehr zurück zu *.snowflakecomputing.com zulässt.
Best Practices
Snowpipe Streaming übernimmt das Batching für Sie
Snowpipe Streaming schreibt nicht eine Datei pro Zeile. Das SDK sendet Zeilen, sobald Sie appendRows aufrufen, aber eine serverseitige Pufferschicht nimmt sie auf und entscheidet selbst über den Commit-Zeitpunkt, wobei im Hintergrund ein Batching durchgeführt wird, sodass Sie nie eine Datei pro Zeile senden.
Darüber hinaus führt Snowflake automatische Komprimierung im Hintergrund für von Snowflake verwaltete Iceberg-Tabellen durch, bei denen Snowflake der einzige Schreiber ist: Kleine Parquet-Dateien werden zu größeren zusammengeführt, und kleine Manifeste werden ebenfalls komprimiert. Sie müssen es nicht planen oder ausführen; es ist in den normalen Betrieb integriert.
Was Sie tun können:
- Zeilen clientseitig im Batch verarbeiten, bevor
appendRowsaufgerufen wird: Das Senden einzelner Zeilen bedeutet immer noch einen Roundtrip pro Zeile; das Zusammenfassen in einem einzigen Aufruf amortisiert diesen Overhead – dasselbe Prinzip, das hinter Snowflakes eigener Empfehlung steht, Daten zu komprimieren und mehr Daten pro Anfrage zu senden. - Kanäle langlebig halten: Öffnen Sie einen Kanal einmal pro Quellpartition und lassen Sie ihn für die Dauer des Jobs geöffnet, anstatt ihn pro Micro-Batch zu öffnen und zu schließen. Dies ist die dokumentierte Best Practice von Snowflake für Snowpipe Streaming, und sie reduziert den Overhead, ohne das bereits im Hintergrund stattfindende Batching zu beeinträchtigen.
- Legen Sie
TARGET_FILE_SIZEfür die Tabelle fest: Dies ist eine Eigenschaft auf Tabellenebene, unabhängig vom SDK, die Snowflake mitteilt, welche Größe sowohl für neue Schreibvorgänge als auch für die Hintergrundkomprimierung angestrebt werden soll, unabhängig davon, wie die Daten dorthin gelangt sind. - Lassen Sie den Durchsatz die Arbeit machen: Je höher Ihre anhaltenden TPS sind, desto schneller füllt und leert sich der serverseitige Puffer von selbst, was effektiv zu einem Kompromiss zwischen Durchsatz und Latenz für eine bestimmte Dateigröße führt.
Was kommt: Iceberg v4
Snowpipe Streaming und automatische Komprimierung lösen das physische Problem kleiner Dateien, aber häufige Commits können dennoch Overhead im Metadaten-Baum von Iceberg verursachen. Jeder Commit schreibt derzeit ein neues Metadaten-JSON, eine Manifestliste und ein Manifest – selbst wenn er nur eine kleine Datei enthält. Für Workloads, die alle paar Sekunden committen, kann diese wiederholte Metadaten-Arbeit zum Engpass werden.
Der Vorschlag für Iceberg v4 führt einen adaptiven Metadaten-Baum ein, um diese Schreibverstärkung zu reduzieren. Anstatt für jeden kleinen Commit ein neues Manifest zu erstellen, kann das Root-Manifest diese Commits inline einfügen. Ein einzelner Parquet-Schreibvorgang und ein atomarer Zeigeraustausch ersetzen die aktuelle Kette, wodurch die Metadaten-E/A pro Commit konstant bleibt, anstatt mit der Anzahl der Manifeste zu skalieren. Bei hochfrequenten Streaming-Workloads kann dies die Streaming-Latenz drastisch verbessern.
Streaming ist eines der Hauptszenarien für Iceberg v4: Workloads, die alle paar Sekunden committen, legen die Metadaten-Schreibverstärkung direkt offen, was die Vorteile des adaptiven Metadaten-Baums besonders relevant macht. Die v4-Spezifikation entwickelt sich noch weiter, aber es lohnt sich, sie im Auge zu behalten, wenn Iceberg-Streaming auf Ihrer Roadmap steht. Snowflake ist stolz darauf, sich aktiv an der Gestaltung der Zukunft des Formats zu beteiligen.
Was dies für Ihre Architektur bedeutet
In diesem Beitrag haben wir gezeigt, wie effektiv Snowpipe Streaming in Iceberg sein kann. Bei der Art von Last, mit der eine ernsthafte Medien- oder Telekommunikationsplattform betrieben wird, ohne dass für dieses Test-Setup ein S3-Bucket, ein EKS-Cluster, ein Kafka-Topic oder eine IAM-Rolle erforderlich war, lief der Workload innerhalb von Snowflake und konnte nach der Evaluierung wieder abgebaut werden.
Die Infrastruktur, die normalerweise zwischen einem Team und einem Streaming-Test steht – die Buckets und Cluster sowie Authentifizierungen und Freigaben –, ist keine Voraussetzung. Sie können die Frage „Erfüllt dies unsere Anforderungen?“ schnell beantworten.
Wenn Sie im Bereich Site Reliability Engineering (SRE) oder Data Engineering einer großen Medien- oder Telekommunikationsplattform tätig sind und Iceberg-Streaming auf der Roadmap steht, beginnen Sie mit dem Test, nicht mit dem Beschaffungszyklus. Wir laden Sie ein, das Repo zu klonen, in SPCS bereitzustellen und es in Aktion zu sehen.
- Probieren Sie es jetzt mit dem GitHub-Repo aus
- Erfahren Sie mehr, indem Sie die Dokumentation zur High-Performance-Architektur von Snowpipe Streaming lesen