16. Sept. 2026/Lesezeit: 7 MinutenData Engineering
Ein einfacherer Weg von Datenproduzenten zu Snowflake: Elastic Channels unterstützen bis zu 20 GB/s
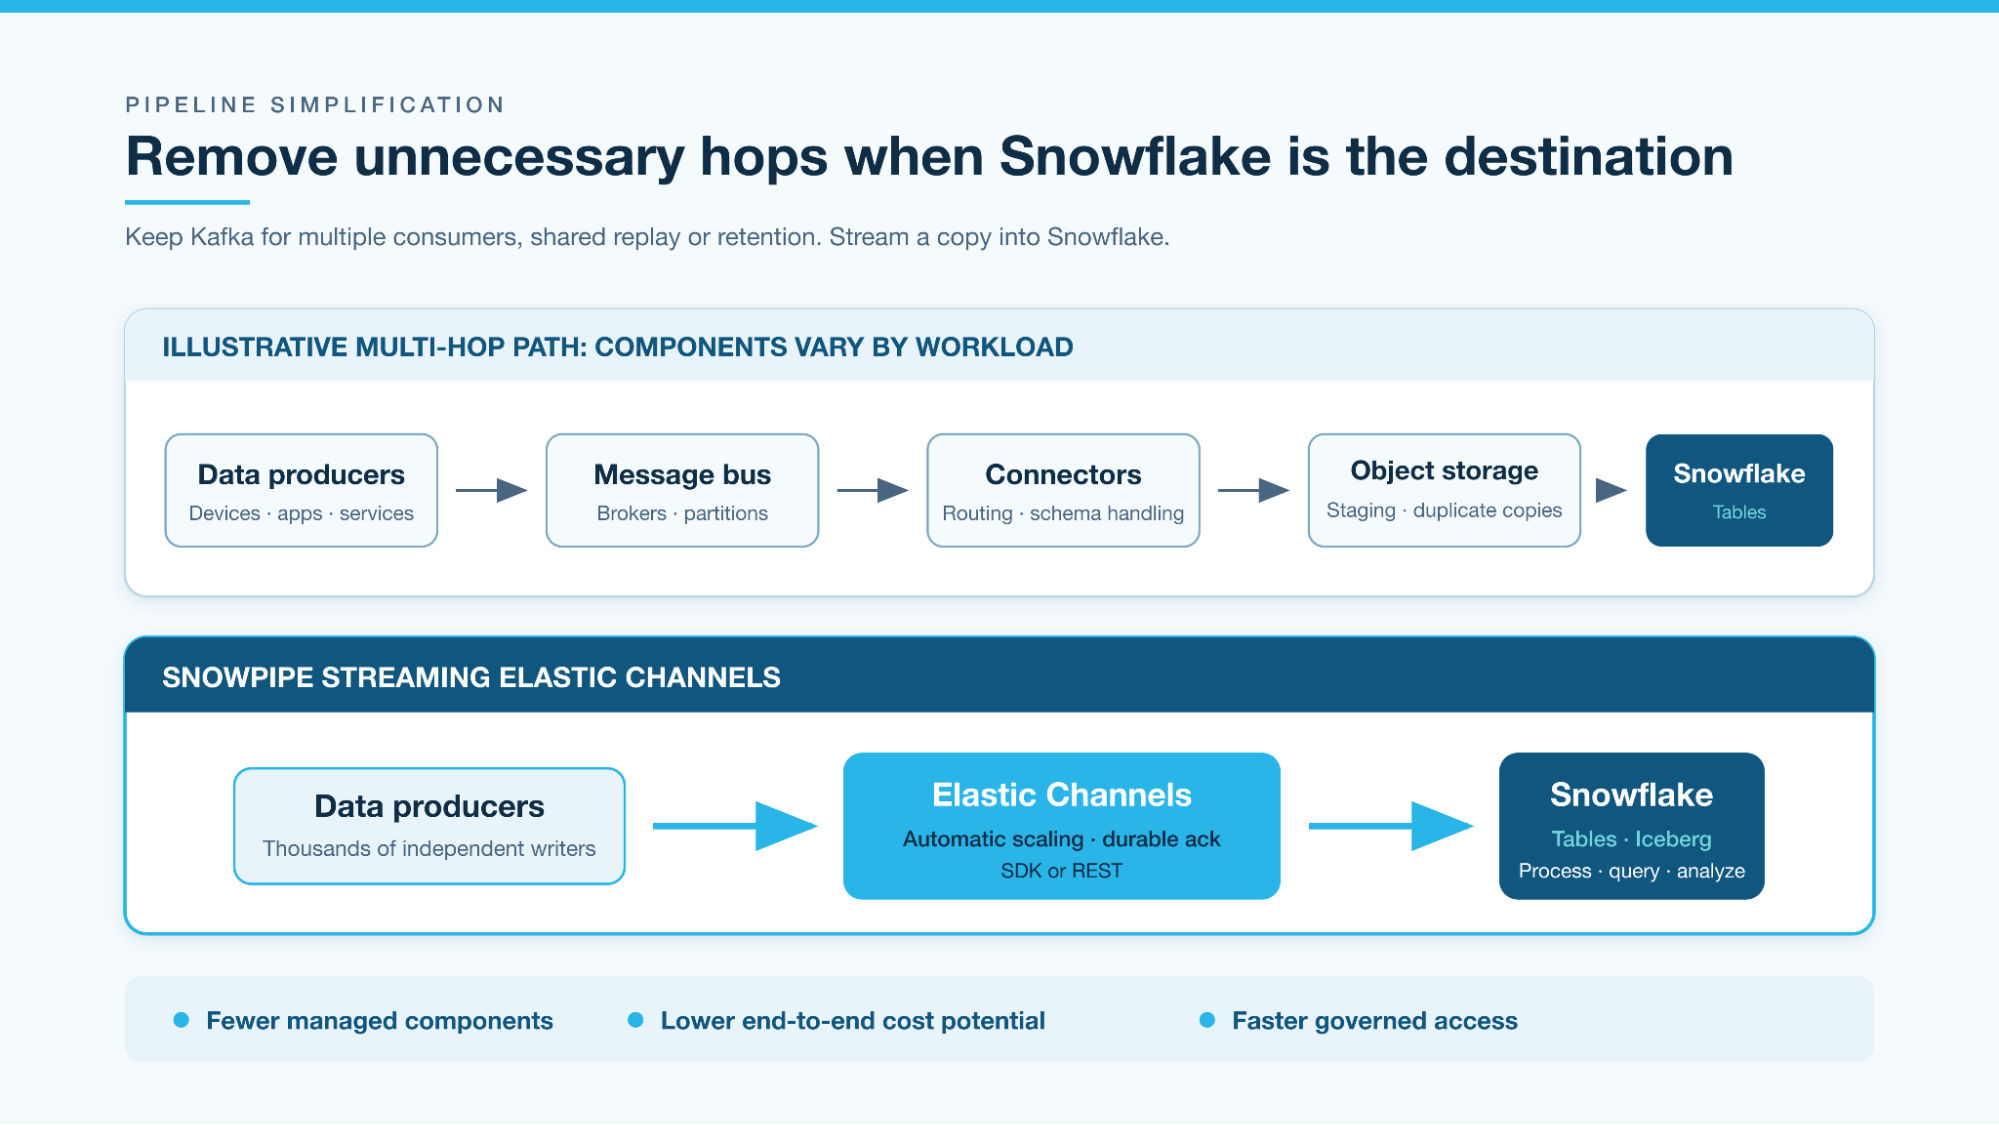
Heute geben wir die allgemeine Verfügbarkeit von Elastic Channels für Snowpipe Streaming bekannt. So können Daten ganz einfach direkt von Anwendungen, Geräten und Diensten in Snowflake-Tabellen oder von Snowflake verwaltete Apache IcebergTM-Tabellen übertragen werden. Teams können Erfassungssysteme entfernen, die nur zum Ablegen von Daten dienen. Das vereinfacht den Betrieb, reduziert Latenzzeiten und senkt potenziell die Gesamtbetriebskosten.
Für Unternehmen, die vernetzte Produkte, Industriesysteme und digitale Anwendungen ausführen, ist diese Einfachheit wichtig. Geräte senden kontinuierlich Telemetrie, Anwendungen generieren Benutzerereignisse und Dienste können unabhängig voneinander skaliert werden. Um diese Signale für Analytics und KI verfügbar zu machen, braucht es ein Erfassungssystem, das nahezu so komplex ist wie die Anwendungen, die sie erzeugen.
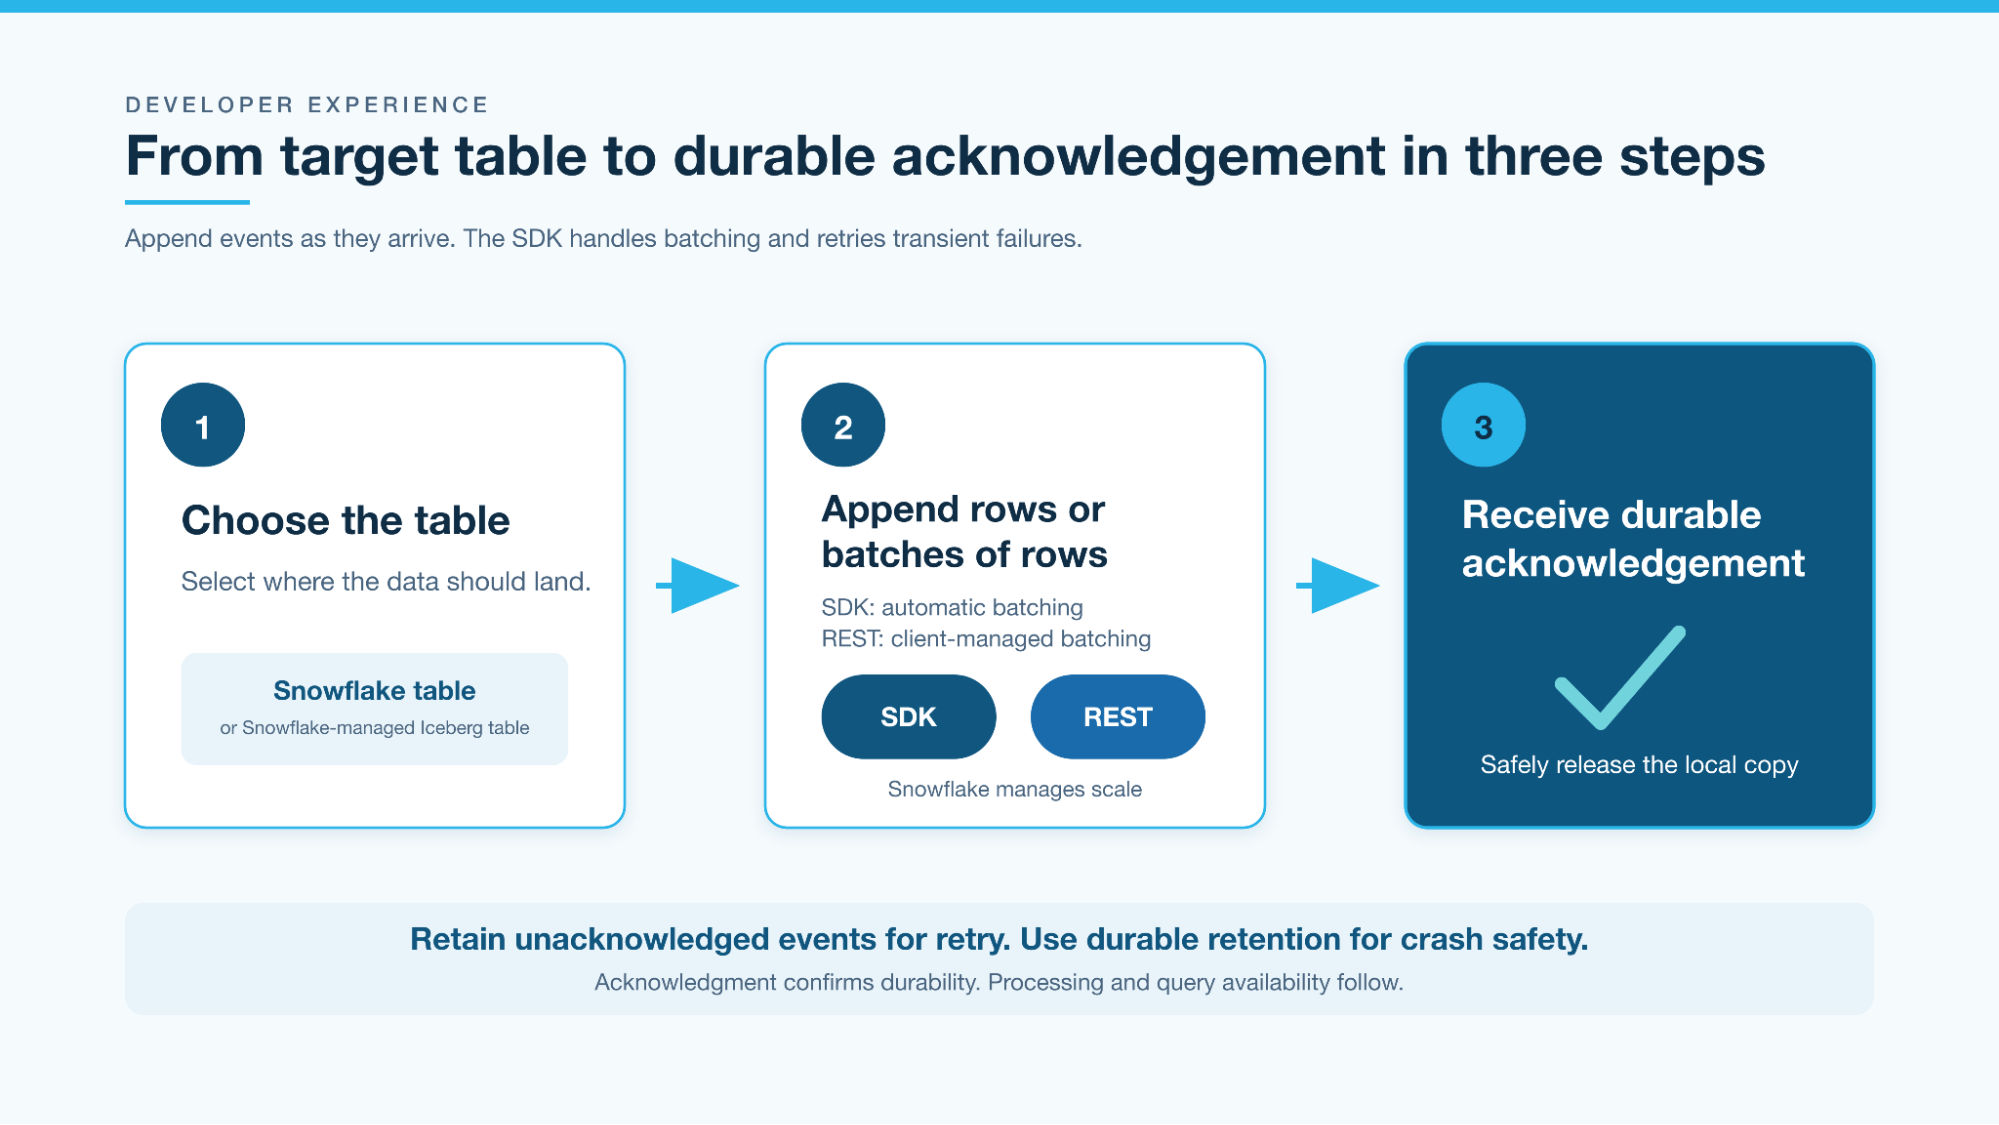
Elastic Channels vereinfachen diese Arbeit: Wählen Sie eine Zieltabelle aus, hängen Sie Zeilen oder Stapel von Zeilen an und erhalten Sie eine dauerhafte Bestätigung, wenn Snowflake die Daten dauerhaft gespeichert hat, bevor die Daten jedoch in der Tabelle abgefragt werden konnten. Das SDK fügt automatisch Batches an und wiederholt vorübergehende Ausfälle, während Snowflake die Skalierung der Datenerfassung und den Kanallebenszyklus verwaltet. Dadurch ist ein separater Nachrichtenbus oder eine Staging-Pipeline nur zum Ablegen von Daten in Snowflake weniger erforderlich.
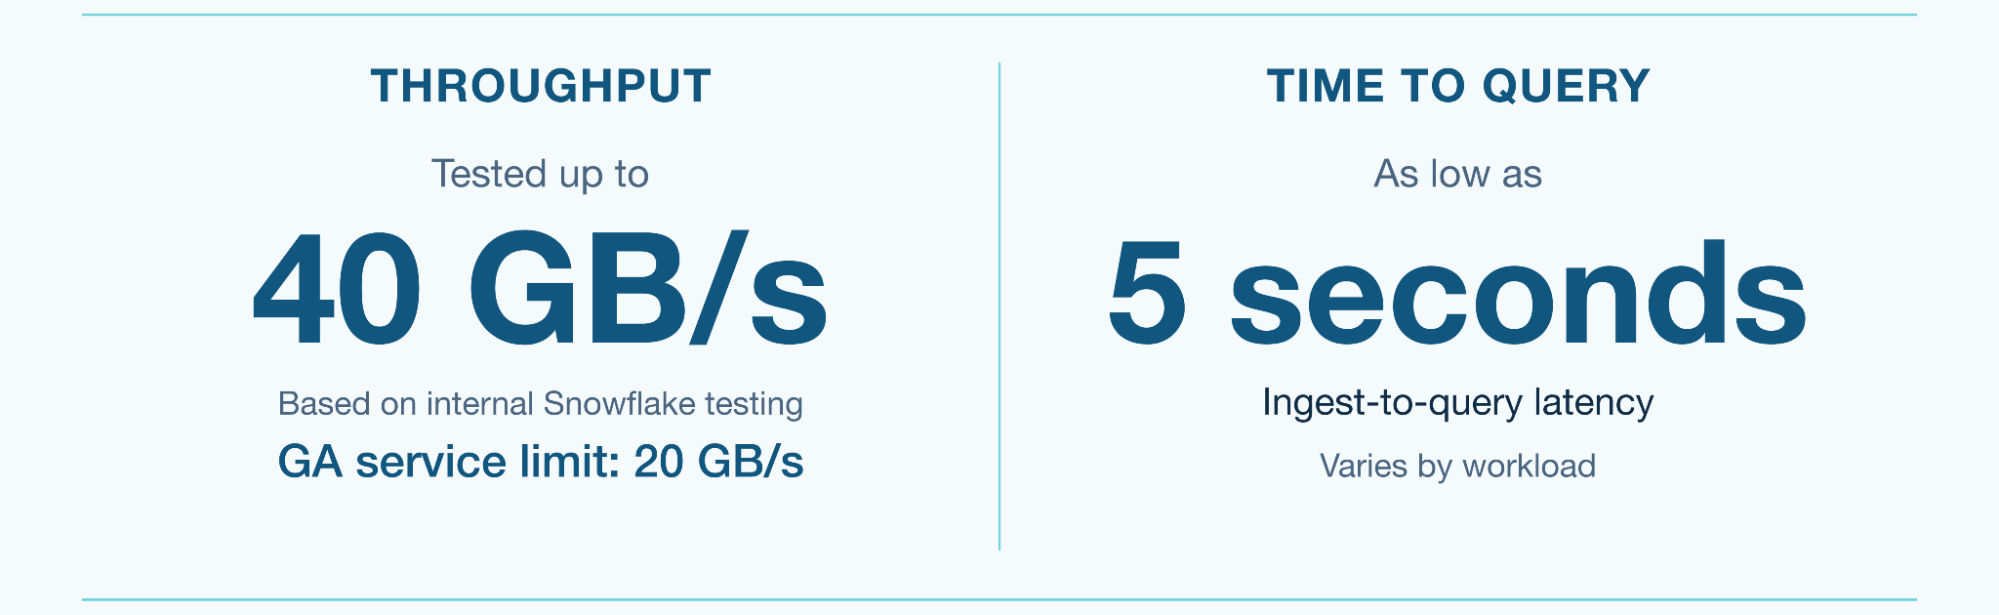
Diese einfachere Erfahrung unterstützt auch anspruchsvolle Workloads. Bei allgemeiner Verfügbarkeit unterstützen Elastic Channels bis zu 20 GB/s pro Tabelle.. Je nach Workload können die Daten in nur 5 Sekunden abgefragt werden. In internen Tests konnten wir den Durchsatz weiter steigern und erreichten bis zu 40 GB/s in einer einzigen Tabelle. Im nächsten Beitrag werden wir diese Benchmark-Ergebnisse vorstellen und herausfinden, wie wir sie gemessen haben. Ein dritter Beitrag befasst sich mit der Architektur und dem Design hinter Elastic Channels.
Wenn Sie mehr erfahren oder mit Elastic Channels beginnen möchten, besuchen Sie unsere Dokumentation zu Elastic Channels.
Von der Kundenherausforderung zum direkten Datenpfad
Snowflake hat Elastic Channels gemeinsam mit Kunden entwickelt, die vor zwei unterschiedlichen Streaming-Herausforderungen stehen. Yuvital, das ein Application Framework für Belohnungen und Anreize für Unternehmen bietet, hat Elastic Channels getestet, um seine Pipelines zu vereinfachen und User Analytics und Clickstream-Ereignisse direkt in Snowflake zu streamen. HighByte, ein führender Anbieter von Industrial DataOps-Software, benötigte eine einfachere Möglichkeit, Tausende von Verbindungen zu unterstützen und Industrie- und IoT-Daten nahezu in Echtzeit direkt in Snowflake zu streamen. Diese Designpartner veranschaulichen die Notwendigkeit einer einfacheren Erfassung sowohl für digitale Anwendungen als auch für industrielle Systeme.
Elastic Channels vereinfachen die Datenerfassung, da mehrere Systeme, die nur zum Verschieben von Daten in eine Tabelle existieren, weniger benötigt werden. Wenn Sie einen Nachrichtenbus wie Kafka bereits für mehrere Verbraucher, gemeinsame Wiedergabe oder Beibehaltung verwenden, können Sie ihn behalten und eine Kopie über unsere Named Channels in Snowflake streamen.
Mit Elastic Channels erstellen Kunden eine Zieltabelle, verbinden Produzenten über ein SDK oder eine REST-API und beginnen, Zeilen anzuhängen. Snowflake übernimmt den serverseitigen Erfassungspfad, wenn Flotten und Datenverkehr wachsen.
„Bei Yuvital nutzen wir Belohnungen und Anreize, um Organisationen dabei zu helfen, ihre Mitglieder einzubinden und ein gesünderes Verhalten zu fördern. Wir generieren einen kontinuierlichen Strom von Aktivitäten und Interaktionsereignissen der Mitglieder, die wir in Snowflake zusammenführen, um diese Aktivitäten zu verstehen, Erlebnisse zu personalisieren und fundierte Geschäftsentscheidungen zu treffen. Wir haben Confluent als schnellsten Weg genutzt, um Append-only-Ereignisse in Snowflake abzulegen, aber es war viel zu komplex und teuer für ein so einfaches Ziel. Mit Elastic Channels mussten wir nur wenige Zeilen Code hinzufügen und konnten sofort damit beginnen, Ereignisse direkt aus unserem Node.js-Backend zu senden, was die Erweiterung extrem unkompliziert gemacht hat.“
Yaron Levi
Chief Architect and Co-Founder, Yuvital
Einfach für Produzenten, langlebig für das Unternehmen
Elastic Channels wurden für Workloads entwickelt, bei denen viele unabhängige Produzenten ein Ziel teilen:
- Ein gemeinsamer Aufnahmepfad: Produzenten schreiben über einen einzigen impliziten Elastic Channel für die Ziel-Pipe und die Tabelle.
- Keine Herstellerkoordination: Anwendungen weisen keine Aufnahmekanäle zu, verfolgen oder gleichen sie nicht aus, wenn sich Flotten und Datenverkehr ändern.
- Automatische serverseitige Skalierung: Snowflake verteilt den Workload auf die Anzahl der Produzenten und deren Datenverkehr.
- Dauerhafte Bestätigung: Ein Produzent erhält eine Bestätigung, nachdem Snowflake die übermittelten Daten dauerhaft innerhalb des Erfassungsdienstes gespeichert hat.
Nach Erhalt der Bestätigung kann der Hersteller sein behaltenes Exemplar freigeben, Snowflake hat die Daten dauerhaft gespeichert. Verarbeitung und Abfrageverfügbarkeit folgen. Quittierung bedeutet nicht, dass jede Zeile die nachgelagerte Verarbeitung durchlaufen hat. Die Latenzzahl oben misst die Aufnahme- bis Abfragezeit, nicht die Quittierungszeit.
Produzenten sollten nicht bestätigte Ereignisse für eine Wiederholung bereithalten. Bei Ausfällen können sie den Dateneingang anhalten oder, wenn die Erfassung fortgesetzt werden muss, eine vorhandene Outbox oder einen dauerhaften Puffer auf Produzentenebene verwenden. Für ein ausfallsicheres Vorhalten, speichern Sie Ereignisse dauerhaft, bevor Sie die Verantwortung dafür übernehmen, und entfernen Sie sie nach Bestätigung. Der Speicherpuffer des SDK ist kein persistenter Spool.
Teams können Snowflake als gemeinsames, elastisches Ziel für Betriebsdaten über eine Flotte oder einen Anwendungsbestand hinweg betrachten, anstatt Koordinationslogik in jedem Produzenten zu entwickeln.
Von kontinuierlichen Daten zu Geschäftsergebnissen
Dasselbe Direct-Insight-Modell gilt überall dort, wo eine große Anzahl von Produzenten kontinuierlich Daten generiert:
- Vernetzte Produkte und IoT: Überwachen Sie den Zustand von Geräten und Netzwerken in großen Flotten, verkürzen Sie den Weg von der Telemetrie zur Produktintelligenz und integrieren Sie neue Produzenten, ohne Kanäle pro Gerät zuzuweisen.
- Branchenbetrieb: Bringen Sie Maschinen- und Werkssignale in Snowflake ein, um Anomalien schneller zu erkennen, vorausschauende Wartung und Betriebsoptimierung zu ermöglichen.
- Sicherheit und Beobachtbarkeit: Streamen Sie Protokolle, Kennzahlen, Spuren und Verhaltensereignisse von verteilten Agenten, um die Bedrohungserkennung und Reaktion auf Vorfälle zu beschleunigen.
- Digitale Anwendungen: Erfassen Sie Clickstream- und Produktereignisse von unabhängig skalierbaren Services, um Personalisierung, Experimente und Kundenanalytik nahezu in Echtzeit zu unterstützen.
„Der HighByte Intelligence Hub hilft Herstellern dabei, Daten von Maschinen, Sensoren und industriellen Systemen am Edge zu erfassen, zu kontextualisieren und in Snowflake nutzbar zu machen. Mit Elastic Channels können Kunden den Durchsatz erhöhen und die Verwaltung vereinfachen, indem sie kontinuierliche Datenströme über gemeinsame Erfassungspfade senden, ohne Kanäle über einzelne Fabriken und Produzenten hinweg koordinieren zu müssen. Dauerhafte Bestätigungen sind für Industriedaten, bei denen Datenverlust inakzeptabel ist, besonders wichtig. Sie ermöglichen es Kunden, Daten am Edge zuverlässig zu puffern und an Snowflake zu übermitteln, sobald die Verbindung wiederhergestellt ist.“
Jeffrey Schroeder
Director of Product Management, HighByte
Flexible Semantik ohne unnötige Komplexität
Snowpipe Streaming kann je nach Anwendungsfall verschiedene Streaming-Funktionen bereitstellen. Elastic Channels bieten At-Least-Once-Delivery ohne Reihenfolge (Ordering). Abrufe oder Wiedergaben können Duplikate erzeugen, verwenden Sie also stabile Ereignis-IDs, wenn es auf Deduplizierung ankommt. Die vorhandenen Named Channels von Snowpipe Streaming bedienen Workloads, die pro Kanal bestellt und genau einmal geliefert werden müssen. Wählen Sie das Aufnahmemodell, das den Anforderungen Ihrer Anwendung entspricht.
Nativ zur Snowflake-Datenplattform
Die Daten kommen direkt in Snowflake an, wo Unternehmen einheitliche Zugriffskontrollen, Governance, Transformation, Analytics und KI-Funktionen anwenden können. Durch das Entfernen von Transitebenen können Duplikate reduziert und der Zeitraum verkürzt werden, in dem sich Betriebsdaten außerhalb der Governance-Grenzen der Plattform befinden.
Wählen Sie die für Ihre Anwendung geeignete Clientschnittstelle und Zieltabelle:
- Python-, Java- und Node.js-SDKs: Ereignisse direkt beim Eintreffen anhängen. Das SDK fügt automatisch Batches mit Zeit- und Größenschwellenwerten an und wiederholt vorübergehende Fehler. Anwendungen kontrollieren, wie viele Daten noch unbestätigt bleiben, und warten periodisch auf die Bestätigung der Haltbarkeit.
- REST-API Ideal für kompakte Services, Edge-Anwendungen, serverlose Funktionen, Webhooks und Sprachen ohne dediziertes SDK. Direkte REST-Clients verwalten das Batching und die Komprimierung von NDJSON. Eine erfolgreiche Antwort bestätigt die dauerhafte Akzeptanz.
- Aufnahmeziele: Snowflake-Tabellen und von Snowflake verwaltete Iceberg-Tabellen.
Wählen Sie eine Tabelle aus, hängen Sie Zeilen oder Stapel von Zeilen an und erhalten Sie eine dauerhafte Bestätigung. Das SDK übernimmt das Batching des Transports; das Codebeispiel unten zeigt ein einzelnes Anhängen und eine Bestätigung.
Elastic Channels und dauerhafte Bestätigungen sind allgemein in allen kommerziellen Regionen von AWS, GCP und Azure verfügbar.
Elastische Kanäle können ohne zusätzliche Kosten genutzt werden. Snowpipe Streaming wird auf der Grundlage der eingespeisten unkomprimierten Daten mit 0,0037 Credits pro GB abgerechnet. Weitere Details finden Sie in der Snowpipe Streaming-Dokumentation unter „Erfahren Sie mehr über Ihre Kosten“.
Erste Schritte mit Snowflake CoCo
Beginnen Sie damit, CoCo um Hilfe beim Aufbau einer Elastic Channels-Pipeline zu bitten.
Bitten Sie CoCo, „mir beim Einstieg in Snowpipe Streaming Elastic Channels mit der neuesten Dokumentation zu helfen“ https://docs.snowflake.com/en/user-guide/snowpipe-streaming/data-load-snowpipe-streaming-overview
CoCo kann das Grundgerüst für die Snowflake-Objekte, das Authentifizierungsprofil, den Produzentencode und die Verifizierungsschritte erstellen.
Dieses minimale Python-Beispiel veranschaulicht einen Anhang und eine Bestätigung. Produktionsanwendungen behalten unbestätigte Ereignisse bei und warten an Durability-Checkpoints statt nach jeder Zeile:
from datetime import datetime, timezone
from snowflake.ingest.streaming import StreamingIngestClient

client = StreamingIngestClient.from_table(
    client_name="sensor_producer",
    db_name="MY_DATABASE",
    schema_name="MY_SCHEMA",
    table_name="SENSOR_READINGS",
    profile_json="profile.json",
)

channel = client.get_elastic_channel()
ack = channel.append_row_with_wait({
    "DEVICE_ID": 1,
    "READING_TS": datetime.now(timezone.utc),
    "TEMPERATURE": 21.5,
})
ack.result()  # Data has been durably accepted by Snowflake.
Sie können auch:
- Besuchen Sie unsere Dokumentation, um mehr über Snowpipe Streaming zu erfahren und mit Elastic Channels zu beginnen
- Entdecken Sie die Beispielanwendungen von Snowpipe Streaming für Python, Java und Node.js.
- Besuchen Sie unseren offiziellen Quick Start Guide
Erstellen Sie eine Tabelle, verbinden Sie einen Produzenten, hängen Sie Zeilen oder Stapel von Zeilen an und lassen Sie Snowflake die Skalierung der Datenerfassung und den Kanallebenszyklus verwalten.