25. Sept. 2026/Lesezeit: 6 MinutenProdukt & Technologie
Customer Journeys bei Capital One: Observability von den geschäftlichen Auswirkungen bis zur Fehlerursache
Ein Vorfall beginnt mit Symptomen: zum Beispiel ein Anstieg von 500er-Fehlern, eine Latenzverschlechterung oder ein Rückgang der Conversions. Die ersten Fragen lassen nicht lange auf sich warten: Was ist kaputtgegangen und wie sind die Kund:innen davon betroffen?
Herkömmliche Observability setzt auf der Service-Ebene an, nicht bei den Auswirkungen auf die Kund:innen. Dashboards leuchten rot auf, Warnmeldungen werden ausgelöst und Teams arbeiten sich von Infrastruktur- und Anwendungssignalen nach außen vor, um gleichzeitig die Auswirkungen auf die Kund:innen abzuschätzen und die Fehlerursache zu isolieren. Diese Übersetzung von Infrastruktursignalen in geschäftliche Auswirkungen hängt oft von internem Wissen ab: Welche Services steuern den Checkout oder stehen hinter der Kontoübersicht? Um eine einfache Frage der Geschäftsführung wie „Wie viele Personen können sich nicht anmelden?“ zu beantworten, muss sich ein Team in einem Breakout-Raum versammeln, um die Auswirkungen abzuschätzen, und diese Schätzung dann während des Postmortems abgleichen.
Capital One geht in seinem Blogbeitrag „Observability with Automated Customer Journey Graphs“ direkt auf diese Lücke ein. Der Ansatz dreht die Untersuchung um: Beginnen Sie auf der Ebene der Kundeninteraktion und arbeiten Sie sich dann durch die Service- und Infrastrukturebenen nach unten. Wenn eine Untersuchung mit der bereits definierten Geschäftsinteraktion beginnt, sind die Auswirkungen klar und der Weg zur Schadensbegrenzung und Fehlerursache rückt in den Mittelpunkt.
Zu diesem Zweck hat Capital One Customer-Journey-Graphen erstellt, in denen Knoten Kundeninteraktionen darstellen und Kanten zeigen, wie sich Nutzer:innen durch die Experience bewegen. Integritätssignale und Traffic werden über den Graphen gelegt, wodurch er zu einer operativen Oberfläche für die Aggregation von Auswirkungen wird, bevor man in die Details auf Service-Ebene eintaucht.
Capital One hat diesen Ansatz in Observe by Snowflake implementiert, indem Telemetriedaten verwendet wurden, die in den Data Lake von Observe eingespeist wurden, einschließlich RUM-Protokollen (Real User Monitoring), Clickstream-Daten und API-Zugriffsprotokollen. In Observe modellierte und bereicherte Capital One Daten nach der Erfassung und ohne Instrumentierung auf App-Ebene mit Interaktionen und Services. Dieser Geschäftskontext wird einmalig definiert und automatisch für die Nutzung und Zusammenarbeit durch alle an der Fehlerbehebung beteiligten Personen angewendet.
Der Journey-First-Workflow in der Praxis: E-Commerce-Beispiel
Schritt 1: Bei der Kundeninteraktion beginnen
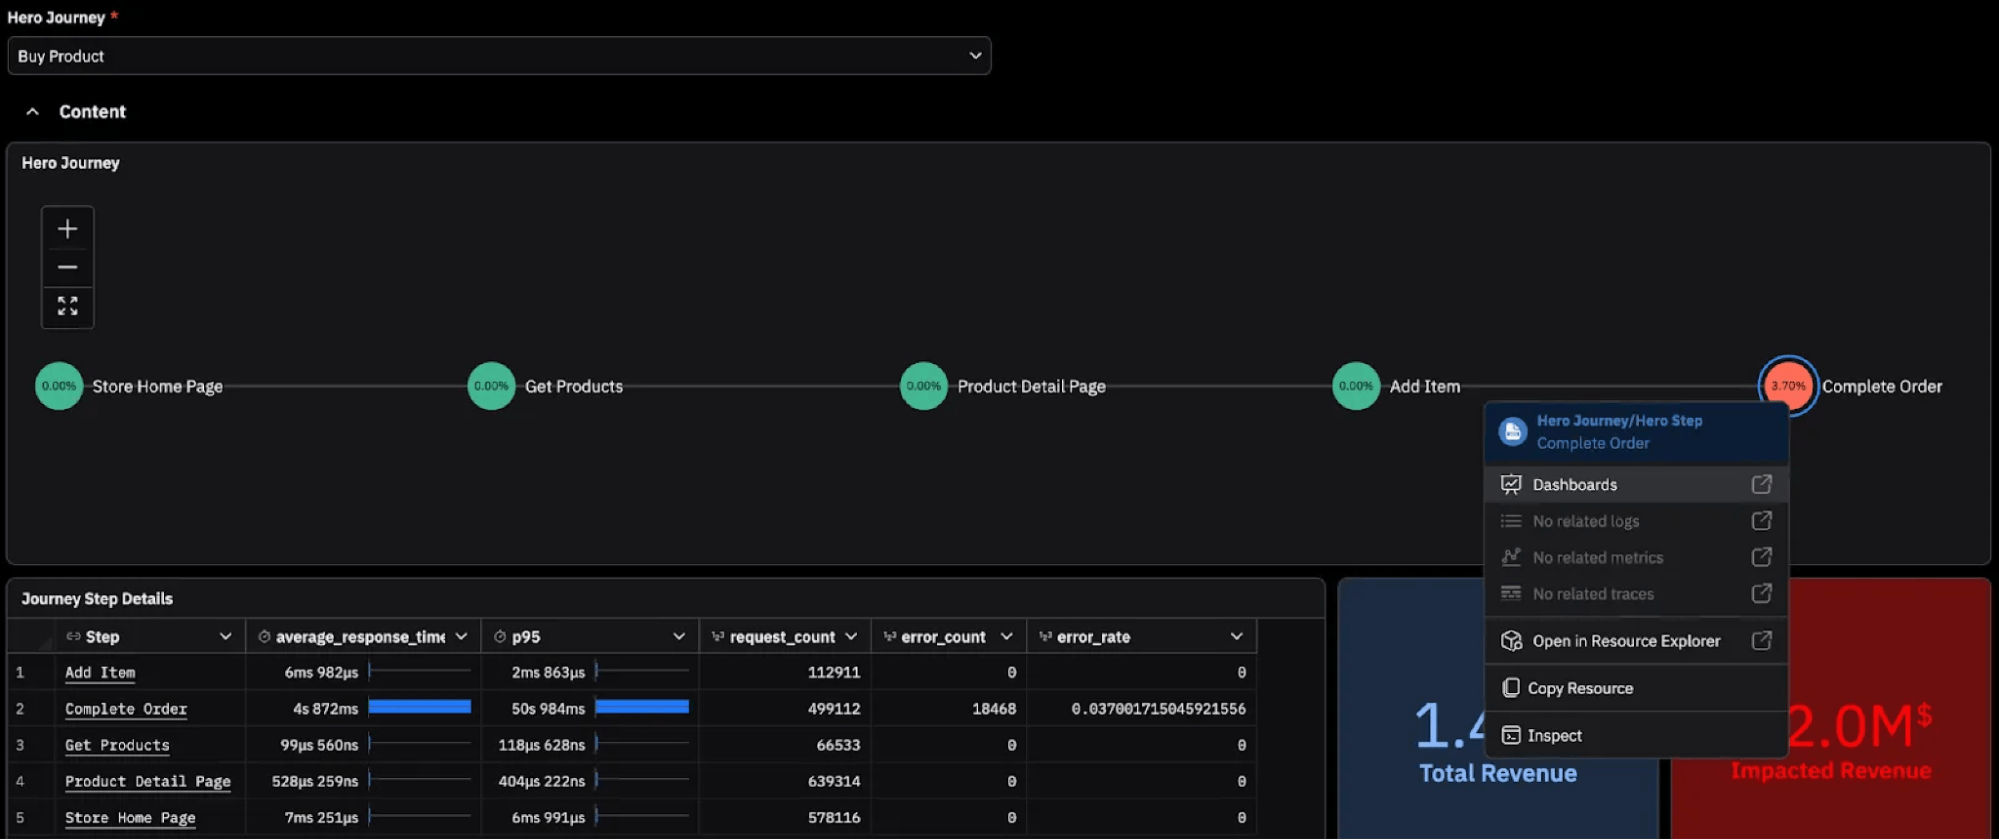
Betrachten Sie die Journey „Produkt kaufen“: Startseite → Produkte abrufen → Produktdetails → Artikel hinzufügen → Bestellung abschließen. In Altlast-Tools lässt sich anhand von rohen Protokollfehlern oder Spitzen bei Infrastrukturmetriken wie CPU- oder Speicherauslastung nicht sofort erkennen, ob Käufe blockiert sind oder wie weitreichend die Auswirkungen sind. In einem Journey-First-Modell beginnen Sie mit der Verschlechterung der Kundenerfahrung.
Wenn Sie mit einer Customer Journey in Observe beginnen, können Sie sofort das Ausmaß der Auswirkungen erkennen. Die Messung der Auswirkungen sollte der erste Schritt bei jedem Vorfall sein. Observe aggregiert RED-Metriken (Rate, Errors, Duration) und eindeutige Sitzungen in einen relevanten Kontext. Ihre Untersuchung beginnt mit bereits definierten geschäftlichen Auswirkungen.
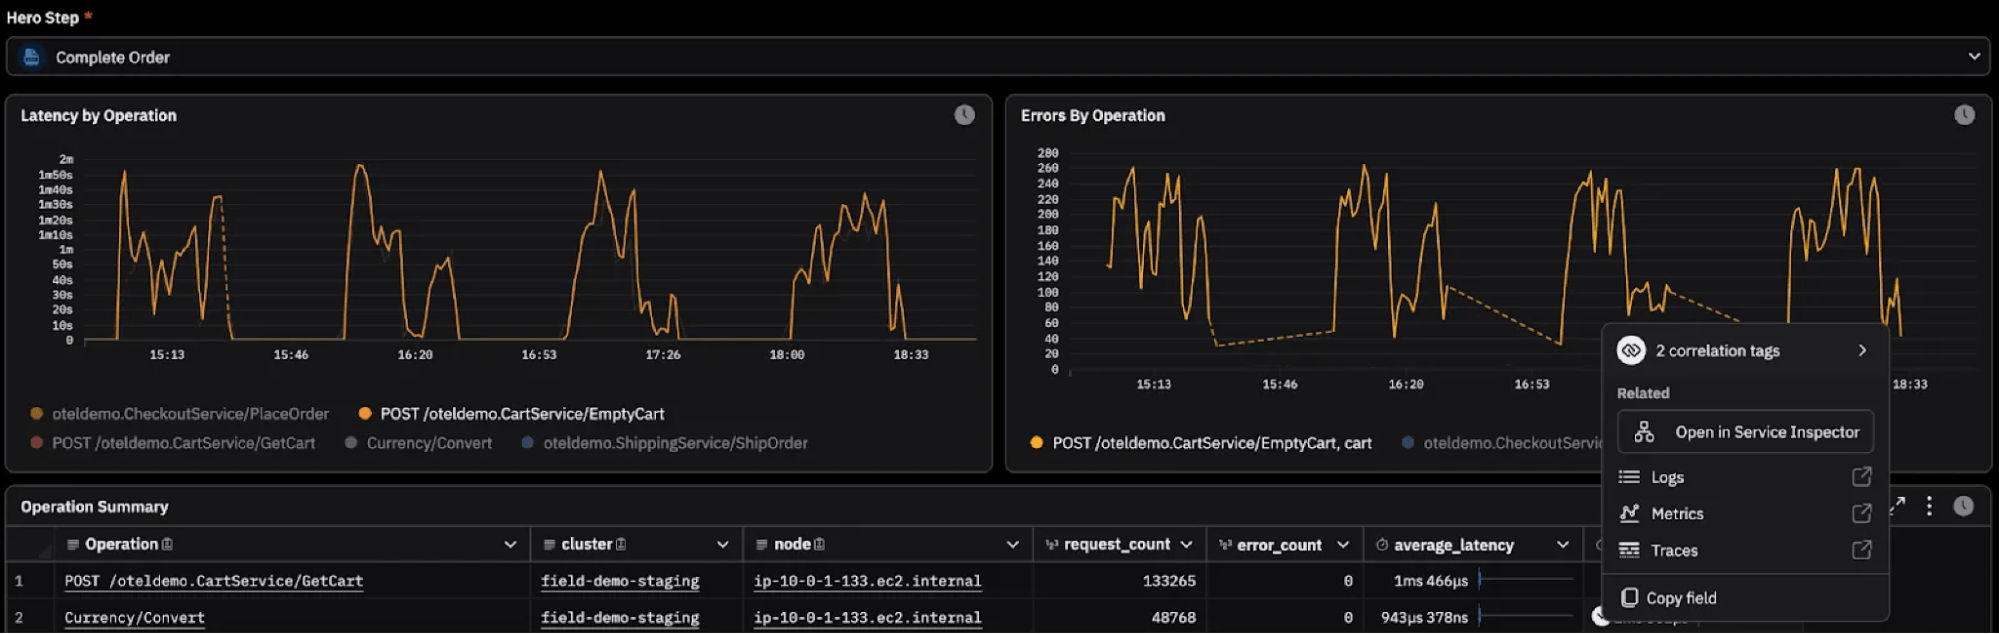
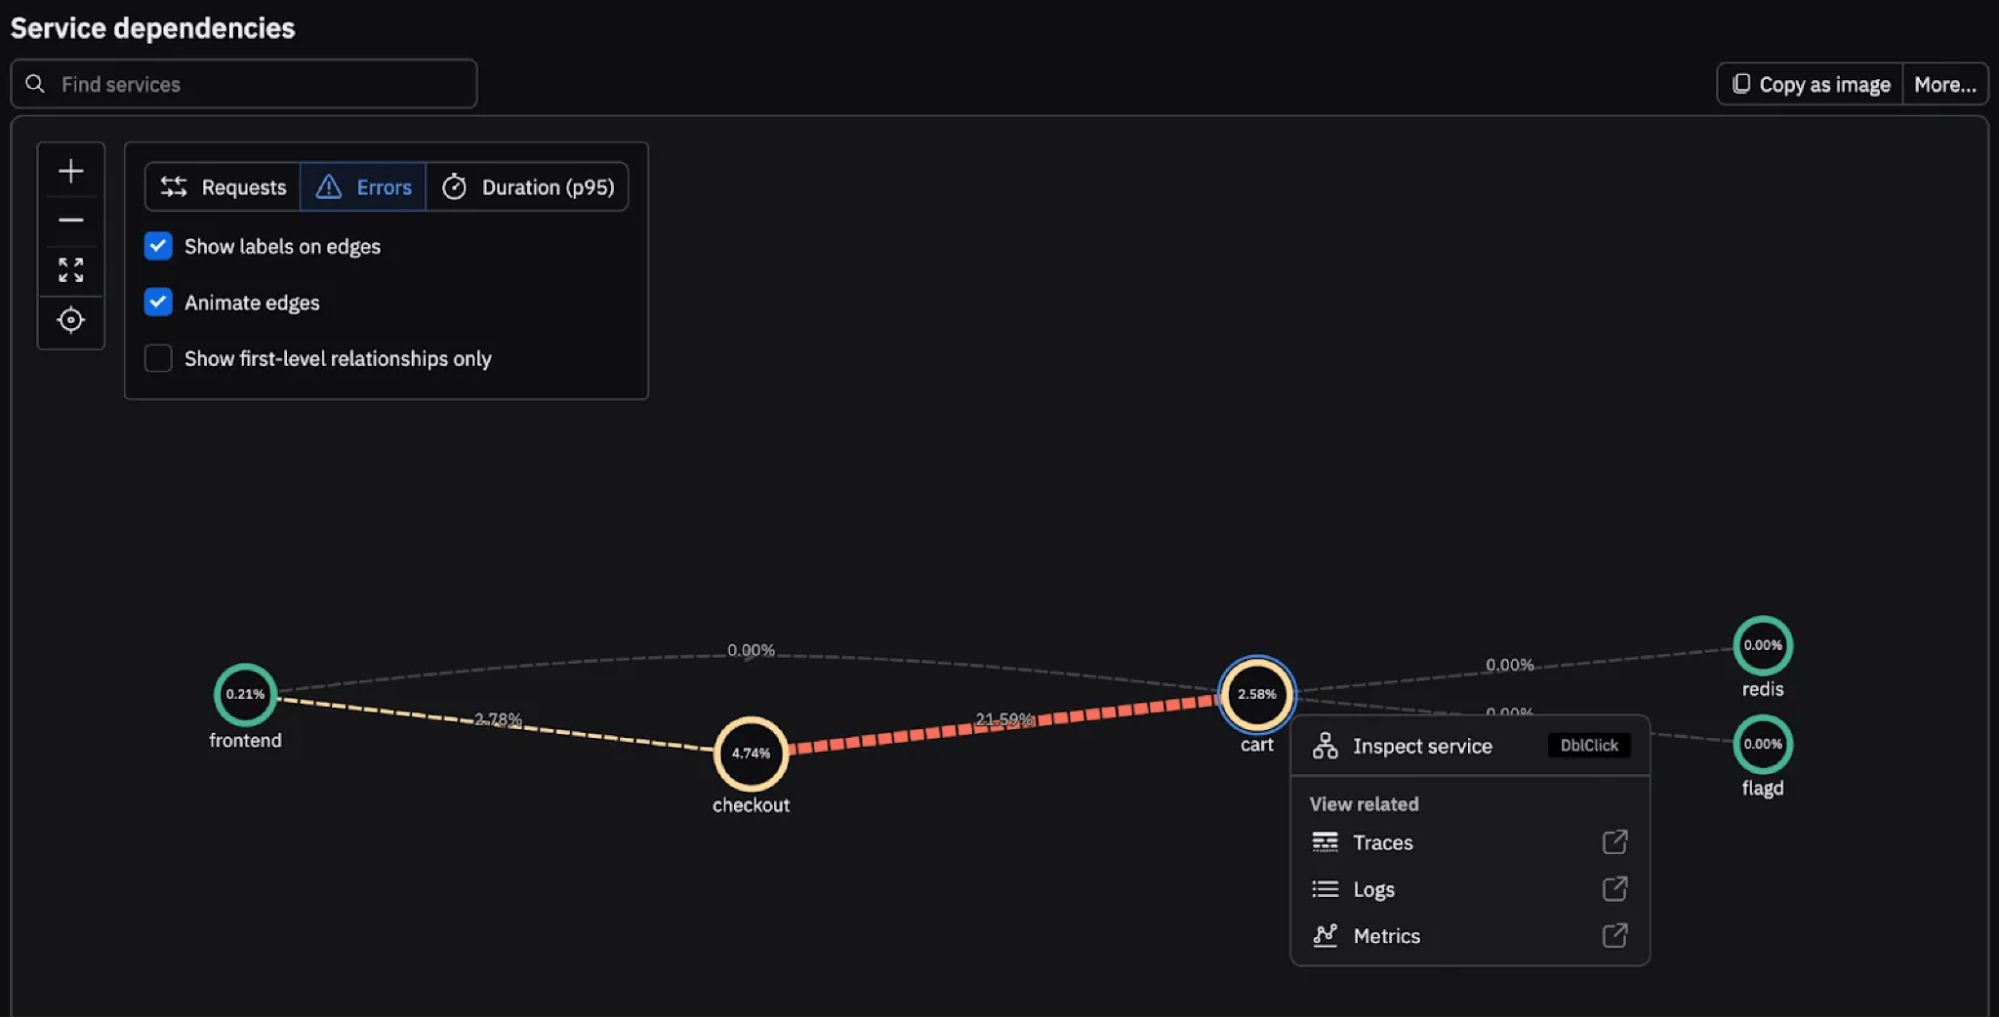
Sobald die Interaktion „Bestellung abschließen“ als beeinträchtigt identifiziert wurde, betrifft Ihre nächste Frage die Zuständigkeit und den Umfang. Von „Bestellung abschließen“ wechseln Sie zu einer Aufschlüsselung auf Service- oder Vorgangsebene. In diesem Beispiel verursacht der Vorgang „EmptyCart“ innerhalb des Warenkorb-Services Latenz und Fehler. Die Untersuchung wird von einem fehlerhaften Kundenschritt auf einen bestimmten Vorgang eingegrenzt. Führungskräfte überprüfen die Auswirkungen und den Schweregrad, während Site Reliability Engineers (SREs) den problematischen Service anhand desselben Dashboards und derselben Daten identifizieren, wodurch die Zeitverschwendung für den Abgleich von Ergebnissen aus verschiedenen Tools minimiert wird.
Schritt 3: Mit Traces und Protokollen bestätigen
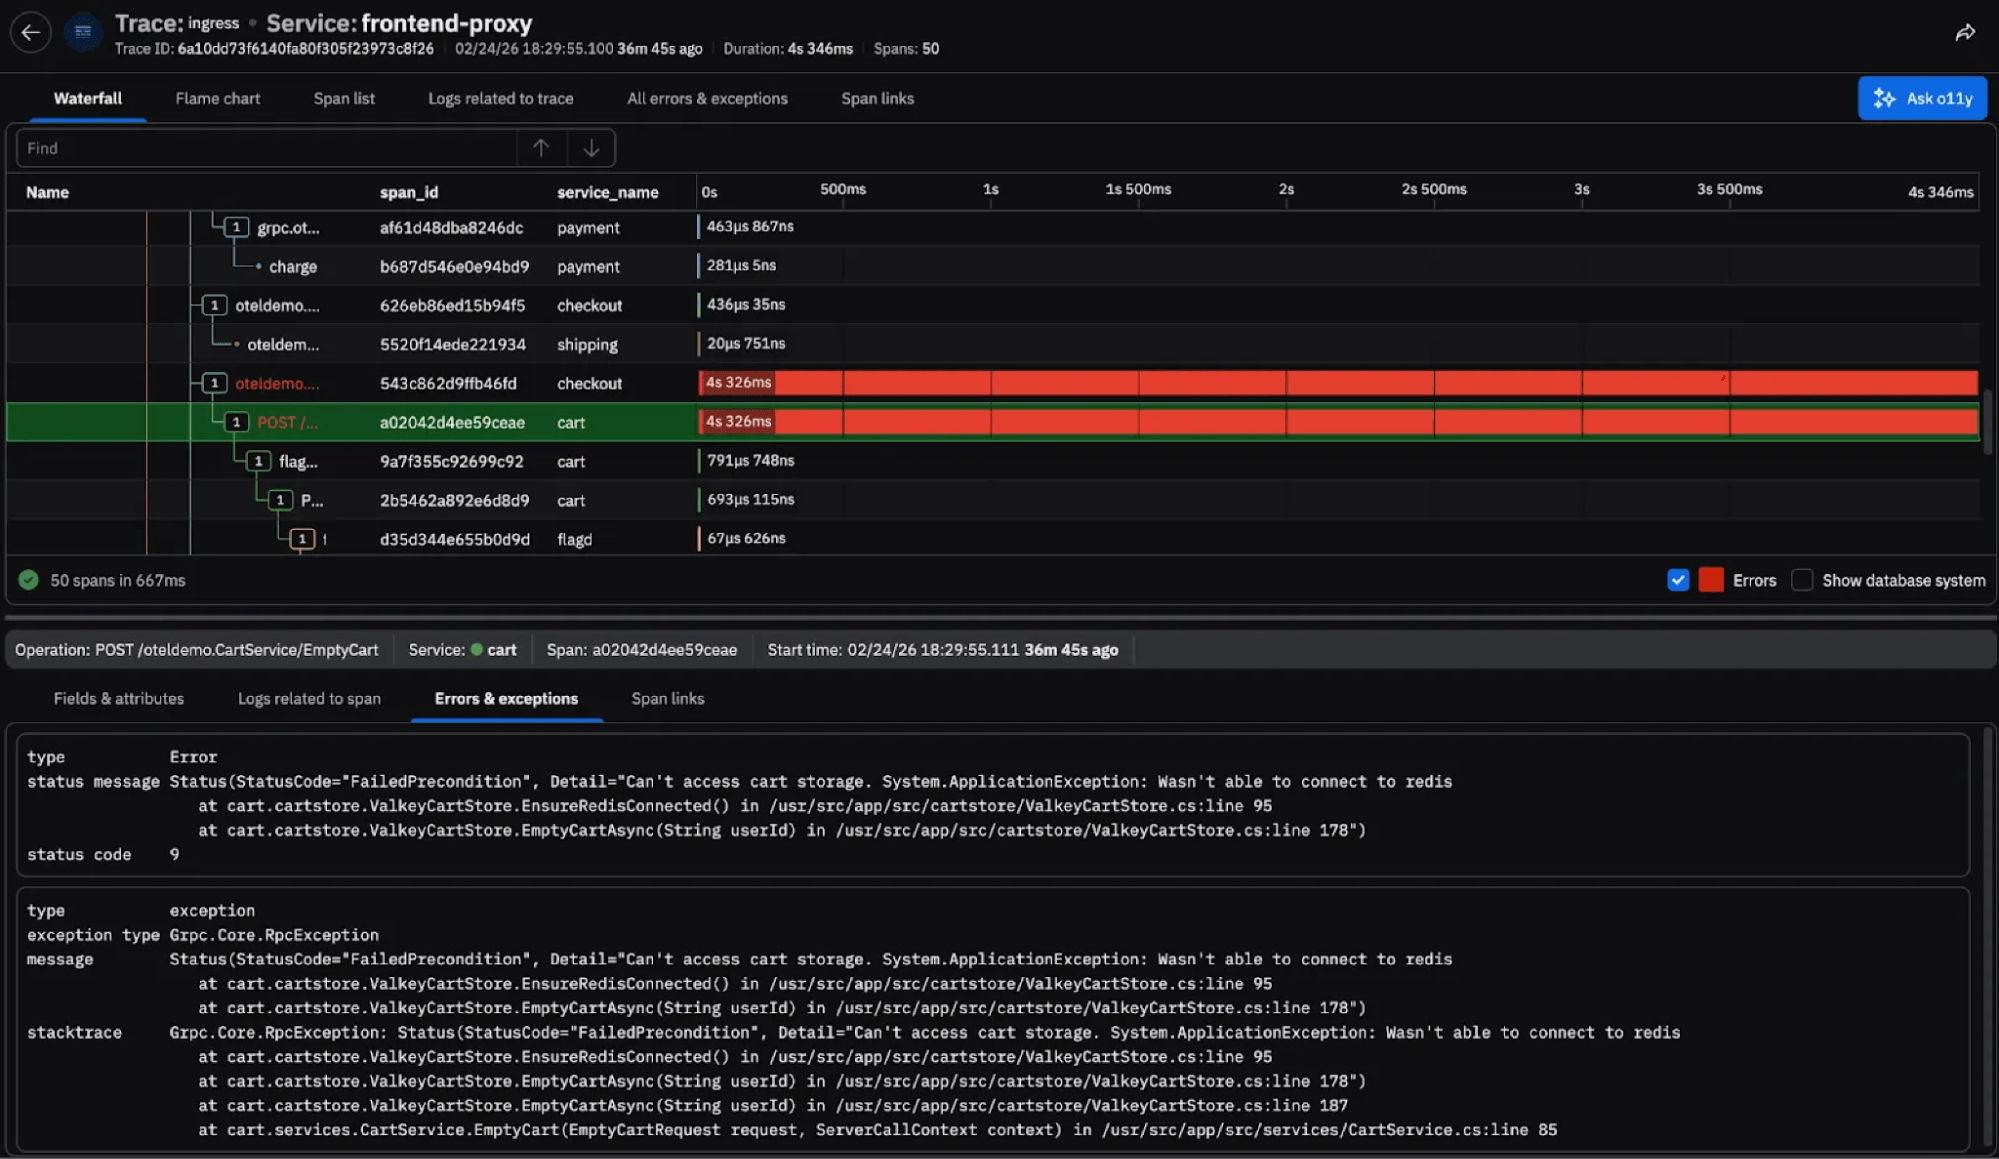
Sobald der Service, der die Fehlerursache darstellt, identifiziert wurde, können SREs das zuständige App-Team gezielt benachrichtigen und die Untersuchung der zugehörigen Telemetriedaten fortsetzen. Wechseln Sie zu Traces, um zu sehen, wo Zeit verbracht wird und wo der Fehler für eine bestimmte Anfrage herkommt, und navigieren Sie dann zu den Protokollen, die mit dem nachgelagerten fehlerhaften Span verknüpft sind. Der Ablauf des Vorfalls ist nun klar: Nutzer:innen können eine Bestellung nicht abschließen → fehlerhafter nachgelagerter Service → Trace-Fehler für eine zugehörige Anfrage → explizite Fehlermeldung (Fehlerursache). Mithilfe von Customer Journeys stellen die SREs in diesem Beispiel fest, dass Kund:innen den Checkout nicht abschließen können, weil der Vorgang „EmptyCart“ nicht aus Redis abrufen kann, was sich im Warenkorb befand, genau in dem Moment, in dem das benachrichtigte App-Team dem Call beitritt.
Dieses Beispiel demonstriert die explorative Analyse von Vorfällen. Ausgehend von den Auswirkungen auf die Kund:innen grenzt die reagierende Person die Untersuchung ein, indem sie den Beziehungen im Telemetrie-Data Lake folgt – von der Interaktion zum Service, vom Service zum Vorgang, vom Vorgang zum Trace und vom Trace zum Protokoll –, bis der Fehlermodus bestätigt ist. Die Struktur ist in den Daten definiert, aber die Untersuchung selbst wird immer noch von Menschen gesteuert. Engineers entscheiden, wohin sie als Nächstes wechseln, welche Signale wichtig sind und wie sie die Ergebnisse für den Rest des Raums zusammenfassen. Diese Synthese ist unerlässlich, kostet aber unter Druck Zeit.
AI SRE: Den Weg zur Fehlerursache beschleunigen
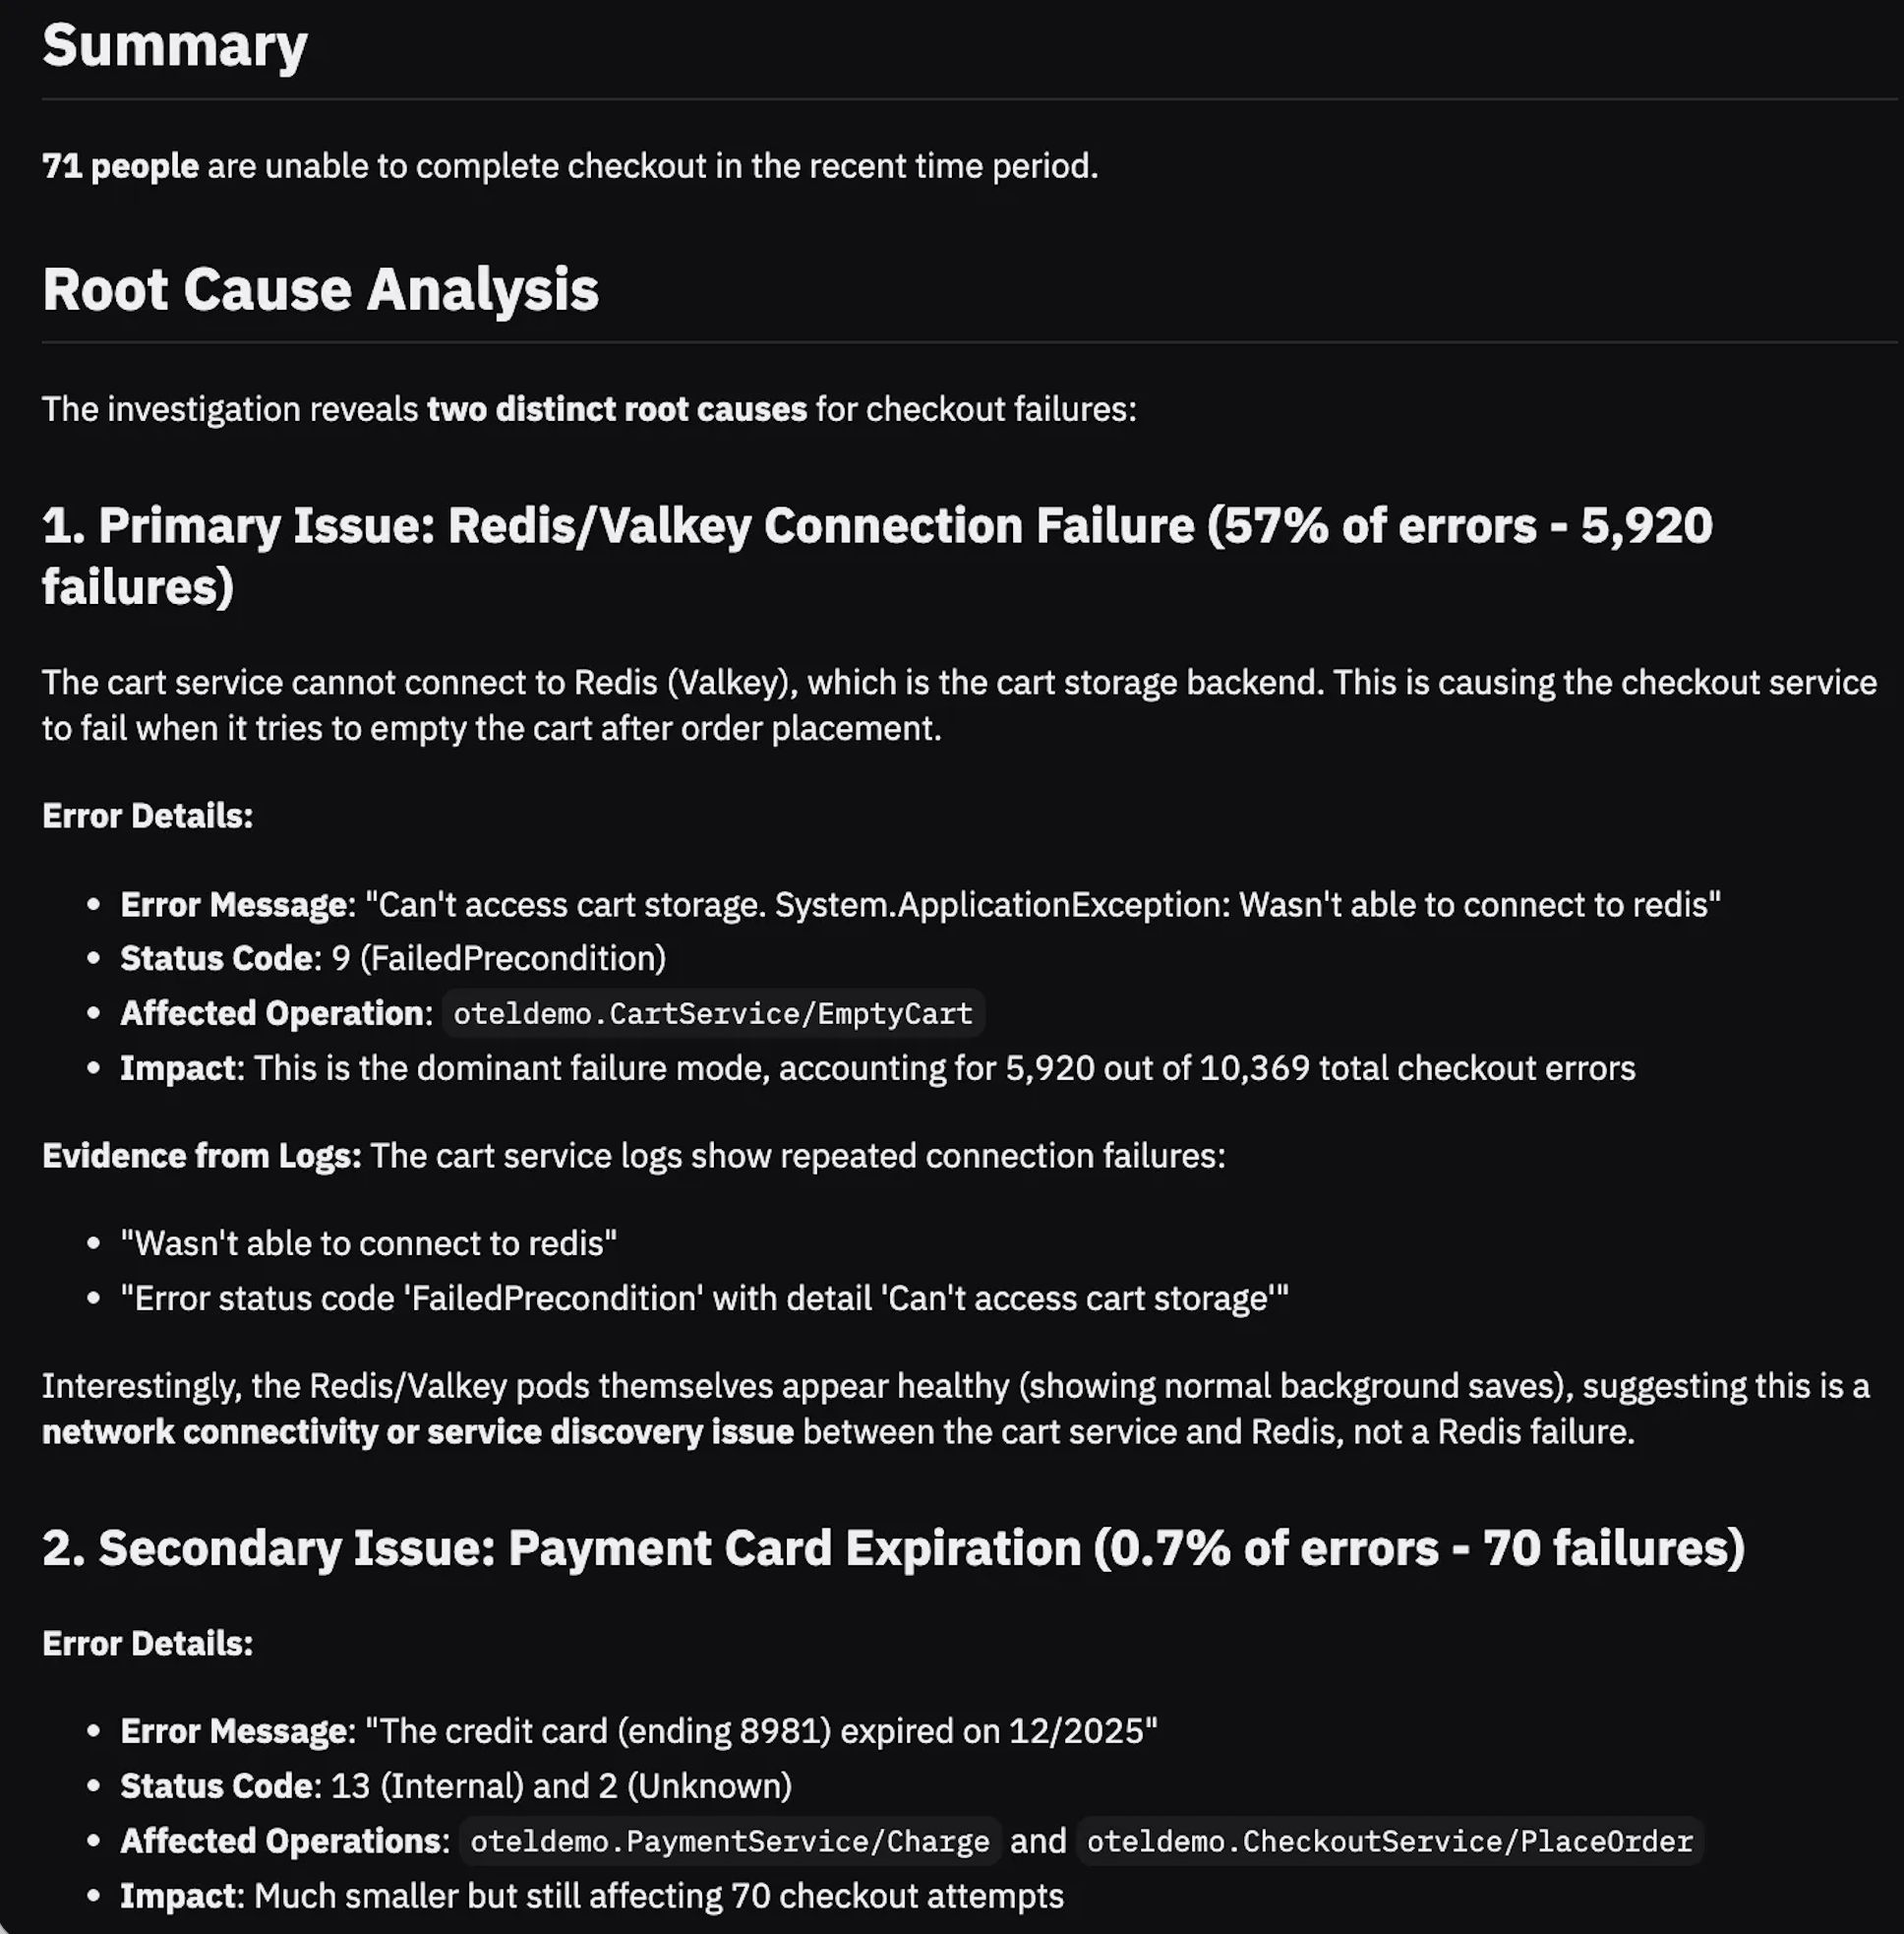
AI SRE arbeitet über denselben Observability-Kontextgraphen im Telemetrie-Data Lake, der auch den Journey-Flow antreibt. Anstatt jeden Schritt manuell zu navigieren, kann ein Engineer fragen: „Was verursacht den Anstieg bei fehlgeschlagenen Zahlungen?“ AI SRE durchläuft die verbundenen Interaktionen, Services, Traces und Protokolle und liefert in Sekundenschnelle eine geführte Untersuchung mit unterstützenden Beweisen und interaktiven Abfragekarten für eine tiefergehende Analyse.
AI SRE kann erhebliche Produktivitätssteigerungen in Observability-Workflows bewirken. Kund:innen berichten, dass sie Aufgaben im Durchschnitt etwa 4-mal schneller erledigen, wobei einige Untersuchungen bis zu 10-mal schneller ablaufen. (Erfahren Sie mehr darüber, wie AI SRE einheitliche Telemetrie und den Kontextgraphen nutzt, um die Untersuchungszeit zu verkürzen.)
AI SRE folgt auch den in Ihren Daten definierten Beziehungen. Dieselben Verbindungen, die geschäftliche Auswirkungen mit der Implementierung verknüpfen, leiten die Untersuchung, wodurch die Zeit zwischen Frage und Antwort verkürzt und gleichzeitig die Beweiskette erhalten bleibt.
Customer Journeys innerhalb des größeren Observability-Kontextgraphen
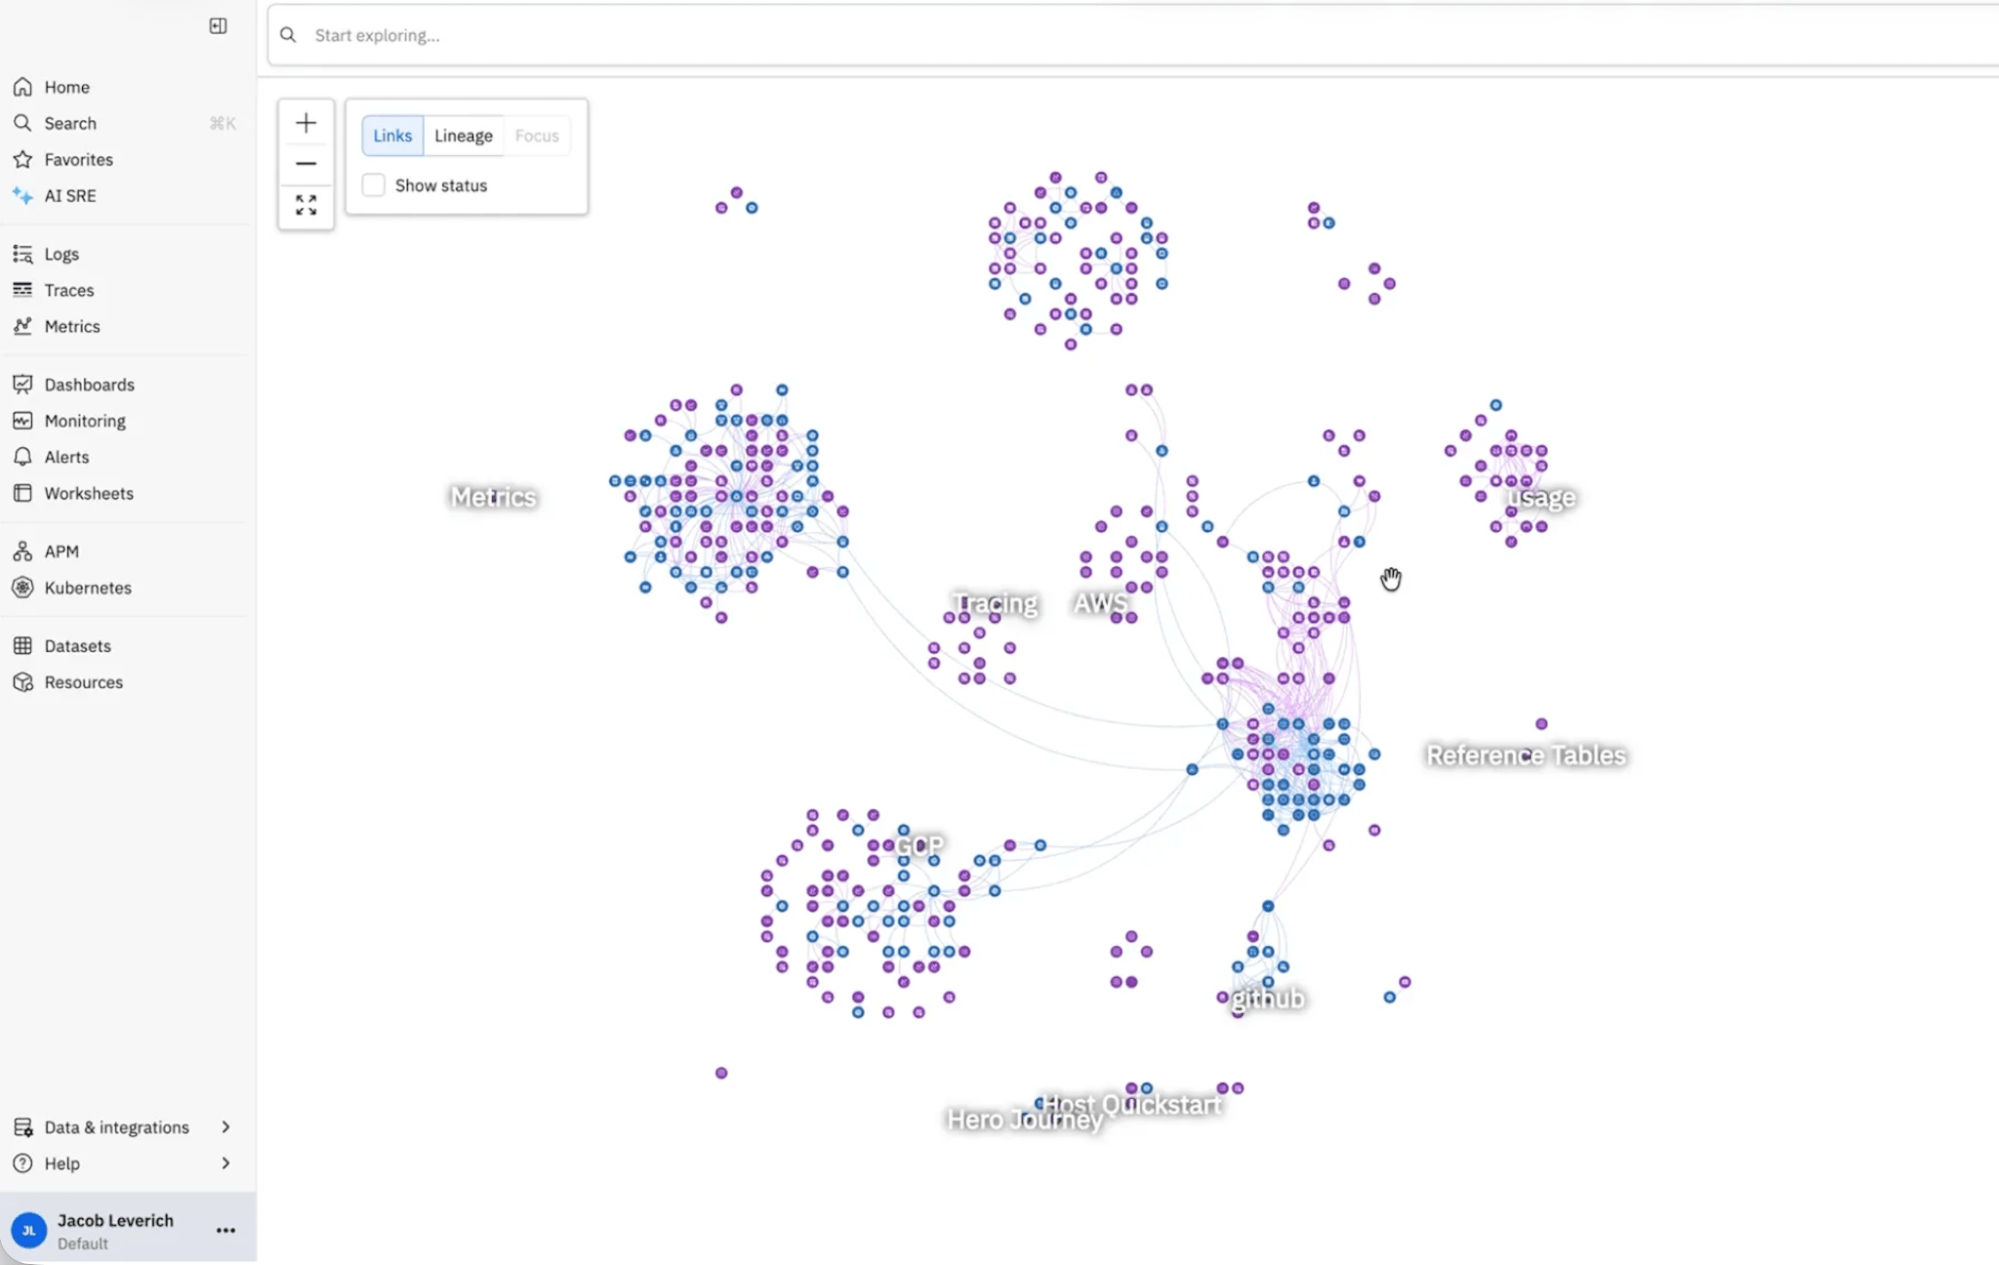
Der obige Journey-Flow ist eine Domäne innerhalb eines breiteren Observability-Kontextgraphen in Observe. Alle in den Telemetrie-Data Lake eingespeisten Telemetriedaten sind durch modellierte Beziehungen verbunden, die widerspiegeln, wie Services, Infrastruktur und Geschäftsentitäten interagieren.
Customer Journeys organisieren einen Teil dieses Graphen um Geschäftsinteraktionen herum. Andere Domänen verbinden Cloud-Ressourcen, Änderungsdaten und externe Systeme wie AWS und GitHub mit den Services, auf die sie sich auswirken. Jeder Knoten und jede Kante spiegelt Beziehungen wider, die im Datenmodell definiert sind, und nicht in einem vordefinierten Dashboard.
Wenn Sie von einem Journey-Schritt zu einem Service oder von einem Service zu einem Trace wechseln, durchlaufen Sie diesen größeren Graphen. AI SRE arbeitet über dieselbe Struktur. Journeys sind ein geschäftsorientierter Einstiegspunkt in ein gemeinsames Modell, das zeigt, wie Ihre Systeme und Ihr Geschäftskontext miteinander verbunden sind.
Observability von den geschäftlichen Auswirkungen bis zur Fehlerursache
Customer Journeys in Observe zeigen, wie der Beginn bei den geschäftlichen Auswirkungen die Untersuchung von Chaos in ein strukturiertes Verfahren verwandelt. Da Observe auf Beziehungen im Kontextgraphen aufbaut, der auf einem Telemetrie-Data Lake basiert, können Sie zwischen verschiedenen Arten von Daten wechseln, je nachdem, wie Ihre Systeme und Geschäftsentitäten tatsächlich miteinander verbunden sind.
Ein Journey-Graph ist eine Möglichkeit, diese Beziehungen zu organisieren, und wird als Teil der Kernfunktionalität von Observe vollständig unterstützt. Derselbe Mechanismus gilt für jede Entität, die Sie in Ihren Daten modellieren: Kund:innen, Transaktionen, Sendungen, Geräte, Telefonanrufe und Schadensfälle. Sobald diese Beziehungen definiert sind, werden sie zum Kontext für die Analyse, ohne dass während des Vorfalls mit AI SRE Dashboards und Runbooks erlernt werden müssen.
Dies ist der Wandel, den Capital One beschreibt: Beginnen Sie mit dem, was die Kund:innen erleben, und bewegen Sie sich dann nur durch die zugehörigen Daten mit intaktem Kontext. In Observe sind Customer Journeys eine Domäne innerhalb eines breiteren Observability-Kontextgraphen, der auf dem Telemetrie-Data Lake aufbaut. Da dieser Graph widerspiegelt, wie Systeme und Geschäftsentitäten miteinander verbunden sind, ist der Weg von den geschäftlichen Auswirkungen zur Fehlerursache bereits definiert, was zu schnelleren und effizienteren Untersuchungen führen kann.
Erfahren Sie mehr über Observe by Snowflake und wie es Telemetriedaten schnell in Erkenntnisse verwandelt.