25 sept. 2026/Lecture : 6 minProduit et technologie
Parcours clients chez Capital One : de l’impact business à la cause première
Un incident commence par des symptômes : un pic d’erreurs 500, une hausse de la latence ou une baisse des conversions, par exemple. Les premières questions ne tardent pas : qu’est-ce qui ne fonctionne plus et quelles sont les conséquences pour les clients ?
L’observabilité traditionnelle commence au niveau des services, et non de l’impact sur les clients. Les tableaux de bord passent au rouge, les alertes se déclenchent et les équipes partent des signaux de l’infrastructure et des applications pour évaluer simultanément l’impact sur les clients et isoler la cause première. Cette mise en correspondance des signaux d’infrastructure et de l’impact business repose souvent sur les connaissances internes : quels services assurent le paiement ou alimentent le récapitulatif du compte ? Pour répondre à une simple question de la direction comme « Combien de personnes ne peuvent pas se connecter ? », une équipe doit se réunir dans une salle dédiée afin d’estimer l’impact, puis vérifier cette estimation lors du post‑mortem.
Capital One s’attaque directement à cette lacune dans son article de blog « L’observabilité avec des graphes automatisés de parcours clients ». Son approche inverse le point de départ de l’enquête : commencez au niveau des interactions client, puis descendez dans les couches des services et de l’infrastructure. Lorsque l’enquête commence par une interaction business déjà définie, l’impact est clair. L’atténuation de l’incident et l’identification de sa cause première deviennent alors les seules priorités.
Pour y parvenir, Capital One a créé des graphes de parcours client dont les nœuds représentent les interactions client et les arêtes montrent comment les utilisateurs progressent dans l’expérience. Les signaux d’intégrité et le trafic sont superposés au graphe, qui devient ainsi une interface opérationnelle permettant d’agréger l’impact avant d’examiner les détails au niveau des services.
Capital One a mis en œuvre cette approche dans Observe by Snowflake à partir de la télémétrie ingérée dans le data lake d’Observe, notamment les logs de surveillance des utilisateurs réels (RUM), les données de parcours de navigation et les logs d’accès aux API. Dans Observe, Capital One a modélisé et enrichi les données avec les interactions et les services après leur ingestion, sans instrumentation au niveau des applications. Ce contexte business est défini une seule fois, puis automatiquement mis à la disposition de tous les profils participant au dépannage, à des fins d’analyse et de collaboration.
Le workflow axé sur le parcours en pratique : exemple dans l’e-commerce
Étape 1 : commencer par l’interaction client
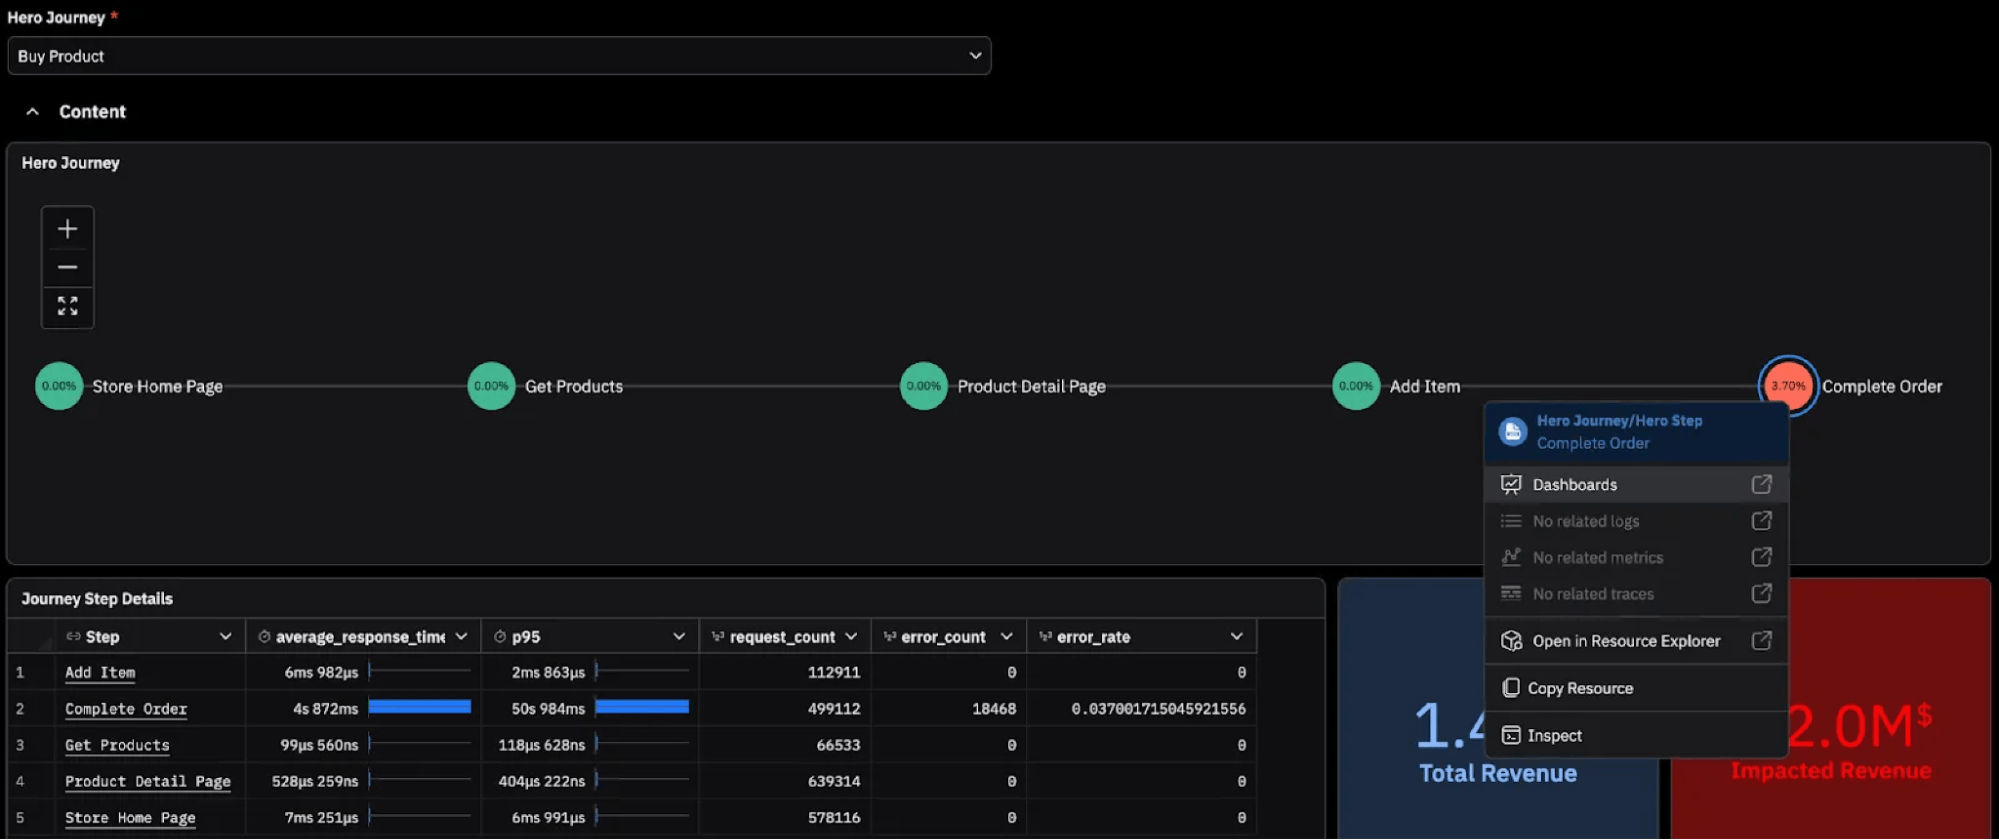
Prenons le parcours « Achat de produit » : Accueil → Chercher un produit → Détails du produit → Ajout au panier → Remplir le bon de commande. Avec les outils hérités, les erreurs brutes dans les logs ou les pics de métriques d’infrastructure, comme l’utilisation du CPU ou de la mémoire, ne permettent pas de savoir immédiatement si les achats sont bloqués ni de mesurer l’ampleur de l’impact. Dans un modèle axé sur le parcours, vous partez de la dégradation de l’expérience client.
En commençant par un parcours client dans Observe, vous visualisez immédiatement l’ampleur de l’impact. Mesurer l’impact devrait être la première étape de la gestion de tout incident. Observe agrège les métriques de taux, d’erreurs et de durée (RED), ainsi que les sessions uniques, pour fournir un contexte réellement pertinent. Votre enquête commence avec un impact business déjà défini.
Étape 2 : descendre jusqu’à l’opération défaillante
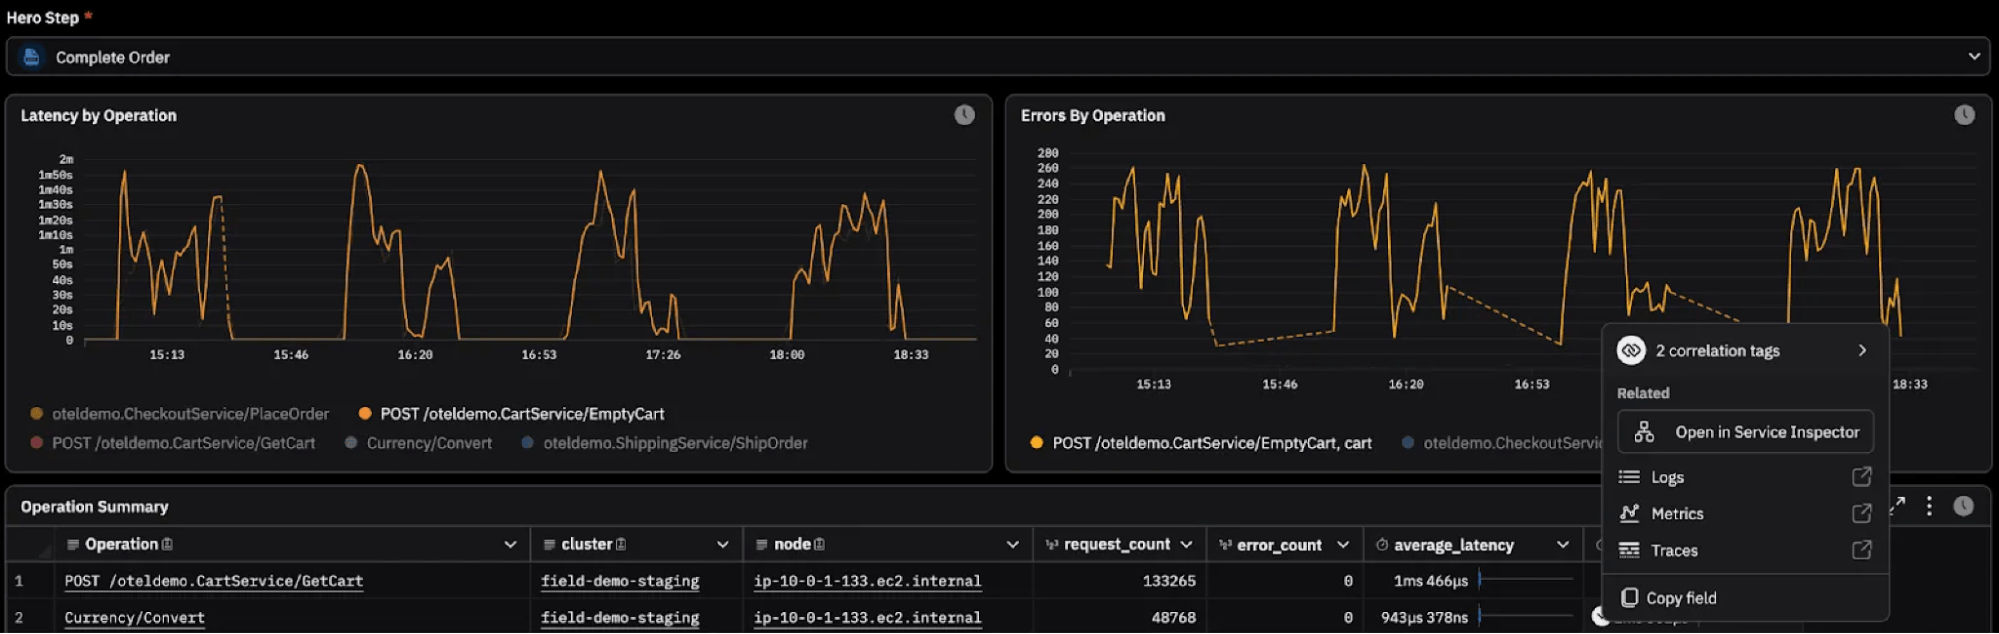
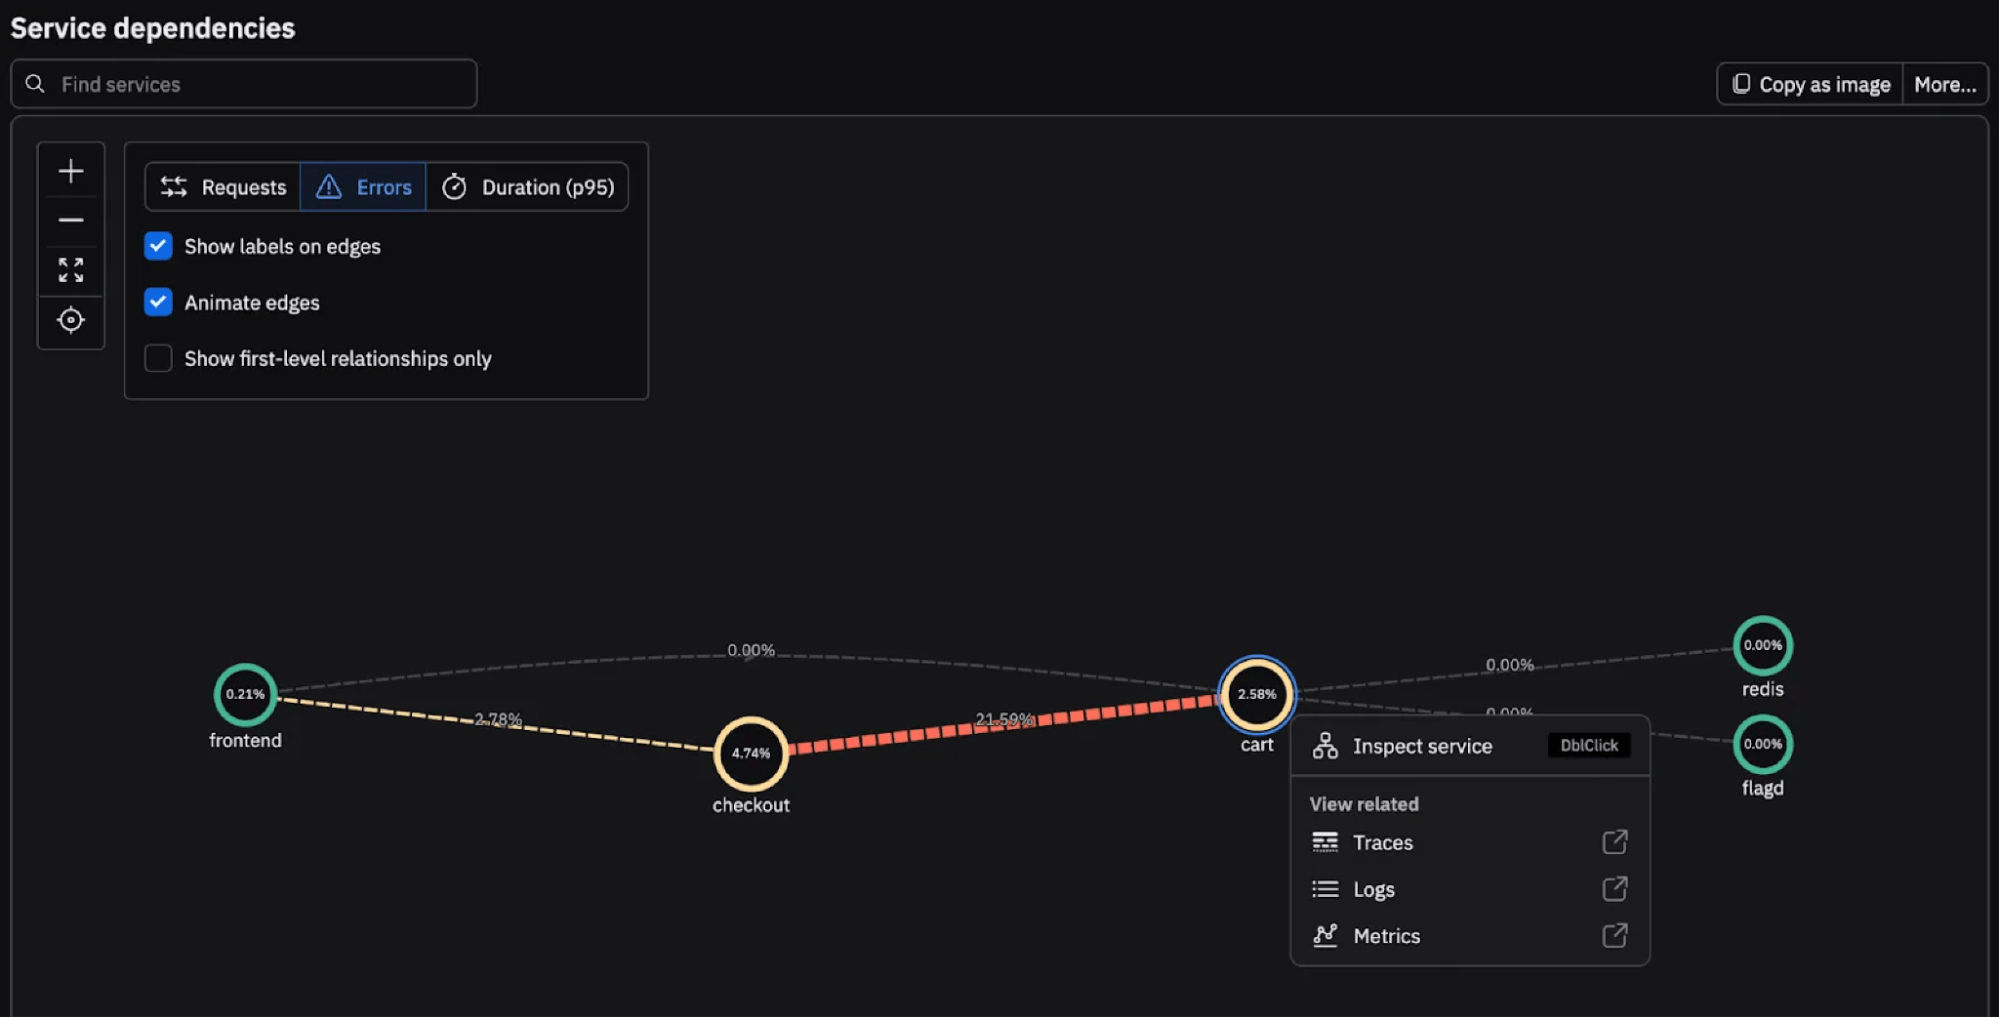
Une fois la dégradation de l’interaction Remplir le bon de commande identifiée, il reste à déterminer l’équipe responsable et l’étendue du problème. Depuis Remplir le bon de commande, vous accédez à une ventilation par service ou par opération. Dans cet exemple, l’opération EmptyCart du service de panier provoque les problèmes de latence et les erreurs. L’enquête passe ainsi d’une étape défaillante du parcours client à une opération précise. Les dirigeants vérifient l’impact et la gravité tandis que les site reliability engineers (SRE) identifient le service en cause à partir du même tableau de bord et des mêmes données. Ils évitent ainsi de perdre du temps à rapprocher les résultats de différents outils.
Étape 3 : confirmer avec les traces et les logs
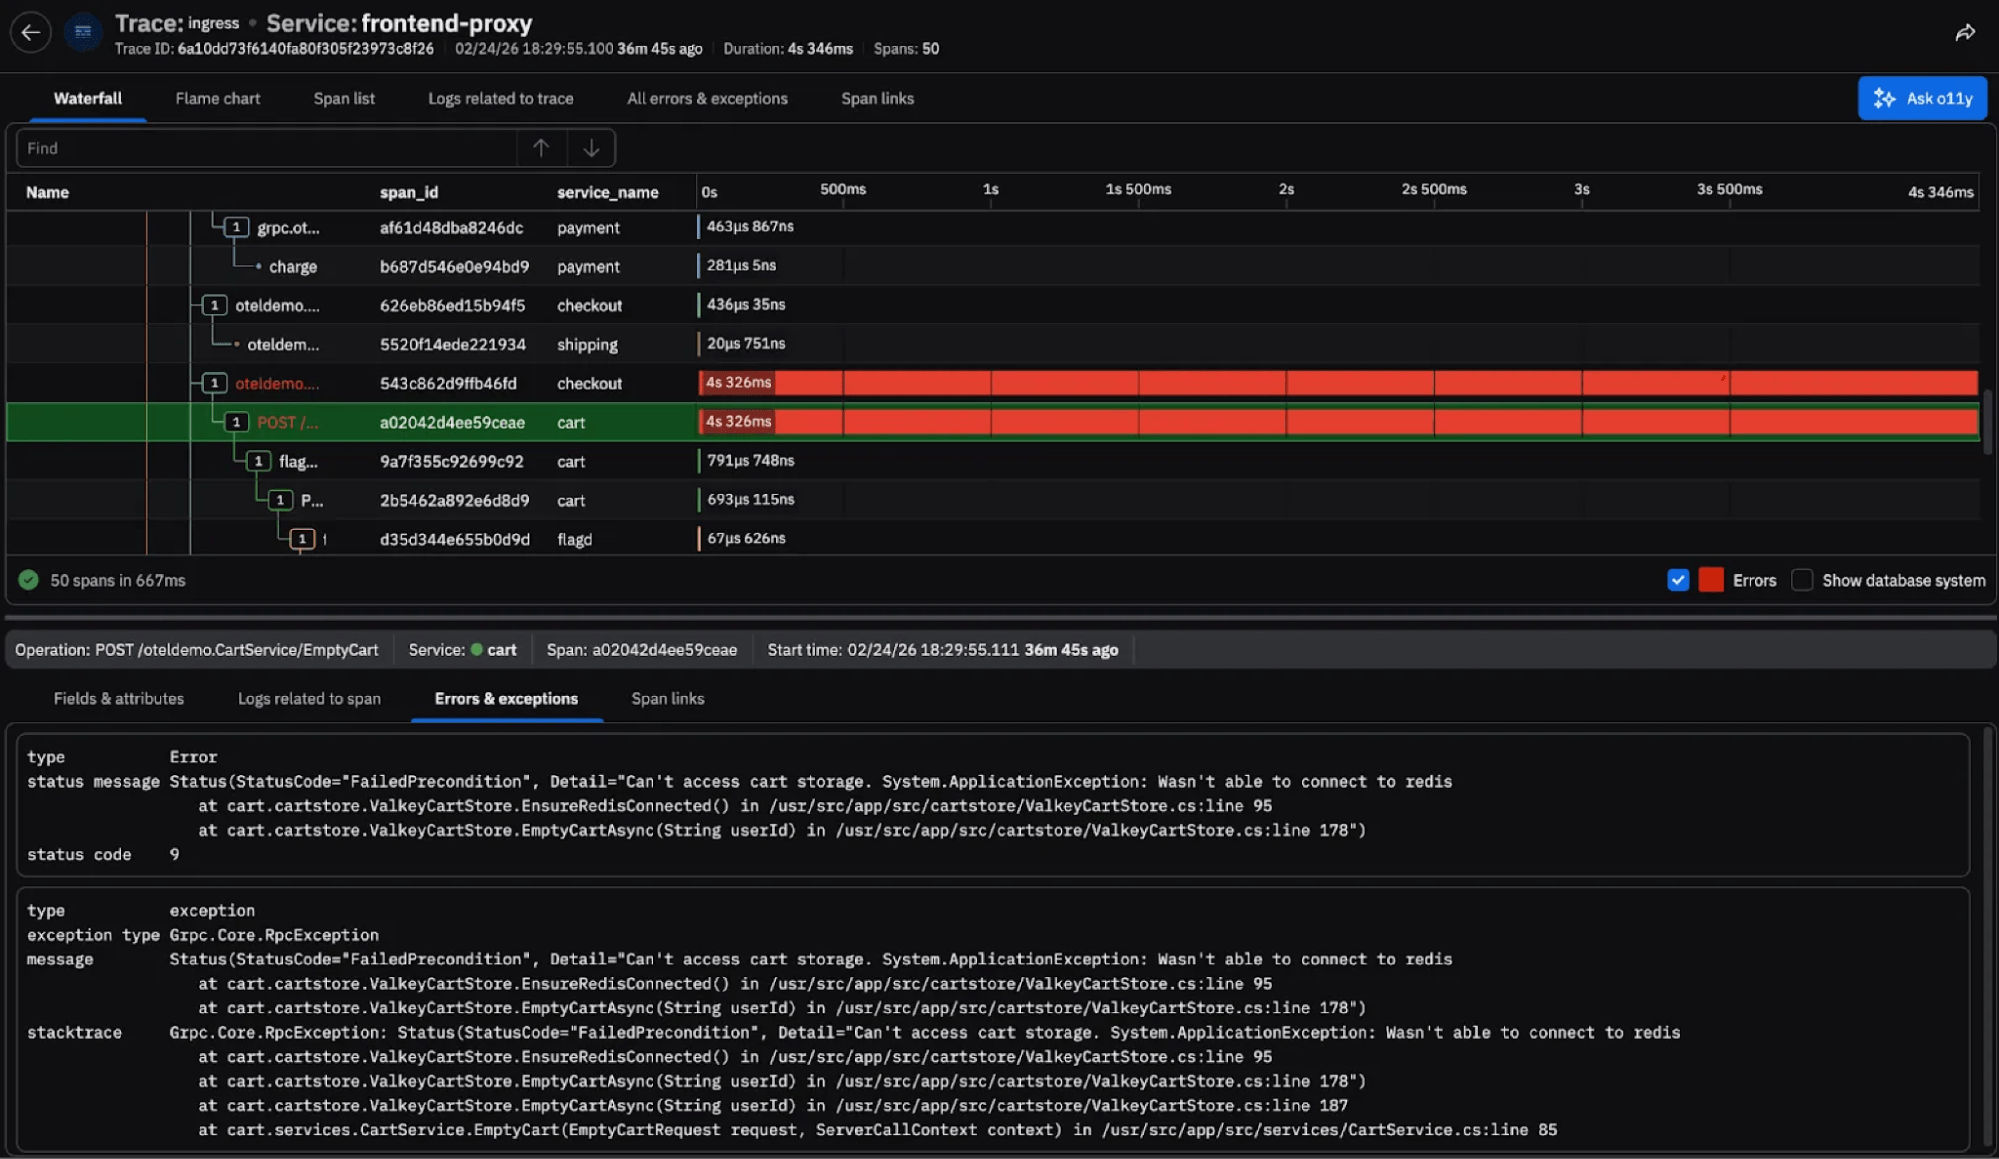
Une fois le service à l’origine du problème identifié, les SRE peuvent envoyer une alerte ciblée à l’équipe applicative responsable et poursuivre l’enquête dans la télémétrie associée. Accédez aux traces pour savoir où le temps est consacré et d’où provient l’erreur pour une requête donnée, puis examinez les logs associés au span en aval qui échoue. Le déroulement de l’incident est désormais clair : les utilisateurs ne peuvent pas finaliser leur commande → un service en aval échoue → la trace d’une requête associée révèle une défaillance → un message d’erreur explicite indique la cause première. Grâce aux parcours clients, les SRE de cet exemple découvrent que les clients ne peuvent pas finaliser leur achat, car l’opération EmptyCart ne parvient pas à récupérer dans Redis le contenu du panier, au moment même où l’équipe applicative alertée rejoint l’appel.
Cet exemple illustre une analyse exploratoire des incidents. En partant de l’impact sur les clients, l’intervenant resserre l’enquête en suivant les relations dans le data lake de télémétrie, de l’interaction au service, du service à l’opération, de l’opération à la trace et de la trace au log, jusqu’à confirmer le mode de défaillance. La structure est définie dans les données, mais l’enquête reste menée par des personnes. Les ingénieurs choisissent l’élément à explorer ensuite, déterminent les signaux pertinents et synthétisent les conclusions pour les autres participants. Cette synthèse est essentielle, mais elle prend du temps lorsque la pression monte.
IA SRE : accélérer l’identification de la cause première
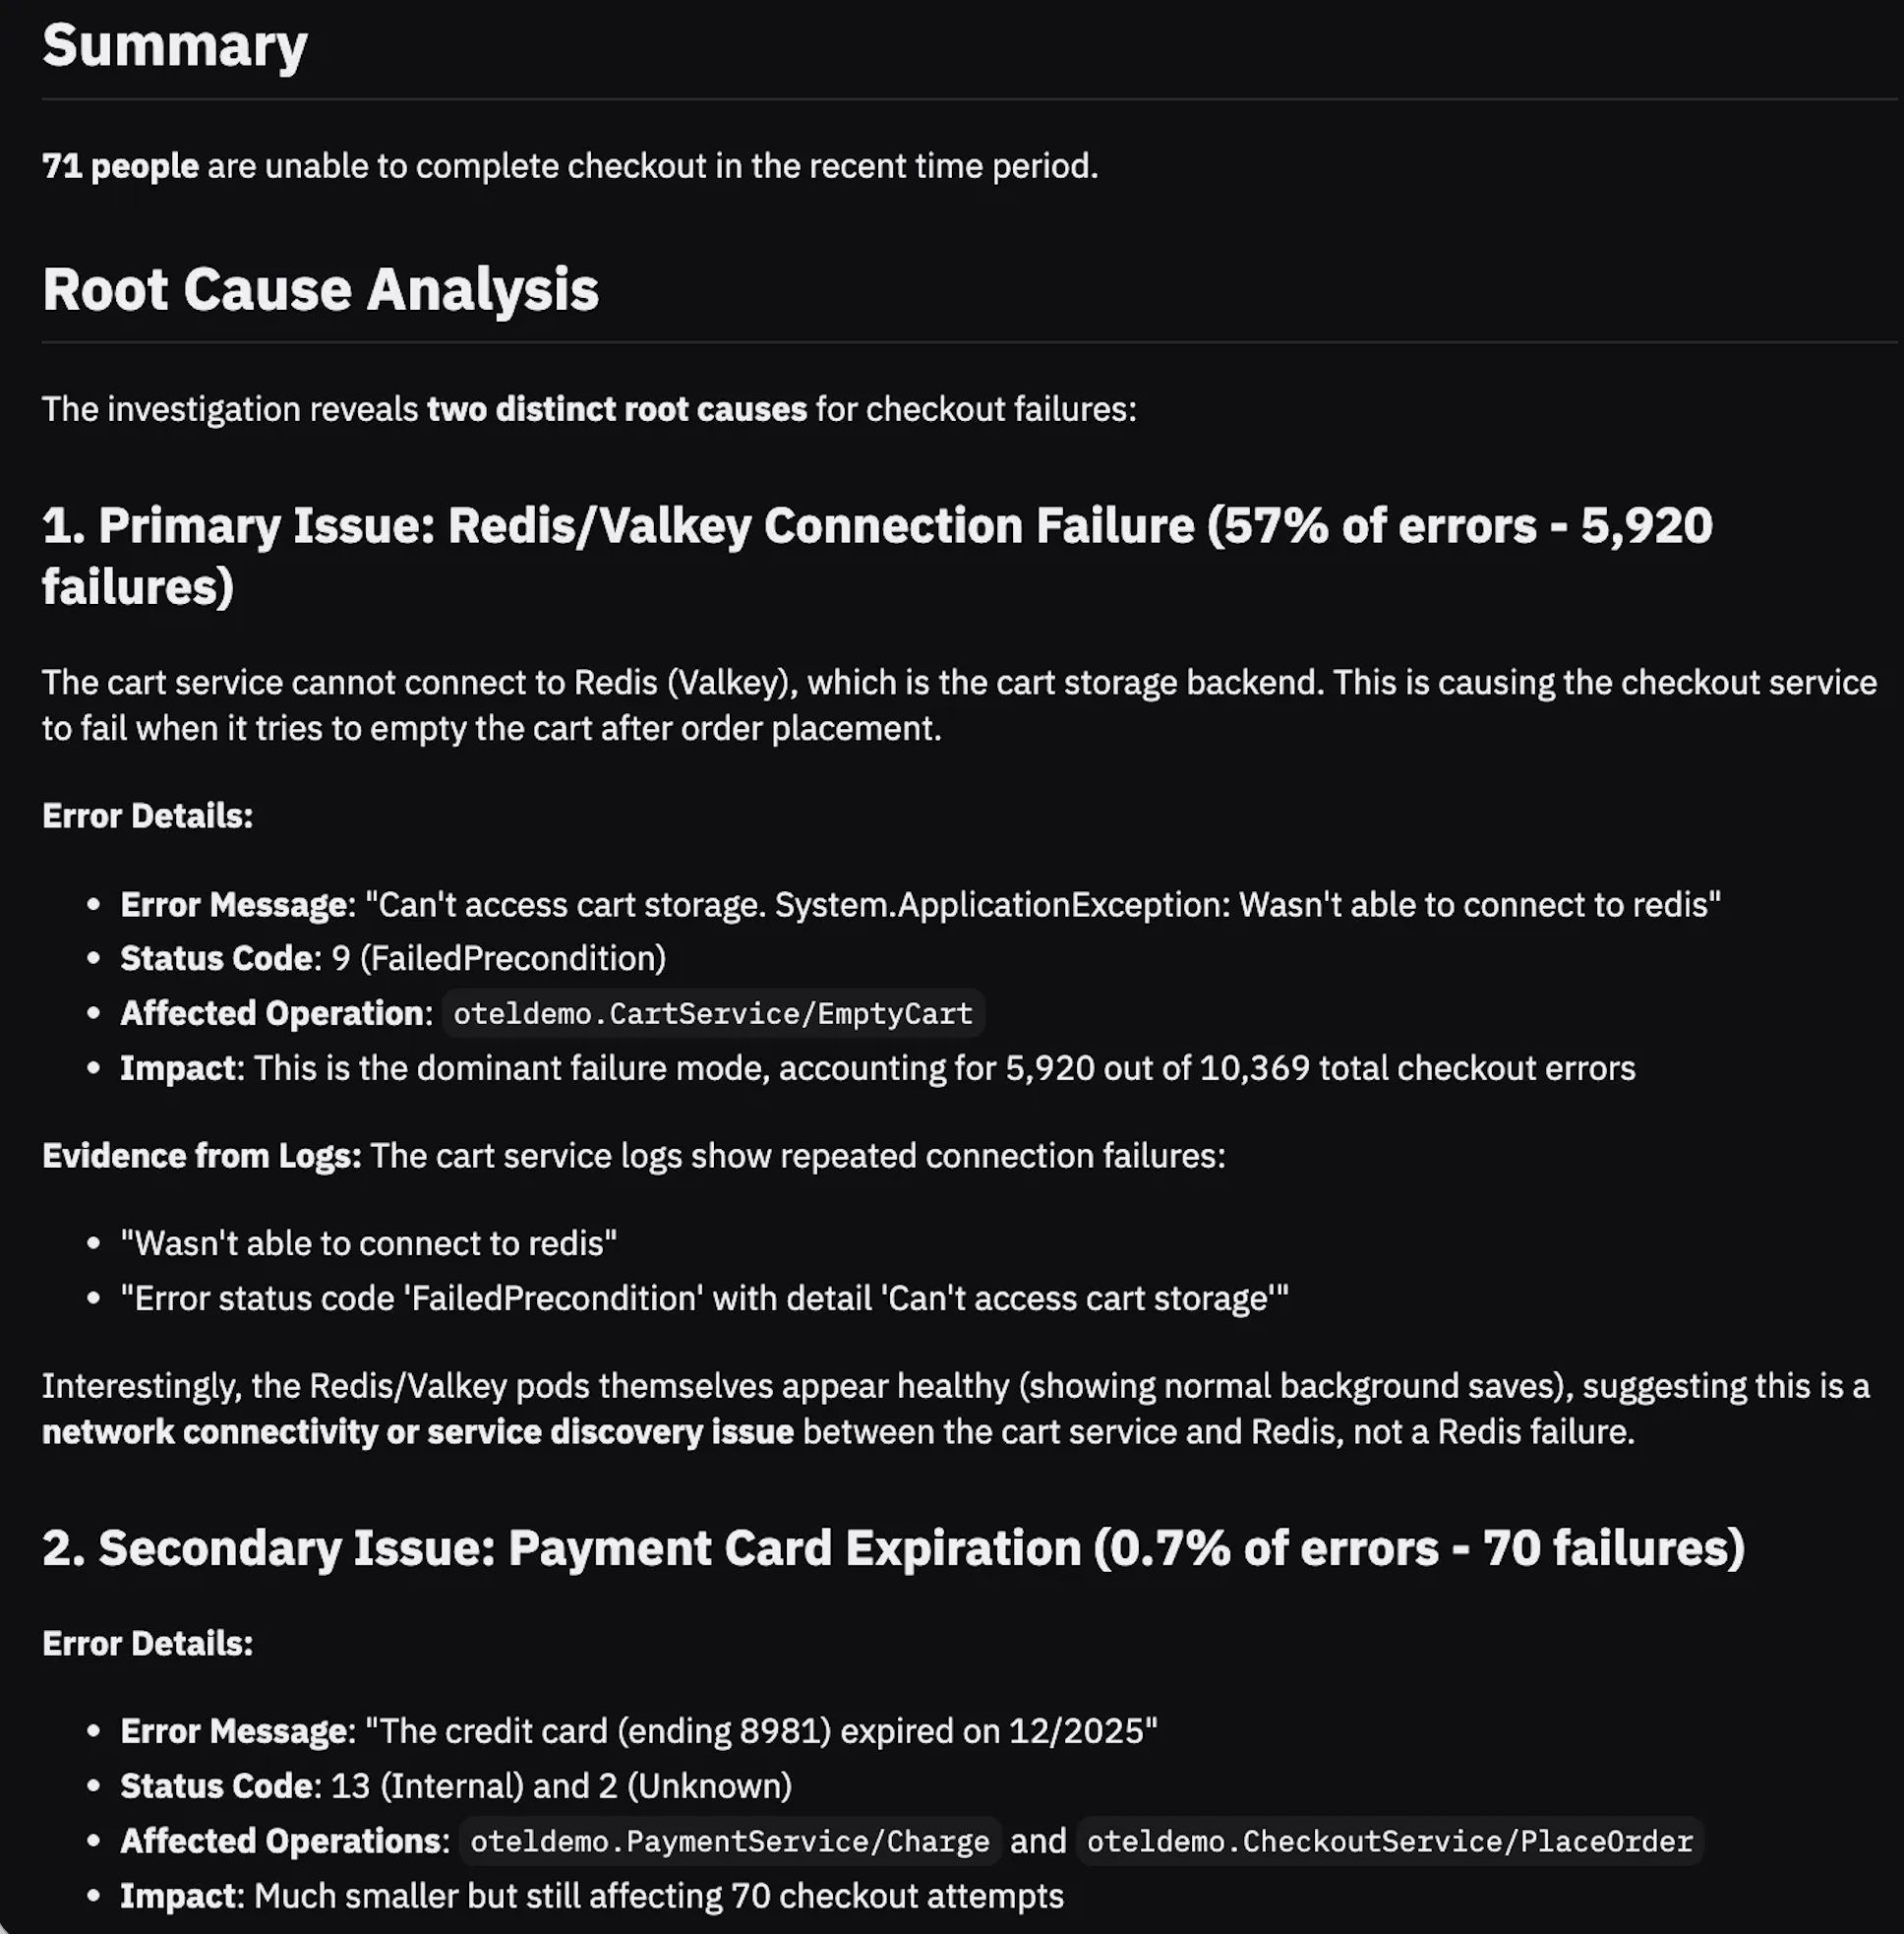
IA SRE s’appuie sur le même graphe de contexte d’observabilité dans le data lake de télémétrie que celui qui alimente le flux du parcours. Au lieu de parcourir manuellement chaque étape, un ingénieur peut demander : « Qu’est-ce qui provoque le pic d’échecs de paiement ? » IA SRE parcourt les interactions, services, traces et logs connectés, puis fournit en quelques secondes une enquête guidée, étayée par des preuves et des cartes de requête interactives pour approfondir l’analyse.
IA SRE peut générer d’importants gains de productivité dans les workflows d’observabilité. Les clients indiquent accomplir leurs tâches environ quatre fois plus vite en moyenne, certaines enquêtes étant jusqu’à dix fois plus rapides. (Découvrez comment IA SRE utilise la télémétrie unifiée et le graphe de contexte pour réduire le temps d’enquête.)
IA SRE suit également les relations définies dans vos données. Les connexions qui relient l’impact business à la mise en œuvre guident aussi l’enquête. Elles réduisent le délai entre la question et la réponse tout en préservant la traçabilité des preuves.
Les parcours clients au sein du graphe global de contexte d’observabilité
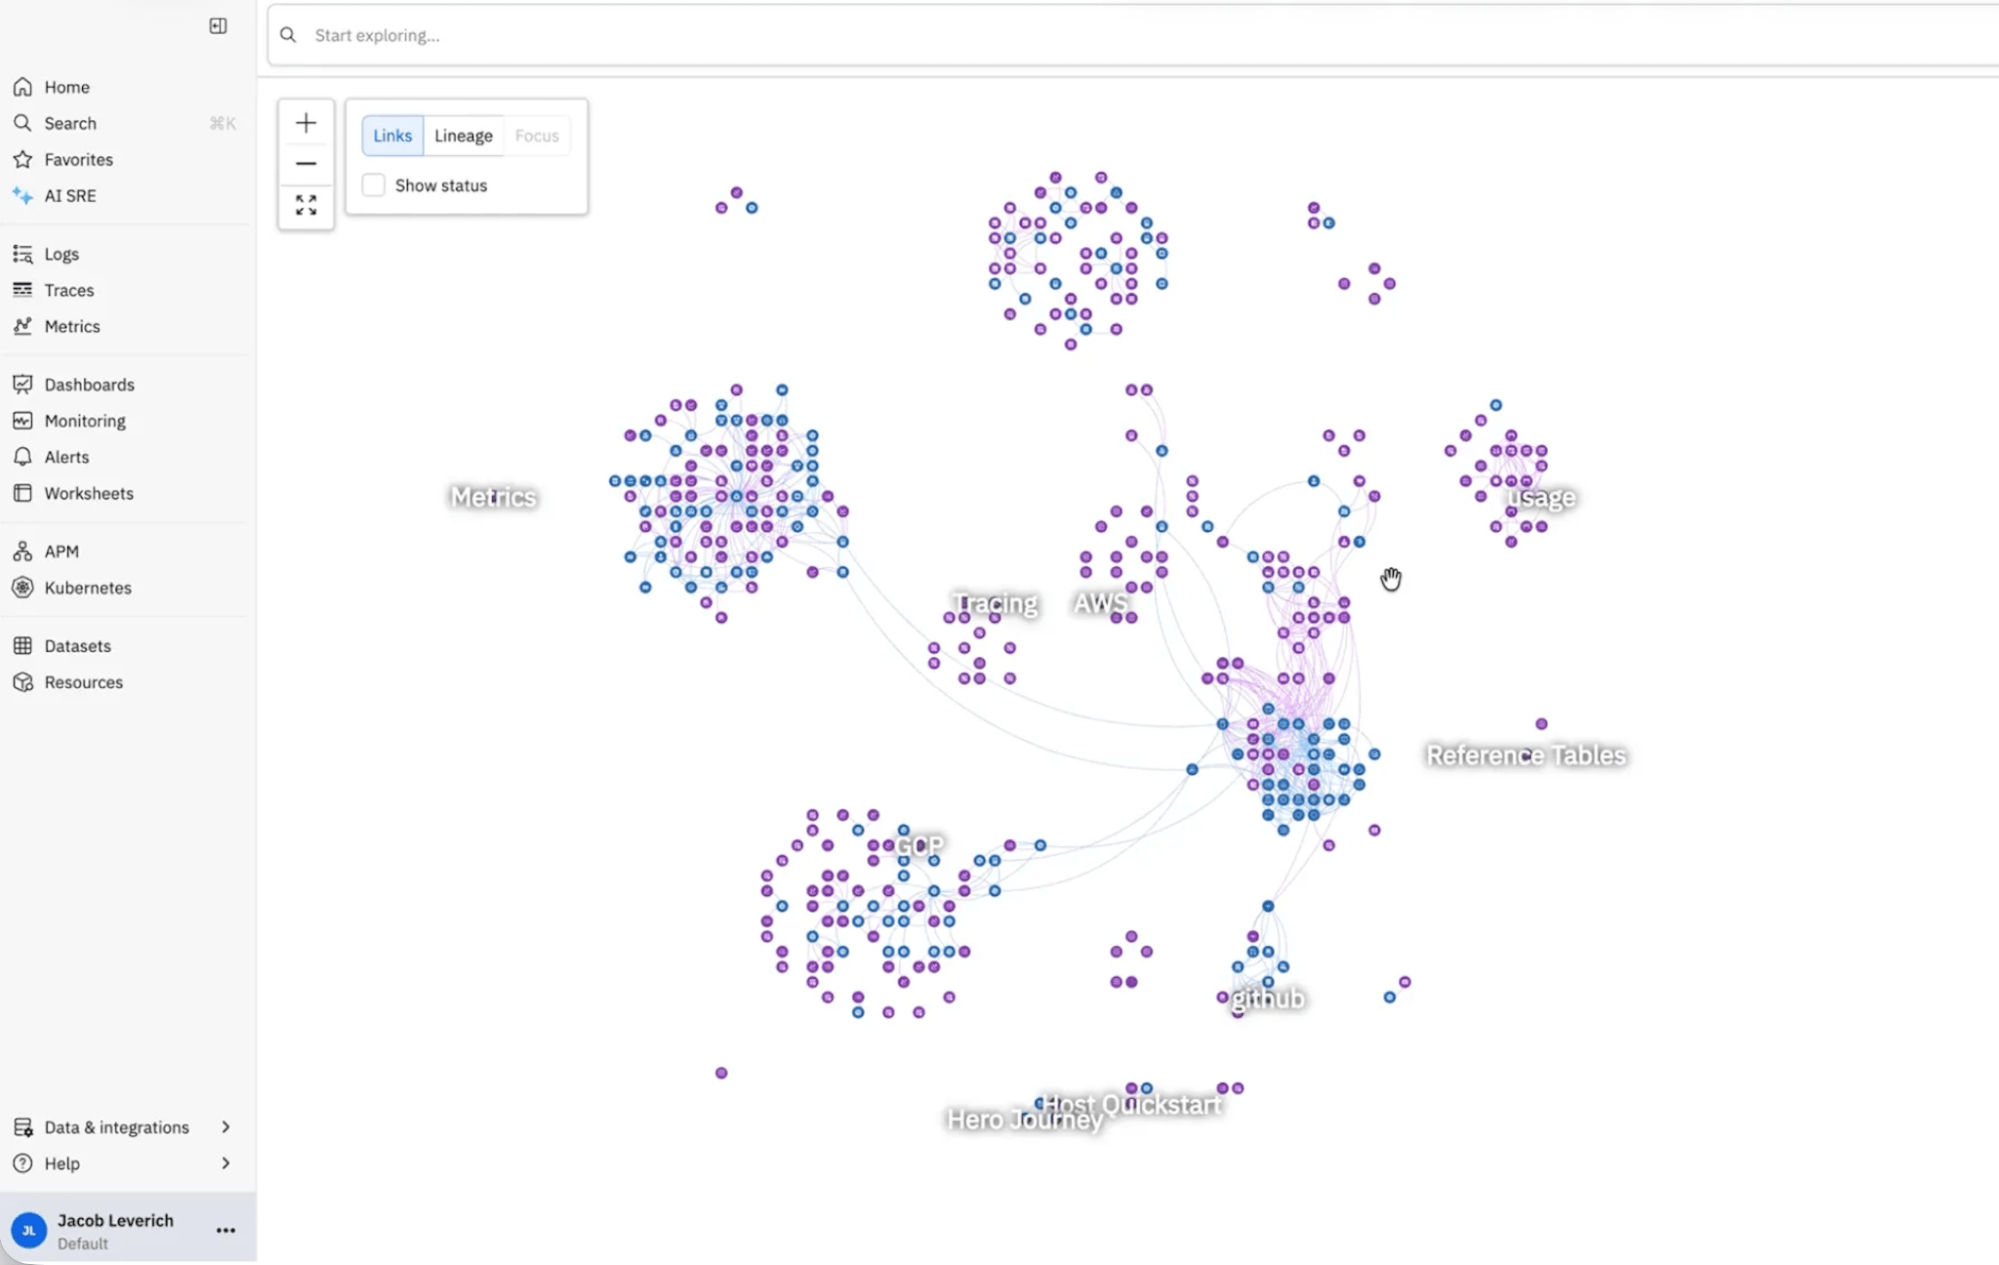
Le flux de parcours ci-dessus constitue un domaine du graphe plus vaste de contexte d’observabilité dans Observe. Toute la télémétrie ingérée dans le data lake de télémétrie est reliée par des relations modélisées qui reflètent les interactions entre les services, l’infrastructure et les entités business.
Les parcours clients structurent une partie de ce graphe autour des interactions business. D’autres domaines relient les ressources cloud, les données de modification et les systèmes externes comme AWS et GitHub aux services sur lesquels ils ont un impact. Chaque nœud et chaque arête reflètent les relations définies dans le modèle de données, plutôt que dans un tableau de bord prédéfini.
Lorsque vous passez d’une étape du parcours à un service, ou d’un service à une trace, vous parcourez ce graphe plus vaste. IA SRE s’appuie sur la même structure. Les parcours offrent un point d’entrée aligné sur les enjeux business dans un modèle partagé qui relie vos systèmes à votre contexte business.
De l’impact business à la cause première grâce à l’observabilité
Dans Observe, les parcours clients montrent comment une enquête qui part de l’impact business transforme le chaos en démarche structurée. Observe s’articule autour des relations d’un graphe de contexte reposant sur un data lake de télémétrie. Vous pouvez ainsi naviguer entre différents types de données selon les connexions réelles entre vos systèmes et vos entités business.
Le graphe de parcours permet d’organiser ces relations et fait partie des fonctionnalités natives d’Observe. Le même mécanisme s’applique à toute entité modélisée dans vos données : clients, transactions, expéditions, appareils, appels téléphoniques et réclamations. Une fois définies, ces relations fournissent à IA SRE le contexte nécessaire à l’analyse, sans avoir à apprendre à utiliser des tableaux de bord ni des runbooks pendant l’incident.
C’est le changement de perspective décrit par Capital One : commencez par l’expérience vécue par les clients, puis parcourez uniquement les données associées, sans perdre le contexte. Dans Observe, les parcours clients constituent un domaine d’un graphe plus vaste de contexte d’observabilité reposant sur le data lake de télémétrie. Comme ce graphe reflète les connexions entre les systèmes et les entités business, le chemin de l’impact business à la cause première est déjà défini, ce qui peut accélérer les enquêtes et les rendre plus efficaces.
Découvrez Observe by Snowflake et comment la solution transforme rapidement la télémétrie en insights.