10 settembre 2026/Lettura: 11 minAI e ML
Creare la contabilità fornitori AI-native su Snowflake
Nonostante i numerosi progressi nelle app enterprise, i processi di contabilità fornitori (AP) presentano ancora workflow ostinatamente manuali all’interno delle aziende.
Le fatture arrivano con layout, lingue e qualità dei file diversi. Alcune fanno riferimento a ordini di acquisto che sono cambiati nel tempo. Ad altre mancano metadati chiave richiesti da un ERP (Enterprise Resource Planning) prima che sia possibile registrare qualsiasi voce. Gli strumenti di automazione tradizionali riescono in genere a estrarre campi da un documento, ma i casi limite possono generare costi operativi, come formattazioni specifiche del fornitore, fatture senza ordine di acquisto (non-PO), corrispondenze di riga ambigue, dati aziendali frammentati e regole di business che variano da azienda ad azienda.
Per colmare questa lacuna, abbiamo creato InvoiceIQ, uno strumento che utilizziamo internamente in Snowflake.
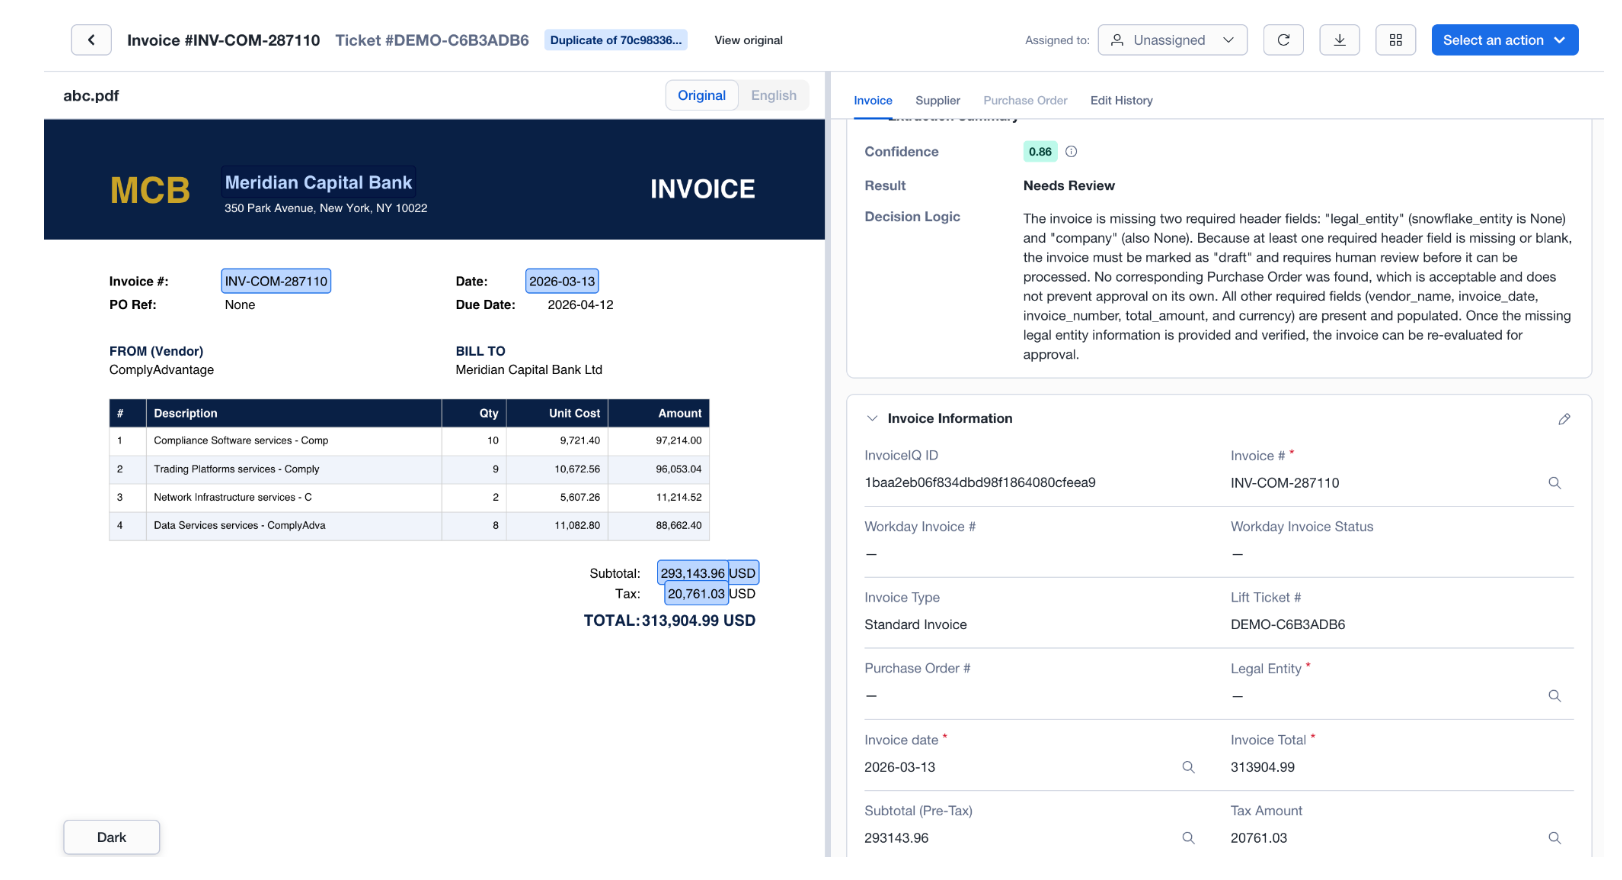
Figura 1: Dettaglio della fattura in InvoiceIQ.
Invece di trattare l’elaborazione delle fatture come un problema di parsing dei documenti, l’abbiamo ricostruita come un problema di dati governati e workflow eseguito direttamente su Snowflake. Il risultato è un’app di contabilità fornitori nativa Snowflake che combina comprensione dei documenti, arricchimento aziendale, regole di business e invio all’ERP in un unico sistema.
In questo articolo parleremo di:
- Perché l’automazione tradizionale della contabilità fornitori lascia sul tavolo troppo valore
- Perché abbiamo scelto un’architettura nativa Snowflake
- Come InvoiceIQ trasforma le fatture non elaborate in record pronti per la finanza
- Cosa abbiamo imparato eseguendo workflow guidati dall’AI in produzione
Il vero collo di bottiglia dell’automazione AP
I moderni modelli multimodali sono già in grado di leggere le fatture. La sfida tecnica non è più se l’AI sia in grado di vedere il testo su una pagina. La domanda più difficile, piuttosto, è come rendere affidabile la comprensione del modello all’interno di un vero workflow finanziario.
In pratica, l’automazione AP fallisce meno perché un modello non è in grado di leggere un documento e più perché il workflow che circonda quel documento è frammentato. I dati risiedono in più sistemi. Le funzionalità AI SaaS sono spesso generiche e difficili da adattare ai workflow AP specifici di ogni azienda. I pattern di integrazione non sono progettati per workflow adattivi. E le eccezioni più importanti sono spesso specifiche dei fornitori, delle policy e dei requisiti ERP di ciascuna azienda.
Questo è l’ultimo miglio che InvoiceIQ è stato progettato per colmare. Internamente, abbiamo definito il problema come la creazione di un sistema in grado di ridurre la revisione manuale, migliorare il controllo e creare un pattern riutilizzabile per le app AI costruite direttamente su dati aziendali governati.
Perché l’abbiamo costruito nativamente su Snowflake
Fin da subito abbiamo adottato una posizione architetturale semplice: mantenere il workflow vicino ai dati, mantenere deterministiche le parti deterministiche e usare l’AI come un livello all’interno di un sistema più ampio, invece di trasformare l’intero workflow in un agente AI opaco.
Questa decisione era importante perché i dati di cui avevamo bisogno erano già in Snowflake. Ordini di acquisto, dati anagrafici dei fornitori, fatture storiche, configurazioni, stato delle code e record di invio a valle erano già disponibili oppure potevano essere modellati lì. Invece di esportare questo contesto in un mosaico di servizi esterni, abbiamo portato la logica applicativa ai dati.
InvoiceIQ funziona all’interno di Snowflake utilizzando Snowpark Container Services (SPCS), con coordinamento del workflow, configurazione e cronologia di audit che restano anch’essi in Snowflake. Questo ci offre un unico perimetro di sicurezza, operazioni più semplici e un sistema più facile da analizzare quando qualcosa va storto.
Come funziona InvoiceIQ
A livello generale, InvoiceIQ elabora ogni fattura attraverso sei fasi: classificazione, estrazione, traduzione, corrispondenza, arricchimento e decisione. Ogni fase ha una responsabilità specifica e, insieme, trasformano un PDF non elaborato in un record pronto per la finanza che può essere inviato a Workday o indirizzato a un analista con un ragionamento chiaro.
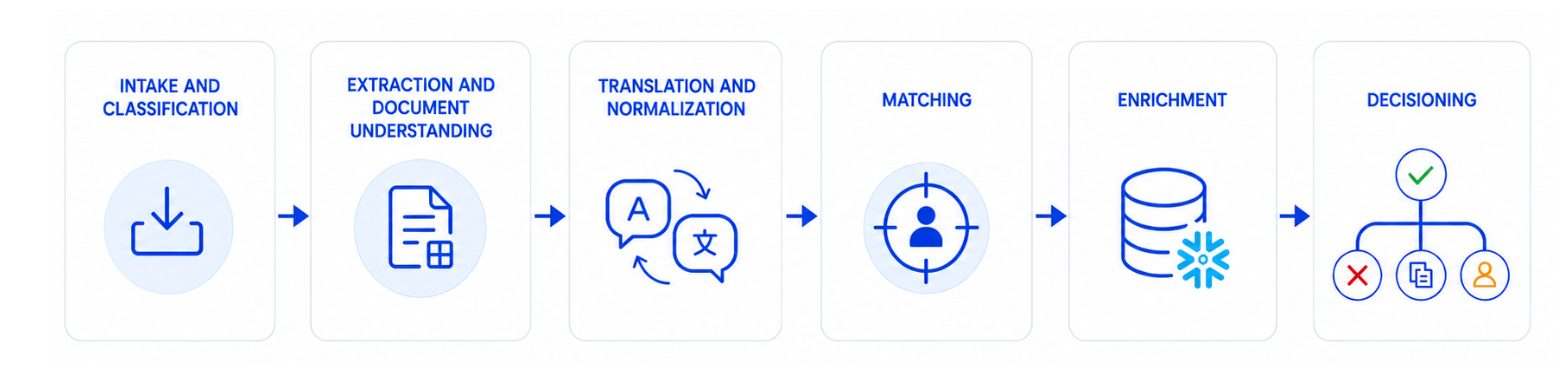
Figura 2: Panoramica della pipeline di InvoiceIQ.
Classificazione
Il primo passaggio consiste nel determinare se un file caricato sia effettivamente una fattura.
Può sembrare banale, ma in pratica i team AP ricevono ricevute, ordini di acquisto, estratti conto e documenti di supporto insieme alle fatture. InvoiceIQ li filtra tempestivamente utilizzando AI_PARSE_DOCUMENT insieme a AI_CLASSIFY, in modo che il resto della pipeline dedichi tempo solo ai documenti rilevanti per il workflow delle fatture.
Estrazione e comprensione dei documenti
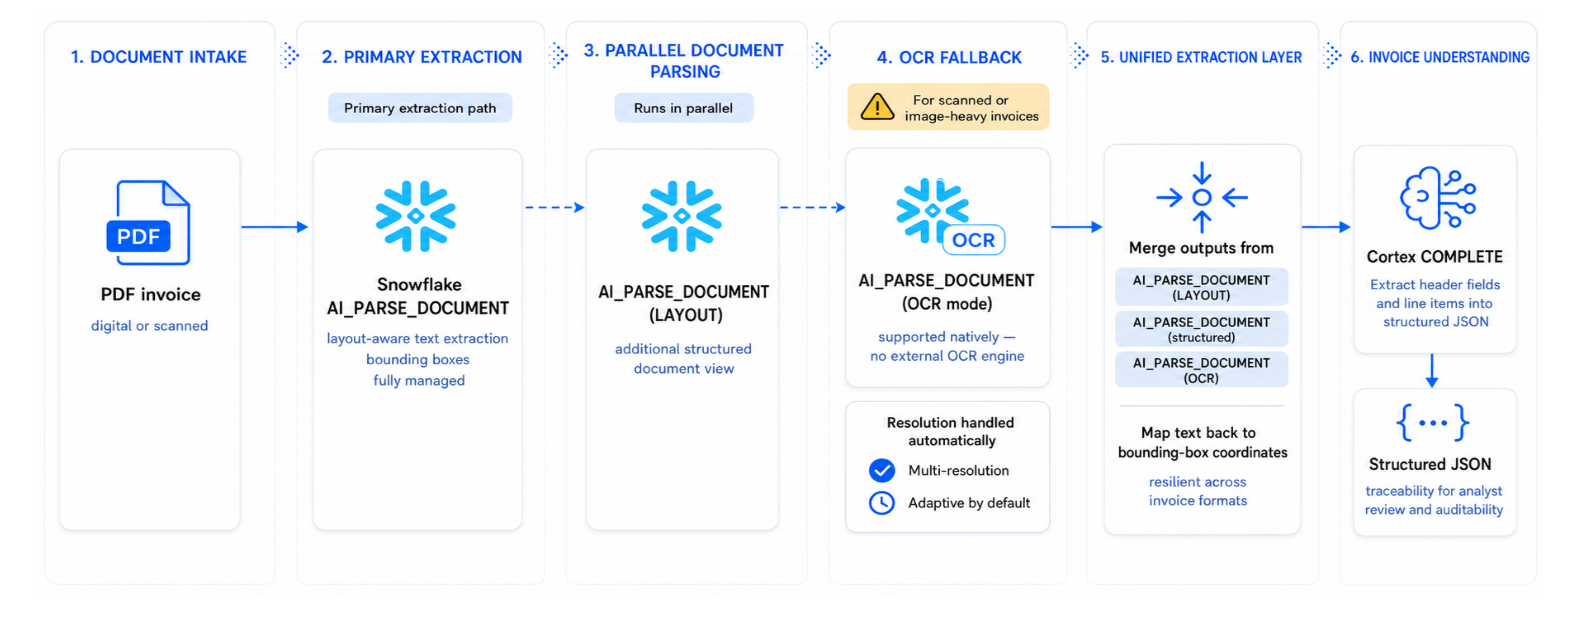
Figura 3: Pipeline di estrazione dei documenti, dall’acquisizione del PDF alla comprensione della fattura.
L’estrazione è un processo deliberatamente articolato in più fasi.
InvoiceIQ utilizza i servizi di document intelligence di Snowflake per sviluppare una visione strutturata di ogni fattura, recuperare testo e informazioni di layout e preservare la tracciabilità rispetto al documento di origine per la revisione da parte degli analisti.
Una volta assemblato il testo, AI_COMPLETE lo converte in dati strutturati della fattura, come campi di intestazione e voci di riga. È il punto in cui il sistema passa dal contenuto grezzo del documento a una rappresentazione su cui il business può effettivamente operare.
Traduzione e normalizzazione
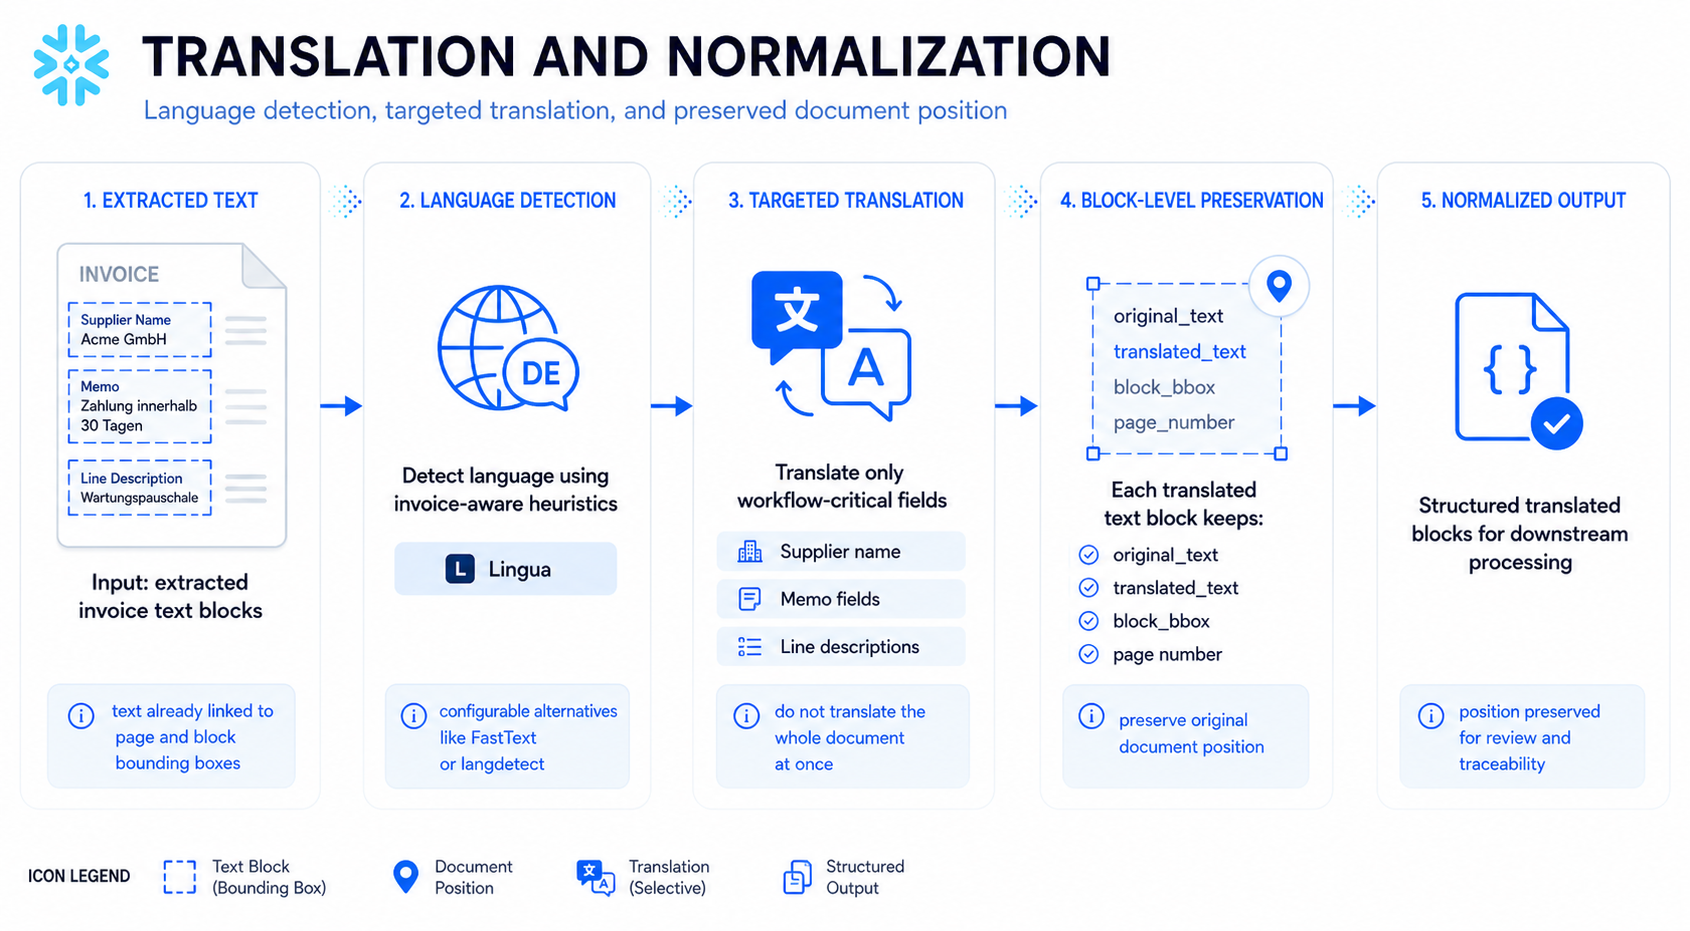
Figura 4: Workflow di rilevamento della lingua e traduzione.
La traduzione delle fatture non viene trattata come una fase di pre-elaborazione generica.
La pipeline rileva prima la lingua utilizzando segnali specifici della fattura provenienti dal documento stesso, poi traduce le sezioni pertinenti utilizzando CORTEX.TRANSLATE, preservando la posizione originale nel documento e conservando sia il testo originale che quello tradotto per la revisione.
Questo è importante perché le fatture sono spesso scarne di testo, numeriche e strutturalmente irregolari. Tradurre esattamente i campi che influiscono sulla qualità del workflow è più utile che eseguire una traduzione generica dell’intero documento perdendo il contesto lungo il percorso.
Corrispondenza
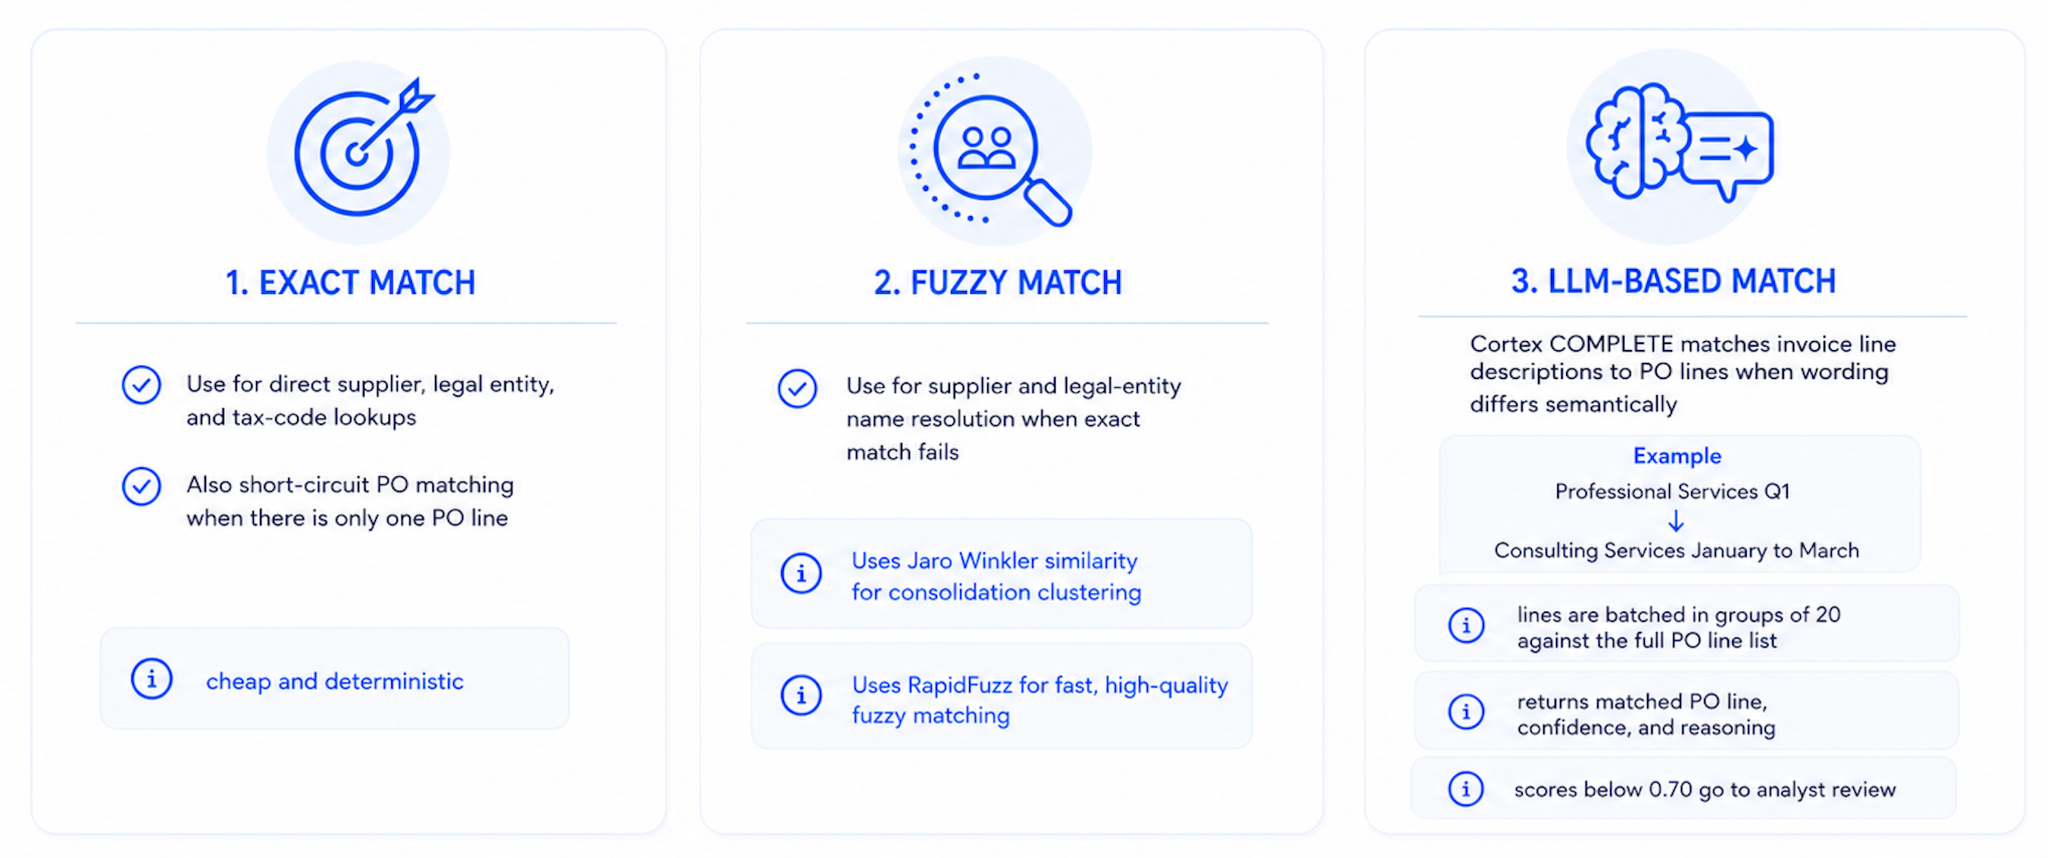
Figura 5: Approcci di corrispondenza delle fatture.
Per le fatture collegate a un ordine di acquisto, la corrispondenza è il punto in cui l’AI diventa operativamente rilevante.
InvoiceIQ utilizza tre diversi metodi di corrispondenza per tre scopi diversi. La corrispondenza esatta funziona come una scorciatoia a basso costo quando le stringhe corrispondono già. JAROWINKLER_SIMILARITY aiuta a risolvere nomi di fornitori ed entità legali poco puliti. E AI_COMPLETE esegue la corrispondenza semantica tra righe di fattura e righe dell’ordine di acquisto quando la formulazione è diversa ma il significato aziendale è lo stesso.
Questo consente al sistema di collegare righe di fattura come “Professional Services Q1” a una riga dell’ordine di acquisto con una descrizione più formale o formulata in modo diverso, senza costringere un analista a riconciliare manualmente ogni discrepanza.
Arricchimento
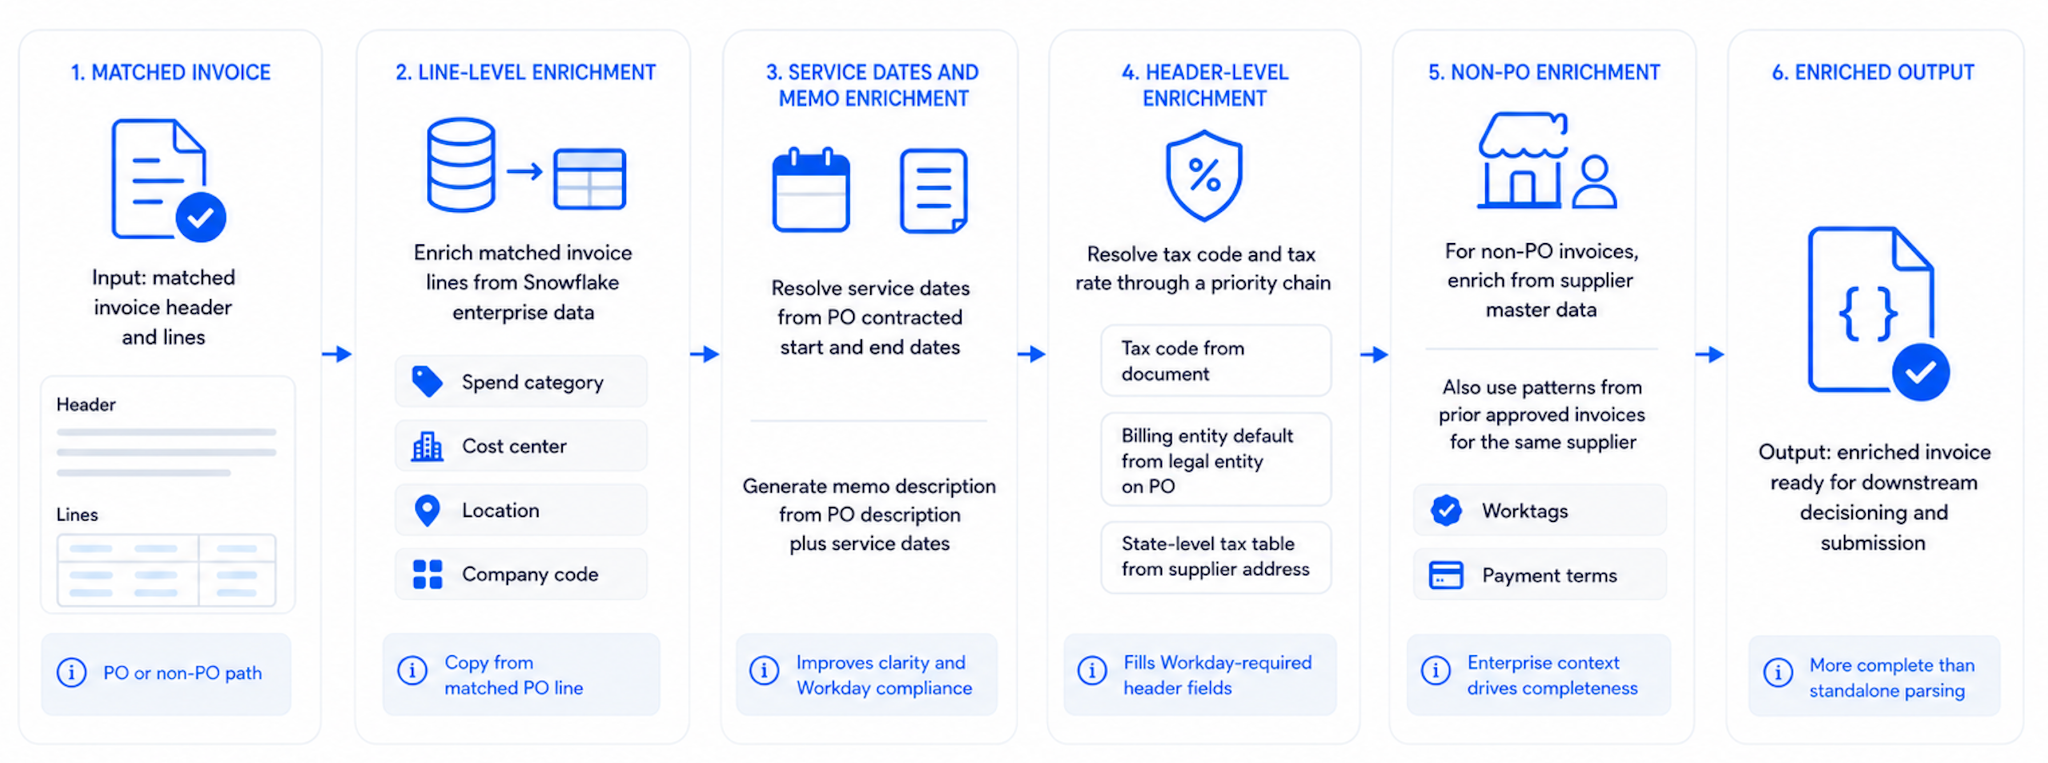
Figura 6: Arricchimento intelligente per le fatture.
L’estrazione ci dice cosa contiene la fattura. L’arricchimento ci dice quale dovrebbe essere il record aziendale finale.
Una volta che le righe sono state associate, InvoiceIQ recupera il contesto aziendale dai systems of record presenti in Snowflake. Questo include campi come categoria di spesa, centro di costo, sede, codice azienda, date del servizio, termini di pagamento e valori relativi alle imposte.
Questa è una delle scelte di progettazione più importanti del sistema. Non presupponiamo che il PDF debba essere la fonte di verità definitiva per ogni campo. I team possono invece scegliere quali dati devono provenire dal documento e quali devono essere sovrascritti dai sistemi interni e dalle policy aziendali. Per le fatture collegate a un ordine di acquisto, il system of record dell’ordine di acquisto può avere la precedenza. Per le fatture senza ordine di acquisto, il contesto relativo al fornitore e quello storico possono colmare ciò che manca nel documento.
Questo rende l’app molto più adattabile alle operazioni AP specifiche di ogni azienda rispetto a quanto potrebbe mai fare un parser autonomo.
Decisione e invio
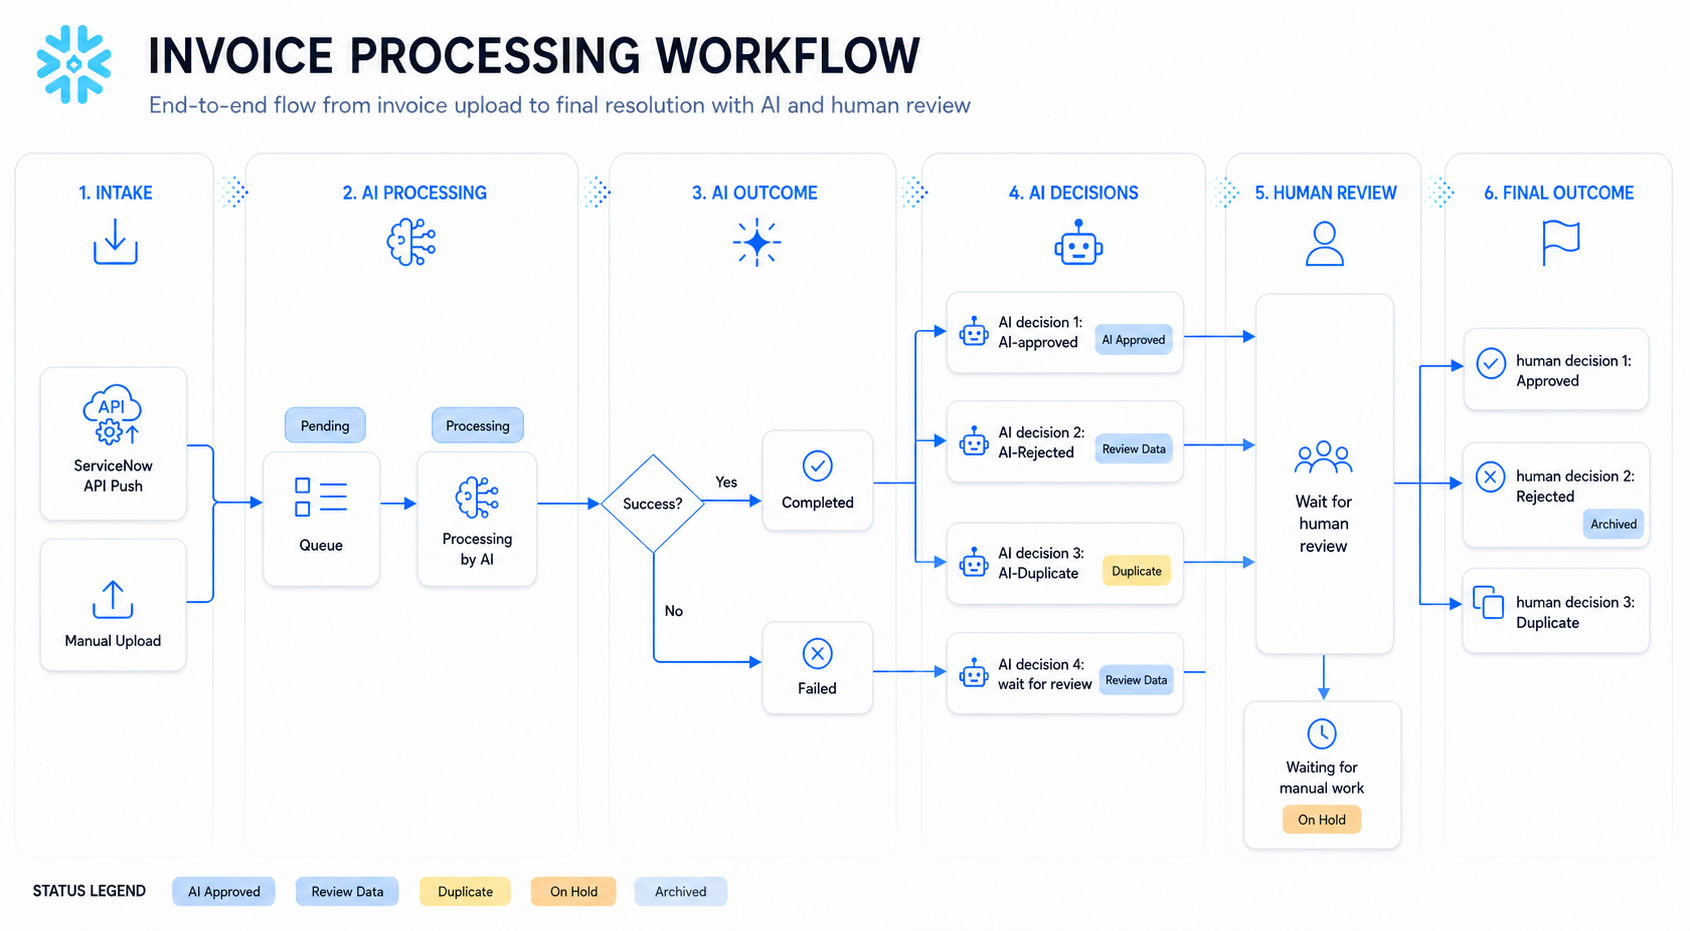
Figura 7: Ciclo di vita della fattura in InvoiceIQ.
Dopo le fasi di corrispondenza e arricchimento, il sistema determina l’azione successiva.
Le fatture entrano attraverso un processo di integrazione via email o un caricamento manuale, passano attraverso l’elaborazione AI e ricevono quindi un esito iniziale come approvata, rifiutata, duplicata o revisione richiesta. Gli elementi che richiedono attenzione vengono assegnati agli analisti, mentre i casi senza problemi possono procedere con uno sforzo umano molto inferiore rispetto a quello richiesto da una coda AP tradizionale.
Il punto importante non è che ogni fattura diventi completamente autonoma. È che la revisione umana viene riservata ai casi in cui è effettivamente necessario un giudizio, e questi casi arrivano con un contesto strutturato invece di una schermata vuota.
Eseguire workflow AI in produzione
Rilasciare funzionalità AI è solo metà del processo. Farle funzionare in modo affidabile su larga scala, in sicurezza, con osservabilità e senza un team ops dedicato, è l’altra metà. InvoiceIQ si affida alla piattaforma Snowflake per gestire nativamente ciascuno di questi aspetti.
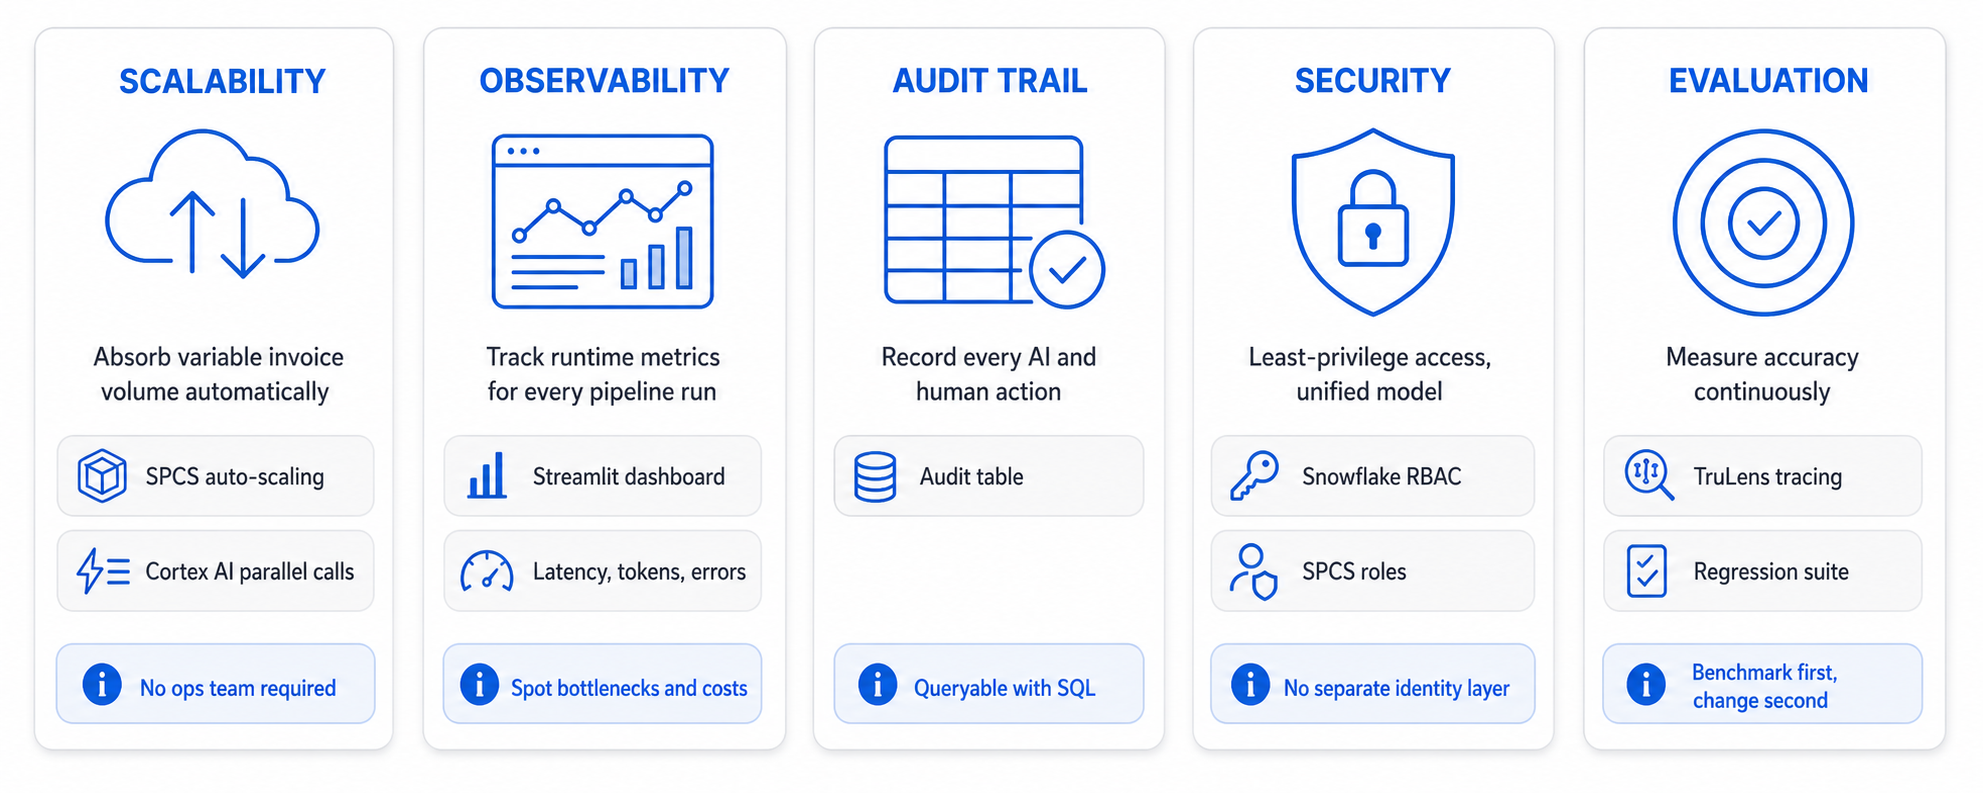
Figura 8. I cinque pilastri che permettono a InvoiceIQ di funzionare in produzione su Snowflake: scalabilità, osservabilità, audit trail, sicurezza e valutazione.
Scalabilità: autoscaling SPCS e inferenza AI parallela
InvoiceIQ può assorbire volumi di fatture variabili senza intervento manuale, perché SPCS scala automaticamente la capacità di calcolo in base alla domanda, mentre Cortex AI Functions di Snowflake vengono eseguite in parallelo all’interno del livello di calcolo di Snowflake. Questo consente l’esecuzione in parallelo di più passaggi di inferenza all’interno di un’unica pipeline, senza hop di rete aggiuntivi, gestione personalizzata dei rate limit o un team operativo dedicato.
Osservabilità: ogni token conta
L’osservabilità in InvoiceIQ riguarda il comportamento in fase di esecuzione: ogni esecuzione della pipeline scrive metriche operative in Snowflake, tra cui la latenza per ogni fase, l’utilizzo di token per ogni chiamata Cortex AI e il conteggio di errori e retry. Questa telemetria alimenta una dashboard Streamlit che aiuta gli ingegneri a individuare i colli di bottiglia, comprendere i costi per fattura e monitorare le prestazioni del modello nel tempo.
Audit trail: l’auditing come componente di prima classe
L’audit trail ha uno scopo diverso: registra cosa è successo, non quanto efficientemente ha funzionato il sistema. Ogni azione basata sull’AI o eseguita da una persona scrive un evento in una tabella di audit Snowflake, rendendo l’intera cronologia interrogabile con SQL, facile da collegare tramite join ai dati contabili correlati e prontamente disponibile per la conformità o il reporting operativo.
Sicurezza e controllo degli accessi: controllo degli accessi basato sui ruoli (RBAC) di Snowflake e SPCS
La sicurezza segue lo stesso modello di controllo degli accessi basato sui ruoli di Snowflake utilizzato nel resto dell’account. Ogni servizio SPCS viene eseguito con un ruolo Snowflake dedicato che dispone solo delle autorizzazioni necessarie, e analisti, ingegneri e service account operano tutti con ruoli con ambito limitato. Il risultato è un unico modello a privilegi minimi applicato sia alle persone che ai servizi, senza livelli IAM separati, rotazione manuale delle credenziali o infrastrutture esterne per la gestione dei secret.
Valutazione: TruLens e test di regressione
InvoiceIQ misura la qualità in modo continuo, invece di trattare l’accuratezza come un controllo puntuale. TruLens traccia e valuta le chiamate agli LLM lungo tutta la pipeline in base a segnali come la pertinenza e la groundedness, mentre una suite di regressione verifica ogni modifica confrontandola con fatture reali con ground truth verificata da persone. Questo approccio basato prima di tutto sui benchmark rende più sicura l’adozione di nuovi prompt, modelli e funzionalità AI di Snowflake, offrendo al team un modo per individuare eventuali regressioni della qualità prima che raggiungano l’ambiente di produzione.
Conclusioni
C’è ancora molto margine di miglioramento per l’automazione delle fatture. Ma le fondamenta sono già state gettate.
Ricostruendo l’AP attorno a servizi nativi Snowflake, dati aziendali governati e funzioni AI mirate, siamo andati oltre la semplice estrazione delle fatture, verso un sistema in grado di operare realmente in condizioni aziendali concrete. Il risultato non è una black box completamente autonoma. È qualcosa di più utile: un workflow controllabile, ispezionabile ed estendibile, che inserisce l’AI dove è più utile e mantiene il resto del sistema saldamente ancorato alla verità aziendale.
Cosa è cambiato per il business
InvoiceIQ è stato progettato per migliorare sia l’efficienza che il controllo.
Durante il rollout interno, il team è riuscito a spostare la maggior parte delle fatture dei fornitori all’elaborazione tramite InvoiceIQ, abilitando un workflow AP agentico basato sui nostri stessi dati, con analisi dei dati e insight basati su AI disponibili da subito al go-live grazie a Snowflake CoCo. Altrettanto importante, il sistema ha creato una base tecnica più solida per la futura automazione dell’AP: una base in cui regole di business, logica di enrichment, comportamento del modello e tracciabilità possono evolvere insieme.
Le fatture pulite possono passare dalla casella di posta all’ERP in pochi minuti. Le eccezioni arrivano già precompilate con il contesto necessario. E i team hanno un percorso per continuare a migliorare l’accuratezza nel tempo, senza dover ricostruire l’applicazione a ogni nuovo ciclo di modelli.