2 juin 2026/Lecture : 8 minProduit et technologie
Simplifiez tout le cycle de développement des données

Lorsqu’elles atteignent les systèmes censés les exploiter, la plupart des données d’entreprise sont souvent déjà obsolètes. Ce décalage fait toute la différence entre une réponse utile fournie par des agents d’IA et une erreur coûteuse. L’IA agentique ne peut prendre des décisions intelligentes que si elle accède en continu à des informations actualisées.
À mesure que les entreprises déploient l’IA agentique en production, les équipes de data engineering doivent se tourner vers des pipelines en temps réel et des architectures événementielles. Elles doivent ainsi connecter et gouverner davantage de sources, même lorsque celles-ci évoluent constamment. Or, ce que les équipes doivent créer dépasse désormais les capacités de leur plateforme data.
Lors du Summit 2026, Snowflake renforce sa plateforme pour aider les équipes de data engineering à réussir à l’ère de l’IA. Parmi les nouveautés phares figurent un service de streaming natif compatible avec Apache Kafka et des fonctionnalités optimisées par l’IA qui réduisent les coûts de déplacement et de migration des données.
Ces améliorations réduisent le temps consacré à la gestion de l’infrastructure et à l’orchestration manuelle. Les data engineers peuvent ainsi délaisser la tuyauterie pour se concentrer sur les résultats rendus possibles par l’IA, avec Snowflake CoCo comme fil conducteur pour transformer une configuration complexe en conversation guidée.
Streamez les données au rythme qu’exige par l’IA
Les agents observent, décident, agissent et apprennent, puis réinjectent cet apprentissage dans la décision suivante. Chaque boucle de décision doit rendre la réponse suivante plus précise, plus personnalisée et plus exploitable. Ce cycle fonctionne en continu. Les données qui l’alimentent doivent donc circuler en continu elles aussi. Les Entreprises qui utilisent déjà Kafka disposent de l’infrastructure de streaming nécessaire à ce cycle. Mais exploiter cette infrastructure en parallèle d’une plateforme analytique distincte revient à financer, gouverner et administrer deux systèmes différents, alors même que les données arrivent encore trop tard là où les décisions sont réellement prises.
Datastream (bientôt en private preview) est le service de streaming natif de Snowflake compatible avec Apache Kafka. Il regroupe ces frais opérationnels au sein d’une seule plateforme gouvernée. Les données arrivent en continu sous forme de tables Snowflake natives ou de tables Apache Iceberg™ ouvertes, interrogeables en quelques secondes. Les topics sont sécurisés grâce au contrôle d’accès basé sur les rôles (RBAC) de Snowflake, tandis que les tables bénéficient de toute la puissance d’Horizon Catalog, notamment de la classification, du lignage et des politiques de masquage. Les données sont gouvernées dès leur arrivée. Décrivez simplement le pipeline de streaming dont vous avez besoin : CoCo prend en charge l’authentification de Datastream et permet aux équipes d’être opérationnelles en quelques minutes, sans expertise approfondie de Kafka.
Datastream est spécialement conçu pour les entreprises qui souhaitent remplacer leur infrastructure Kafka par un service Snowflake natif. Snowpipe Streaming High-Performance Architecture est une API d’ingestion directe destinée aux équipes qui diffusent les données de leurs propres applications, notamment depuis des clusters Kafka existants via Kafka Connector. Aujourd’hui, Cboe Global Markets, opérateur de marchés financiers, traite chaque jour 190 milliards de lignes de données de marché et les interroge en moins de 30 secondes. Traders et analystes bénéficient ainsi d’une visibilité en temps réel sur l’activité des marchés. Lors de Summit, les améliorations apportées à Snowpipe Streaming incluent :
- Kafka Connector 4.0 (disponible pour tous nos clients) assure une ingestion côté serveur allant jusqu’à 10 Go/s par table et réduit jusqu’à 30 % les ressources côté client1. Les équipes peuvent ainsi faire évoluer le débit sans alourdir les coûts.
- Error logging (disponible pour tous nos clients) consigne les lignes en échec dans une table interrogeable en SQL, avec l’intégralité de leur contexte. Les équipes peuvent ainsi détecter les problèmes de qualité des données avant que les agents n’agissent sur des informations erronées.
- Grâce à la prise en charge de SDK multilangages (disponible pour tous nos clients), les équipes peuvent diffuser des données depuis leur stack habituelle, notamment Java, Python, Node.js et une interface REST.
- Elastic Channels (en private preview) permet à des milliers de clients de diffuser simultanément plusieurs gigaoctets par seconde vers une table, via un point de terminaison partagé qui s’adapte automatiquement. Les équipes réduisent ainsi le temps nécessaire pour créer et faire évoluer leurs pipelines de streaming.
- Durable Acknowledgments (en private preview) élimine le risque de perte de données entre l’ingestion et la validation. Les pipelines stratégiques ne transmettent jamais de données incomplètes aux agents.
Des pipelines autonomes
L’ingestion des données dans Snowflake en temps réel ne représente que la moitié du travail. L’autre moitié consiste à transformer ce flux brut en données réellement exploitables par les analystes, les modèles et les agents. Cette couche de transformation doit fonctionner en continu, gérer elle-même les nouvelles tentatives et la logique d’actualisation, et rester fiable sans nécessiter la surveillance permanente d’un data engineer dédié. Les équipes avancent plus vite lorsque les pipelines se gèrent eux-mêmes.
Lors de Summit, Sergey Labetsik de Wind Creek Hospitality a montré comment la migration d’un job batch dbt, jusque-là exécuté toutes les 30 minutes, vers un pipeline Dynamic Tables avait ramené la latence de bout en bout à moins d’une minute. Les clients reçoivent ainsi leurs bons de restauration dès qu’ils les obtiennent.
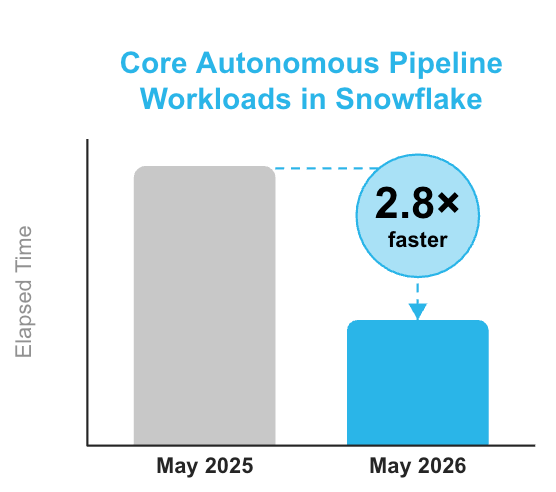
Cette approche déclarative est désormais plus rapide et plus flexible. Les améliorations de performance (disponibles pour tous nos clients) accélèrent jusqu’à 2,8 fois l’actualisation des charges de travail Dynamic Tables courantes2. Custom incrementalization (en public preview) permet aux data engineers d’utiliser des instructions MERGE ou INSERT pour les transformations qui ne peuvent pas être exprimées de manière déclarative, tout en conservant toute l’automatisation de Dynamic Tables.
DCM Projects (en public preview) offre aux équipes un workflow unique et contrôlé pour définir l’infrastructure de manière déclarative, prévisualiser et déployer les modifications dans différents environnements, et conserver une piste d’audit complète de chaque déploiement. dbt Projects on Snowflake, désormais encore plus rapide grâce à la prise en charge de Fusion (disponible pour tous nos clients), étend cette même approche aux utilisateurs de dbt.
Les compétences CoCo pour Snowpipe Streaming, Dynamic Tables and dbt Projects accélèrent la configuration et la résolution des problèmes dans ces workflows. Les data engineers peuvent ainsi se concentrer sur la logique des pipelines plutôt que sur le code standard.
Accédez aux données d’entreprise avec leur sémantique business, sans les déplacer
Certaines des données les plus précieuses d’une entreprise n’ont tout simplement pas besoin d’être déplacées. Elles résident déjà dans des plateformes d’entreprise essentielles comme SAP, Salesforce et Workday, avec leur signification business, leurs relations et leurs modèles sémantiques intégrés. Pour les dirigeants qui cherchent à mettre en production leurs initiatives d’IA, le coût de cette reconstruction constitue souvent le principal obstacle.
Au lieu de répliquer les données, les intégrations zéro copie rendent l’intelligence du système source directement accessible dans Snowflake : gouvernée, prête pour les requêtes et dotée de la richesse sémantique nécessaire au fonctionnement fiable des workloads d’IA. Les modèles et les agents exploitent des données qui conservent leur contexte business d’origine, plutôt que des répliques de tables appauvries.
SAP est désormais disponible pour tous nos clients via SAP BDC Connect for Snowflake, avec une intégration bidirectionnelle zéro copie. Les data engineers accèdent aux données SAP ERP pour l’IA, l’analytique et le data engineering, sans ETL complexe. En parallèle, les insights enrichis sont renvoyés vers SAP pour déclencher des actions automatisées. Salesforce Data 360, pionnier de l’intégration native zéro copie avec Snowflake, propose une expérience de connexion améliorée qui permet aux clients de partager leurs données dans les deux sens, sans aucune maintenance de pipeline. Workday entre en private preview et rend les données RH et financières accessibles sous forme d’Iceberg Tables gérées en externe, avec une capture incrémentielle des modifications au niveau de la couche de stockage.
Pour ces trois plateformes, l’architecture reste homogène : Les données restent dans le système source, deviennent accessibles dans Snowflake via Catalog-Linked Databases et bénéficient de l’ensemble du périmètre de gouvernance d’Horizon. Latraçabilité de bout en bout, les politiques d’accès et les pistes d’audit s’appliquent dès que les données deviennent visibles. Mieux encore, les compétences CoCo gèrent le cycle de vie. Les équipes peuvent ainsi configurer et maintenir les connexions à l’aide de prompts en langage naturel, et rendre l’intégration des données d’entreprise accessible à tout utilisateur de Snowflake.
Connectez le reste avec Snowflake Openflow
L’approche zéro copie convient aux plateformes d’entreprise qui ont investi dans des parcours d’intégration native. Mais de nombreuses données stratégiques résident encore dans des bases de données on-premise de traitement transactionnel en ligne (OLTP), des applications SaaS et des systèmes hérités qui n’ont jamais été conçus pour le partage.
Depuis son lancement l’an dernier, Openflow, le service managé d’intégration de données de Snowflake, par Apache NiFi, séduit un nombre croissant de clients qui regroupent leurs stacks de connecteurs fragmentés sur une plateforme unique. Cette dynamique entraîne une extension majeure de son périmètre lors du Summit.
Le déploiement managé de Snowflake est désormais disponible pour tous nos clients sur Google Cloud Platform, en complément d’AWS et d’Azure. Le Data Connectivity Proxy (bientôt disponible pour tous nos clients sur AWS) étend Openflow aux réseaux privés et permet de connecter des sources qui nécessitaient auparavant des développements sur mesure. Openflow prend en charge les données structurées et non structurées, le batch et le streaming, tout en restant ouvert et extensible. Les équipes peuvent créer des connecteurs personnalisés et les exécuter sur la plateforme managée de Snowflake sans renoncer au contrôle.
Dans Snowsight, un assistant de configuration guidée accompagne pas à pas l’installation des connecteurs et intègre la validation de la connectivité aux sources. Il devient ainsi simple de passer de la configuration à l’ingestion des données en quelques minutes. Lorsque les connecteurs signalent des erreurs, le dépannage assisté par l’IA, assuré par CoCo et directement intégré au Connector Monitoring Dashboard, analyse les journaux et propose des mesures correctives ciblées pour la bibliothèque Openflow en pleine expansion. Celle-ci comprend de nouveaux connecteurs très demandés, comme Veeva, BigQuery et MongoDB, tous en public preview. Ces connecteurs offrent une personnalisation assistée par l’IA pour accélérer le déploiement et fournir une visibilité plus approfondie sur les données propres à chaque secteur d’activité.
Créer et déployer avec Snowpark
Toutes les transformations ne se prêtent pas à un modèle déclaratif. Pour les data engineers et data scientists qui créent des solutions par programmation en Python, Java, Scala et Apache Spark™, les transformations impliquent notamment l’analyse complexe de fichiers, l’inférence ML par batch pour faire évoluer les traitements et des workflows Python en plusieurs étapes. Le défi : le déploiement en production peut prendre plus de temps que l’écriture du code lui-même. Snowpark réduit l’écart entre le prototype et la production.
Les principales nouveautés présentées lors du Summit incluent l’optimized ML batch inference (en public preview), pour un scoring plus rapide et plus efficace permettant de faire évoluer les traitements ; l’extension des Snowpark Data Integration APIs with JDBC support (en public preview), qui simplifie l’importation de données externes dans Snowflake ; File transform for Apache Spark (bientôt en public preview), pour les ETL de fichiers volumineux et complexes ; Snowpark Directory Import (disponible pour tous nos clients), qui simplifie le déploiement de projets Python multifichiers ; un visual DAG pipeline builder, pour orchestrer les Notebooks et les ML Jobs (en private preview) ; et Code Bundles, pour déployer du code Python et Java en production (bientôt en public preview).
Les compétences CoCo pour Snowpark Python et Apache Spark simplifient encore le déploiement et la migration de ces pipelines programmatiques. Les équipes peuvent passer d’un code Python ou Apache Spark local à des workflows prêts pour la production, avec une performance jusqu’à 5,1 fois supérieure et des coûts réduits de 42 %3.
Fixez votre objectif : Snowflake AIM s’occupe du reste
Rien ne ralentit autant une équipe data que le poids de l’existant. Outils ETL hérités, dialectes SQL vieillissants, schémas Oracle antérieurs à l’équipe d’ingénierie actuelle : les projets de migration ont la réputation méritée de s’éterniser, de dépasser les budgets et de faire peser des risques sur des workloads qui fonctionnaient parfaitement, jusqu’au jour où ce n’était plus le cas. De nombreuses entreprises finissent par maintenir l’ancien stack en parallèle de la nouvelle, doublant ainsi les coûts et les efforts de gestion pendant des mois, voire des années.
Snowflake AIM (migration optimisée par l’IA), désormais disponible pour tous nos clients, est une plateforme unifiée de migration, de modernisation et de virtualisation qui associe les technologies de SnowConvert AI, de Snowpark Migration Accelerator et de Datometry. Disponible via Snowflake CoCo, un agent de migration Snowflake AIM guide les équipes tout au long du parcours de bout en bout : Avant toute intervention en production, il dresse un état des lieux clair qui tient compte des dépendances et précise les éléments à déplacer, leur ordre de migration et les niveaux de risque associés. Des processus qui prenaient autrefois des semaines ou des mois s’effectuent désormais en une fraction de ce délai.
Le data engineer, architecte des résultats
Toutes ces annonces suivent la même tendance : réduire le temps que les data engineers consacrent au maintien des systèmes pour leur permettre de se concentrer davantage sur les résultats qui comptent. Les tâches qui mobilisaient autrefois les équipes d’ingénierie, de la maintenance des connecteurs au débogage des pipelines, deviennent plus rapides et plus simples à gérer à chaque nouvelle version. CoCo est le fil conducteur qui les relie.
Dans cet environnement, le rôle du data engineer ne cesse de gagner en importance. Son travail porte moins sur la tuyauterie que sur l’architecture du socle data qui alimente réellement l’IA. Snowflake reste déterminé à rendre la complexité invisible pour que les équipes data puissent se concentrer sur tout ce qu’elles rendent désormais possible.
- Datastream vous intéresse ? Participez
- Démo : utiliser Cortex Code avec Snowflake Openflow
- Démo : Créer des pipelines d’IA haute performance avec le streaming en temps réel et CoCo
- Démo : Déployer des pipelines Python avec CoCo en moins de 2 minutes
- Démo : Migrer le code PySpark vers Snowflake avec CoCo
- Snowflake Connect : data engineering | Créer des pipelines de transformation pour des données prêtes pour l’IA
- Les clients indiquent réduire jusqu’à 30 % le coût des ressources côté client grâce à l’architecture haute performance Snowpipe Streaming. Pour en savoir plus : Le streaming à grande échelle chez Snowflake : découvrez notre architecture Snowpipe Streaming nouvelle génération
- Améliorations des performances de Snowflake basées sur une charge de travail interne de transformation, mesurées au 4 mai 2025 avec Standard Warehouse et au 4 mai 2026 avec Gen2.
- Basé sur des cas d’usage de production et de démonstrations de faisabilité de clients comparant la vitesse et le coût de Snowpark par rapport aux services gérés de Spark entre novembre 2022 et mai 2025. Toutes les conclusions résument les résultats obtenus par nos clients avec des données réelles et ne représentent pas des ensembles de données inventés utilisés comme benchmarks.


