3 nov. 2026/Lecture : 12 minAnalytics
Analytique en temps réel sur Snowflake : bien frais et servis à point nommé, les flux coulent à flots
Chaque interaction client est une occasion de gagner leur confiance ou de perdre leur attention. Pour rester compétitives, les entreprises doivent agir avant même la fin de cette interaction. Une équipe des services financiers a besoin des dernières données de marché pour discuter avec ses clients des ajustements à apporter à leur portefeuille. Une équipe des opérations réseau doit savoir dès qu’un réseau commence à se dégrader afin d’aider les clients concernés pendant leur échange avec le support. Un retailer doit personnaliser l’expérience pendant que le client effectue encore ses achats et optimiser ses stocks en fonction de la demande en temps réel. Et un agent d’IA a besoin d’un contexte fiable, actuel et précis pour recommander la meilleure action à entreprendre, résoudre un problème ou éclairer une décision.
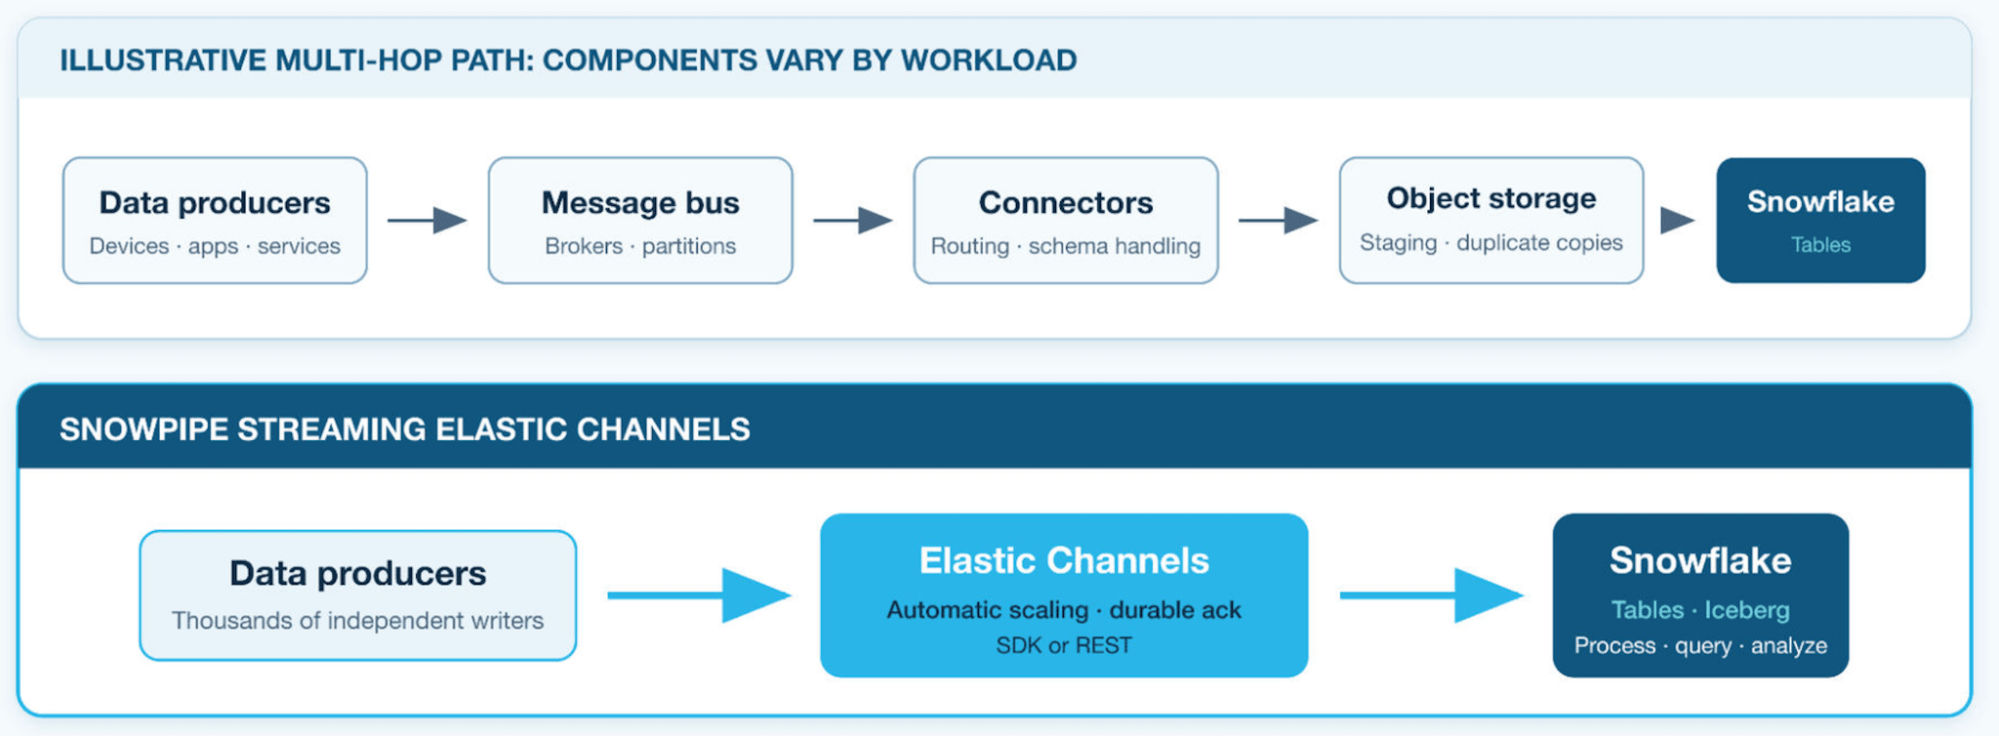
Dans chaque cas, la valeur des données dépend de la rapidité avec laquelle les équipes passent de l’observation à l’action. Lorsqu’une équipe détecte rapidement un problème, en comprend l’impact et agit sur-le-champ, elle augmente son chiffre d’affaires, améliore l’expérience client et prend de meilleures décisions. Cette urgence et cette rapidité d’accès aux informations peuvent différencier votre business de la concurrence. Pourtant, construire un stack en temps réel a souvent nécessité d’assembler manuellement des systèmes distincts pour l’ingestion, la transformation et la mise à disposition : connecter les producteurs à un broker de messages, déployer des tâches de transformation séparées et charger les résultats dans une nouvelle base de données. Chaque couche ajoute de l’infrastructure à exploiter, des spécialistes à recruter, des pipelines susceptibles de tomber en panne, des coûts à maîtriser et de nouvelles règles de sécurité à maintenir.
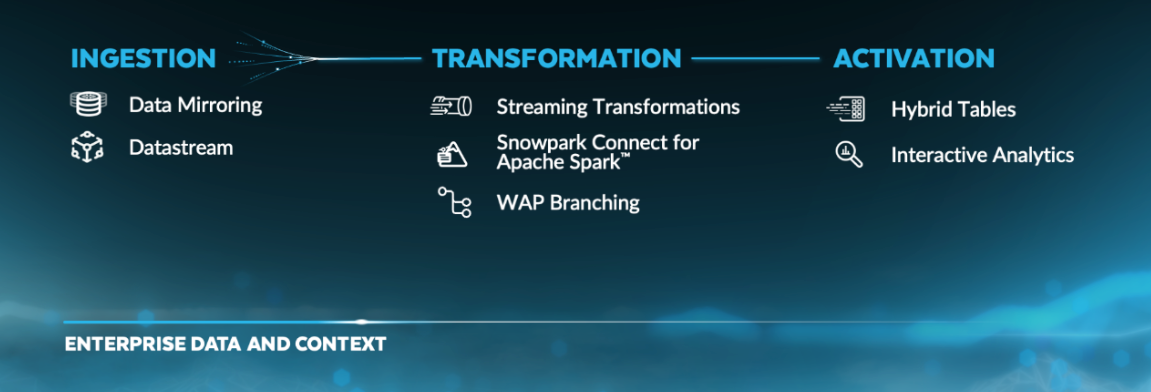
C’est pourquoi Snowflake lance une expérience connectée qui rend l’analytique en temps réel plus simple à créer, plus économique à faire évoluer et gouvernée à chaque étape. Elle réunit la connectivité, la transformation et la mise à disposition dans les tables natives Snowflake et les tables Apache Iceberg™, afin que les équipes transforment les données récentes en décisions sans gérer de stack fragmenté ni renoncer au libre choix de leurs moteurs et outils.
Découvrez Snowflake pour l’analytique en temps réel
L’analytique en temps réel permet de transformer des données actualisées en informations fiables et en actions concrètes en quelques secondes. L’analytique en temps réel traite et analyse les données à mesure que les événements se produisent. Elle offre aux utilisateurs et aux systèmes une vision actuelle de la situation, avec une latence adaptée à chaque charge de travail.
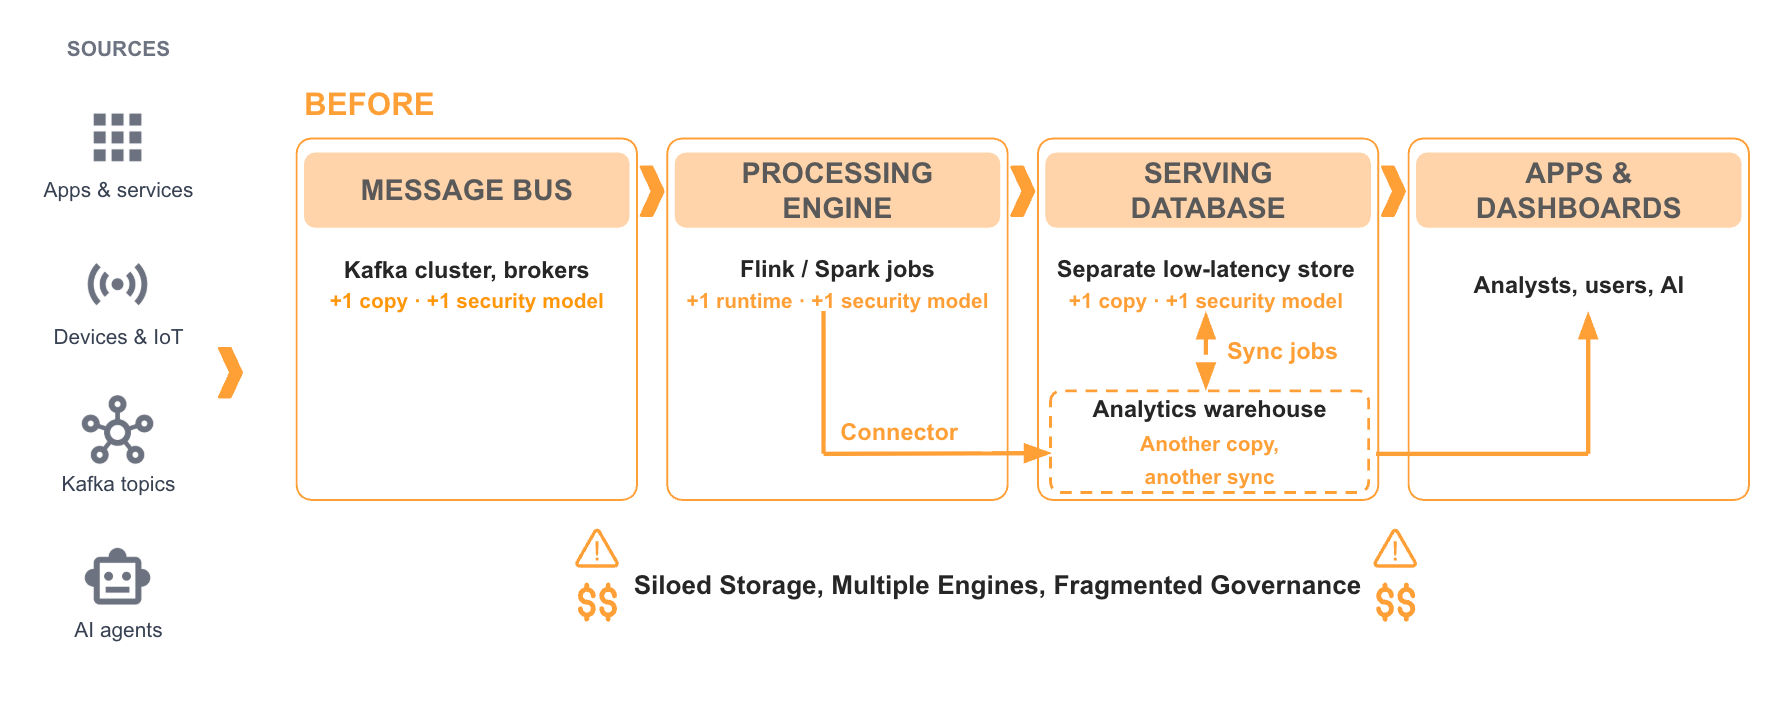
Snowflake réunit désormais la connectivité, la transformation et la mise à disposition pour assurer une analytique en temps réel de bout en bout. Cet article présente ces fonctionnalités : connecter les données, les transformer à la volée et les servir rapidement. Snowflake répond aux besoins suivants sans obliger les équipes à reconstruire leur architecture pour chacun d’eux.
- Simplicité pour faire évoluer vos projets : créer des pipelines en temps réel sans devoir maîtriser chacun des systèmes sous-jacents. Snowflake gère l’infrastructure, son évolution et le pipeline sur l’ensemble de la connectivité, de la transformation et de la mise à disposition. Les fonctionnalités de Snowflake CoCo transforment la configuration du pipeline en une conversation guidée. Décrivez votre besoin : CoCo configure, crée et implémente la logique.
- Des performances élevées pour un coût total réduit : obtenez des informations récentes sans financer un stack en temps réel entièrement distinct. Votre équipe peut se passer de bases de données de mise à disposition séparées et de stockage dupliqué, ainsi que des efforts d’ingénierie nécessaires pour les exploiter, les surveiller et les dépanner. Lors de nos tests internes, nous avons observé une latence de bout en bout P50 de trois secondes[1] avec Snowpipe Streaming, les transformations en streaming et Snowflake Interactive Analytics.
- Une gouvernance à chaque étape : découvrir et sécuriser les données et les ressources d’IA, puis créer avec elles dans un environnement intégré. Horizon Catalog centralise dans Snowflake les contrôles d’accès, la traçabilité, la qualité des données et le contexte stratégique. Créer un climat de confiance dans toute votre organisation grâce à la surveillance de la qualité des données et à la classification des données et des ressources d’IA.
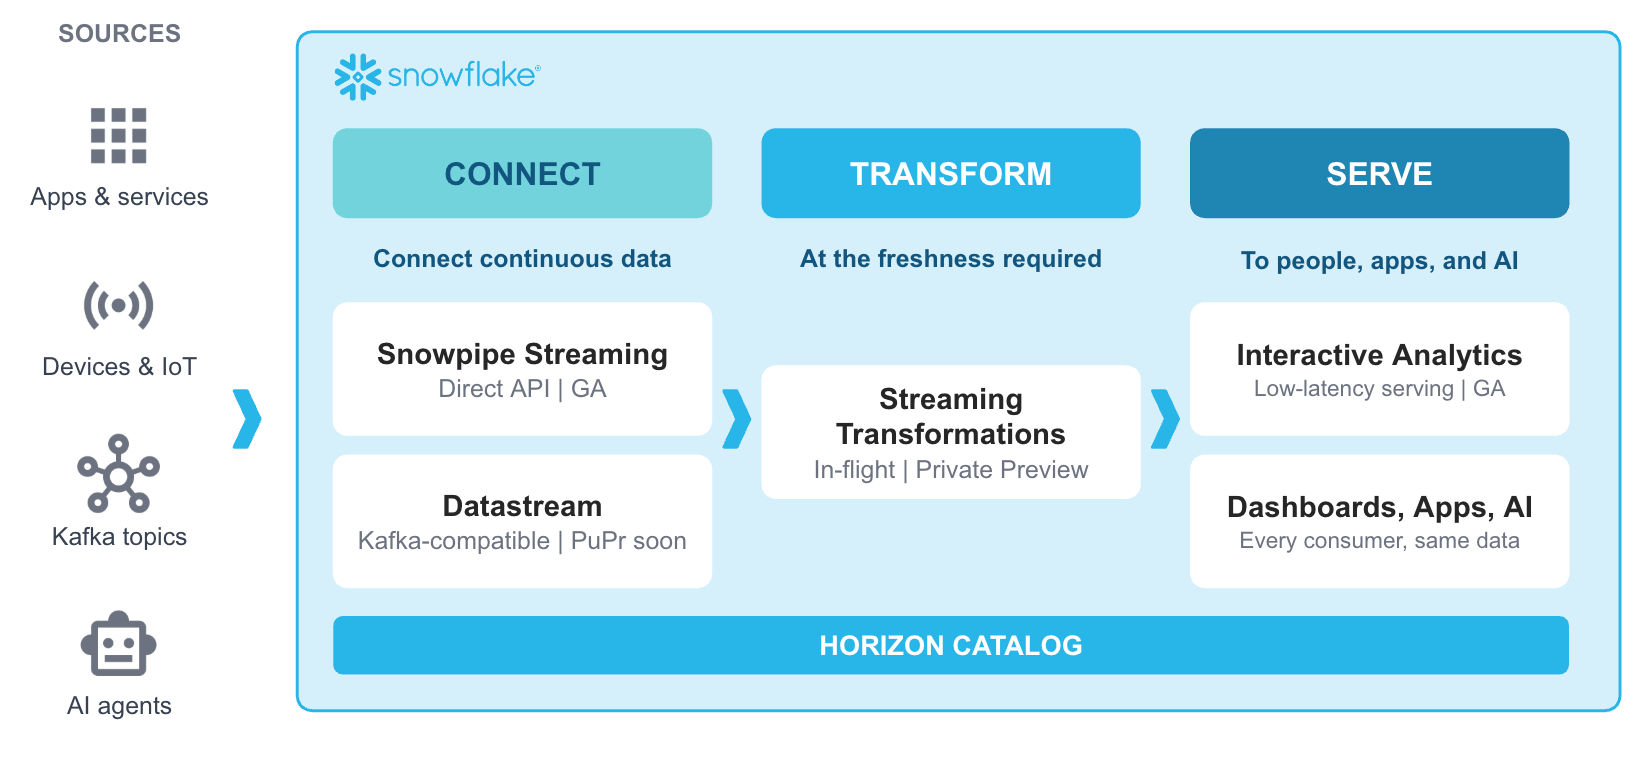
Connecter les données en temps réel sans ajouter d’infrastructure
L’analytique en temps réel commence par une ingestion rapide et simple des données. Snowpipe Streaming achemine les données des applications, appareils et services directement vers les tables natives Snowflake ou les Iceberg Tables. Les équipes peuvent choisir librement le format de table adapté à leur architecture. Les tables natives offrent une solution simple et entièrement gérée pour l’analytique opérationnelle et les applications. Les Iceberg Tables conservent les données dans un format ouvert accessible à d’autres outils. Les données sont interrogeables en quelques secondes, avec un débit de jusqu’à 20 Go/s par table et une tarification fixe basée sur l’ingestion.
L’ingestion est souvent le poste budgétaire qui détermine si un projet en temps réel verra le jour. Lorsque les coûts augmentent avec chaque nouvelle source, les équipes conservent moins de données actualisées qu’elles ne le souhaiteraient. À charge de travail comparable, Snowpipe Streaming est 5 fois moins cher[2] que Zerobus et 80 % moins cher que ClickPipes[3]. Vous payez un tarif fixe basé sur le volume de données ingéré, ce qui garantit des coûts prévisibles à mesure que vous ajoutez des sources.
Pour les équipes des services financiers, chaque seconde compte. Rendre les activités de trading, les historiques de transactions et les événements opérationnels disponibles pour analyse en quelques secondes permet aux équipes d’agir à partir d’informations à jour. Cboe Global Markets illustre l’ampleur de cette approche : l’entreprise utilise Snowpipe Streaming pour charger 190 milliards de lignes par jour en moins de 30 secondes, puis fournit directement ces données aux analystes via des entrepôts interactifs.
À mesure que le volume d’événements augmente, les équipes ne devraient pas consacrer davantage de temps à gérer les mécanismes d’ingestion. Avec les Elastic Channels de Snowpipe Streaming, disponibles pour tous nos clients, des centaines de producteurs, notamment des applications et des appareils Internet des objets (IoT), peuvent écrire vers une même destination par l’intermédiaire d’un canal élastique unique. Vous pouvez connecter davantage de sources sans créer ni gérer de canaux supplémentaires. Snowflake adapte automatiquement le chemin d’ingestion à l’augmentation des volumes. Les événements sont livrés dans l’ordre, une seule fois. Les équipes peuvent ainsi se consacrer à l’analyse plutôt qu’à l’écriture d’une logique de déduplication en aval. Lors de nos tests internes, nous avons encore augmenté le débit pour atteindre 41 Go/s dans une seule table.
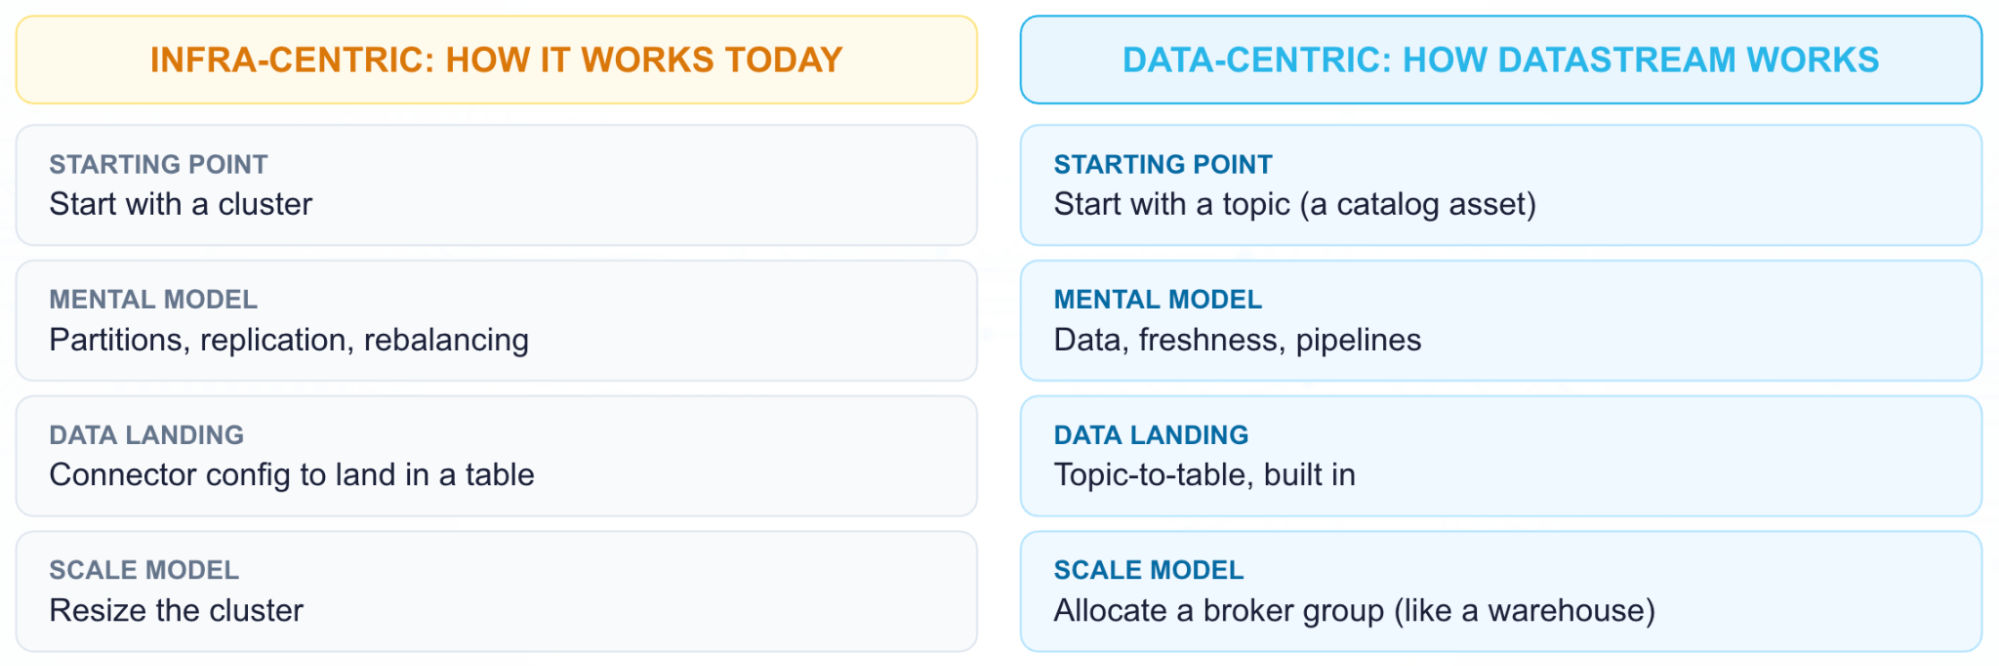
De nombreuses équipes utilisent déjà des producteurs et consommateurs Apache Kafka®, mais l’infrastructure de streaming est souvent conçue pour les ingénieurs infrastructure. Datastream, bientôt disponible en public preview et actuellement en private preview, adopte une approche centrée sur les données. Ce service natif Snowflake compatible avec Kafka permet aux équipes data d’utiliser leurs producteurs et consommateurs Kafka existants avec un endpoint géré, sans exploiter de brokers ni maintenir une couche de connecteurs distincte pour transférer les données vers les tables. Le streaming centré sur les données recentre les équipes sur les données gouvernées : elles gèrent les topics, la fraîcheur et les pipelines plutôt que les partitions, la réplication et la capacité du cluster. Des clients comme Minted et Zywave adoptent cette approche pour réduire la multiplication des systèmes d’authentification, des rôles et des outils de surveillance entre Kafka et Snowflake.
Transformer les données avec le niveau de fraîcheur dont votre business a besoin
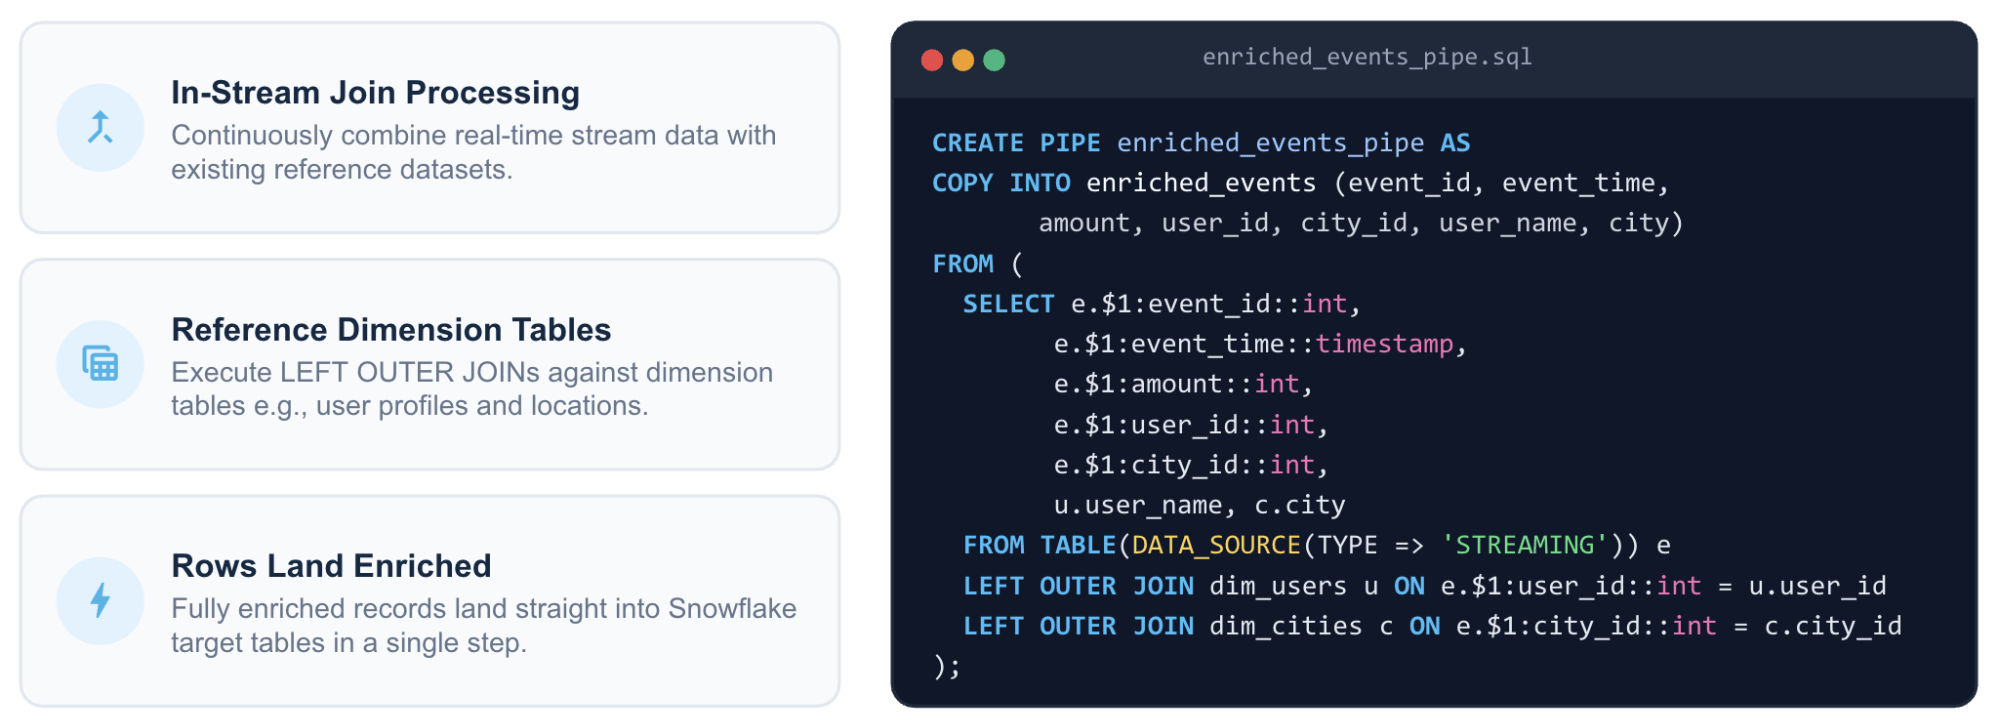
Les données récentes n’ont de valeur qu’une fois adaptées aux besoins du business. En filtrant, enrichissant, restructurant et agrégeant les données entrantes pendant leur ingestion avec Snowpipe Streaming, les transformations en streaming, en private preview, les rendent exploitables pour l’analytique en temps réel. Les équipes définissent la logique une seule fois dans une définition de pipe SQL, puis les enregistrements sont transformés avant d’être chargés dans une table.
Les équipes peuvent éliminer les événements non pertinents, enrichir les enregistrements entrants avec des données de référence, appliquer une logique personnalisée et développer des tableaux imbriqués en lignes individuelles. Intégrer la transformation au chemin d’ingestion simplifie le stack de streaming et accélère l’exploitation des données, comme le constatent déjà plusieurs clients Snowflake. Un fabricant d’équipements industriels standardise les identifiants de ses clients et de ses actifs afin que ses workflows analytiques reçoivent des enregistrements nommés de manière cohérente. Parallèlement, une entreprise de cybersécurité utilise les transformations en streaming pour traiter les événements de sécurité en temps réel et réduire les coûts de traitement ainsi que la latence de la surveillance et du reporting.
Pour les autres charges de travail prises en charge, les transformations en streaming peuvent supprimer le besoin d’une couche externe de traitement des flux, ainsi que celui de créer, planifier et maintenir des transformations en aval après le chargement des données. Résultat : moins d’infrastructure à exploiter et un parcours plus court entre les événements bruts et les informations exploitables. Les transformations en streaming prennent en charge les tables Snowflake standard et interactives, ainsi que les Iceberg Tables gérées par Snowflake. Les objectifs actuels de fraîcheur entre l’ingestion et la mise à disposition sont inférieurs à trois secondes pour les destinations interactives et à 10 secondes pour les destinations standard et Iceberg.
Fournir des réponses en moins d’une seconde à grande échelle avec Interactive Analytics
C’est souvent dans la dernière ligne droite que les projets en temps réel échouent. Les tableaux de bord, les applications destinées aux clients et les agents d’IA interrogent simultanément les mêmes données. Pour tenir la cadence, les équipes se tournent souvent vers une base de données de mise à disposition distincte. Interactive Analytics prend directement en charge ces charges de travail dans Snowflake.
Lors de tests internes, les entrepôts interactifs ont exécuté des requêtes en moins d’une seconde, avec une concurrence neuf fois supérieure et une latence trois fois inférieure à celles des entrepôts standard. Avec Zero-Copy Interactive, disponible pour tous nos clients, ils s’exécutent directement sur les tables standard, dynamiques et Iceberg Tables existantes. Aucune copie spécialisée n’est nécessaire pour servir les données avec une faible latence. Pour l’ingestion en streaming, nous prenons en charge jusqu’à 41 Go/s par table, et les données deviennent interrogeables en quelques secondes.
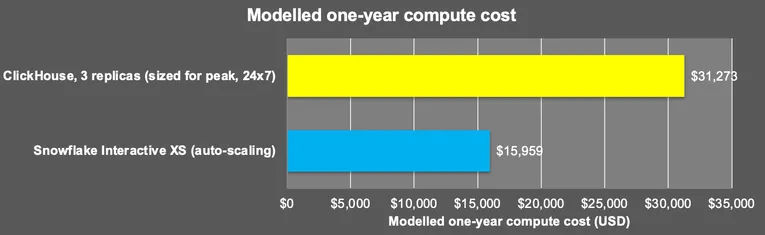
Dans deux benchmarks menés par McKnight Consulting Group, à coût de calcul horaire comparable, Snowflake a exécuté 100 % des requêtes à chaque niveau de concurrence testé, jusqu’à 32 utilisateurs simultanés. Sur les requêtes de tableaux de bord, Snowflake a également fourni un débit plus de cinq fois supérieur à celui d’une base de données d’analytique en temps réel leader, tandis que son concurrent a échoué sur 73 % des agrégations à forte cardinalité. Lors d’un troisième test simulant un pic soudain de trafic multiplié par cinq, Snowflake a automatiquement augmenté sa capacité et maintenu 99,997 % des requêtes dans les limites du SLA, avec une latence p99 inférieure de 40 % à celle du concurrent dimensionné pour les pics de charge. Pour égaler les résultats de Snowflake, le concurrent devrait exploiter en permanence une capacité dimensionnée pour les pics, pour un coût annuel presque deux fois supérieur, soit 31 273 USD contre 15 959 USD.
La mise à disposition s’effectue sur les mêmes données gouvernées que celles utilisées par votre business. Il n’y a donc aucune tâche de synchronisation à maintenir ni de deuxième copie à sécuriser. Les équipes stockent les données une seule fois et les servent à partir de cette copie. Les coûts restent ainsi prévisibles à mesure que le volume et la concurrence augmentent.
Par exemple, plutôt que de déployer une plateforme distincte de détection des menaces, Canva a rapproché la détection de ses données. Interactive Analytics exécute chaque minute des milliers de requêtes de détection sur les journaux d’audit en direct et les données de référence fiables que Canva conserve déjà dans Snowflake, sans deuxième copie à maintenir. Lors d’une évaluation représentative d’un environnement de production, l’entrepôt interactif a pris en charge plus de dix fois la charge simultanée d’un entrepôt standard équivalent, pour un coût modélisé nettement inférieur.

Nous ne voulions pas créer une plateforme supplémentaire ni constituer une équipe pour l’exploiter. Nos données les plus fiables sur notre produit et notre communauté se trouvaient déjà dans Snowflake. Nous avons donc rapproché la détection des données, ce qui a amélioré la fiabilité de nos alertes. »
Calvin Wang
Staff Analytics Engineer, Security Group, Canva
Commencez dès aujourd’hui
Les entreprises ont besoin d’un moyen plus simple de transformer les données récentes en décisions. Snowflake fournit un environnement connecté pour l’analytique en temps réel : simple à exploiter, rapide pour servir les données, économique à faire évoluer, ouvert aux tables natives comme aux Iceberg Tables et gouverné du premier événement à la décision finale. Et Snowflake CoCo facilite la création à chaque étape. Décrivez simplement votre besoin en langage naturel : CoCo peut vous aider à configurer la connectivité, à créer les transformations et à paramétrer Interactive Analytics.
Découvrez comment tous ces éléments s’articulent dans notre webinaire à la demande « Données en temps réel : les fondations de l’IA agentique », dans lequel nous présentons les bonnes pratiques et une architecture de référence pour créer une analytique en temps réel au service des tableaux de bord, des applications et des agents d’IA.
- La latence médiane (P50) de mise à disposition des données, soit 3 secondes, a été mesurée lors de tests internes menés par Snowflake le 20 octobre 2026. Ces tests couvraient l’ensemble du parcours dans Snowpipe Streaming, les transformations en streaming et Interactive Analytics. ↩
- Comparaison des coûts basée sur Snowpipe Streaming à 0,0037 crédit/Go × 2,35 USD/crédit, soit le prix moyen d’un crédit Snowflake, pour un total d’environ 0,0087 USD/Go. Comparé au prix catalogue de Databricks Zerobus, soit 0,05 USD/Go, ce tarif est environ 5,75 fois inférieur, chiffre arrondi à environ 5 fois en moyenne.
- Comparé au tarif publié de ClickPipes pour l’ingestion en streaming, soit 0,04 USD/Go, ce coût est inférieur d’environ 78 %, chiffre arrondi à 80 %. ClickPipes facture également le calcul séparément. Ces frais sont exclus de la comparaison.