30. Juni 2026/Lesezeit: 9 MinutenKI und ML
Cortex Sense: Fundierter Kontext für Daten, die Sie nie modelliert haben
Viele von uns sind mit einer Reihe von Lexika im Regal aufgewachsen, die als Autorität für fast alle Fragen galten. Doch ihr Inhalt veraltete oft schnell. So stießen wir beispielsweise noch Jahre, nachdem Pluto der Planetenstatus aberkannt worden war, auf Fakten, die ihn als neunten Planeten aufführten, und ein Großteil dessen, wonach wir suchten, war gar nicht erst enthalten. Als wir älter wurden, wurde Wikipedia zum neuen Lexikon und funktionierte genau umgekehrt. Obwohl einige unserer Lehrer uns anfangs sagten, wir sollten ihr nicht trauen, deckte sie schließlich fast alles ab und blieb aktuell.
Unternehmensdaten haben diesen Übergang nie vollzogen; wir versuchen immer noch, sie so zu dokumentieren wie Lexika, wobei eine Handvoll Expert:innen aufschreibt, was alles bedeutet, ohne jemals ganz fertig zu werden und allmählich ins Hintertreffen zu geraten, während sich das Unternehmen verändert.
Unser eigenes Produktdatenteam bei Snowflake hat sich zum Ziel gesetzt, unsere Tabellen für Agenten lesbar zu machen, indem es semantische Ansichten hinzufügt, sodass die Agenten aus kuratierten, verwalteten Definitionen lesen, anstatt zu raten. Auf der Produktseite haben wir Semantic View Autopilot eingeführt, um diese schneller zu generieren. Das hat sicherlich geholfen, aber selbst damit hatten wir nur die Spitze des Eisbergs abgedeckt – weniger als 5 % unserer 9.685 Tabellen. Alles, was in diese 5 % fiel, erhielt eine gute Antwort, aber das meiste, was die Leute tatsächlich fragten, fiel außerhalb, auf Tabellen, die niemand dokumentiert hatte, oder auf Daten, die zu neu waren, als dass eine semantische Ansicht existieren könnte.
Angenommen, Ihr Unternehmen hat vor zwei Wochen ein nutzungsbasiertes Preismodell eingeführt. Die dahinterliegenden Tabellen sind erst wenige Tage alt. Wenn ein PM einem Agenten eine direkte Frage stellt – „Wie läuft das neue Modell seit der Einführung?“ –, wird ein Cortex-Agent, der sich nur auf semantische Ansichten verlässt, die Antwort verweigern. Und andere Agenten, auf die sich Ihr Team möglicherweise bereits verlässt, sei es Snowflake CoCo, Cursor oder ChatGPT, fragen diese neuen Daten möglicherweise direkt ab, unabhängig davon, ob eine semantische Ansicht dafür existiert – was zu selbstbewussten, aber falschen Antworten führen könnte.
Cortex Sense (bald in der Private Preview) ist so konzipiert, dass es neben semantischen Ansichten funktioniert, nicht anstelle von ihnen. Wo Sie verwaltete, konsistente Antworten benötigen, bleibt die semantische Ansicht der Goldstandard, und Cortex Sense wird sie als maßgebliches Signal behandeln. Für den Rest Ihres Datenbestands wird es dieses Verständnis selbst aufbauen.
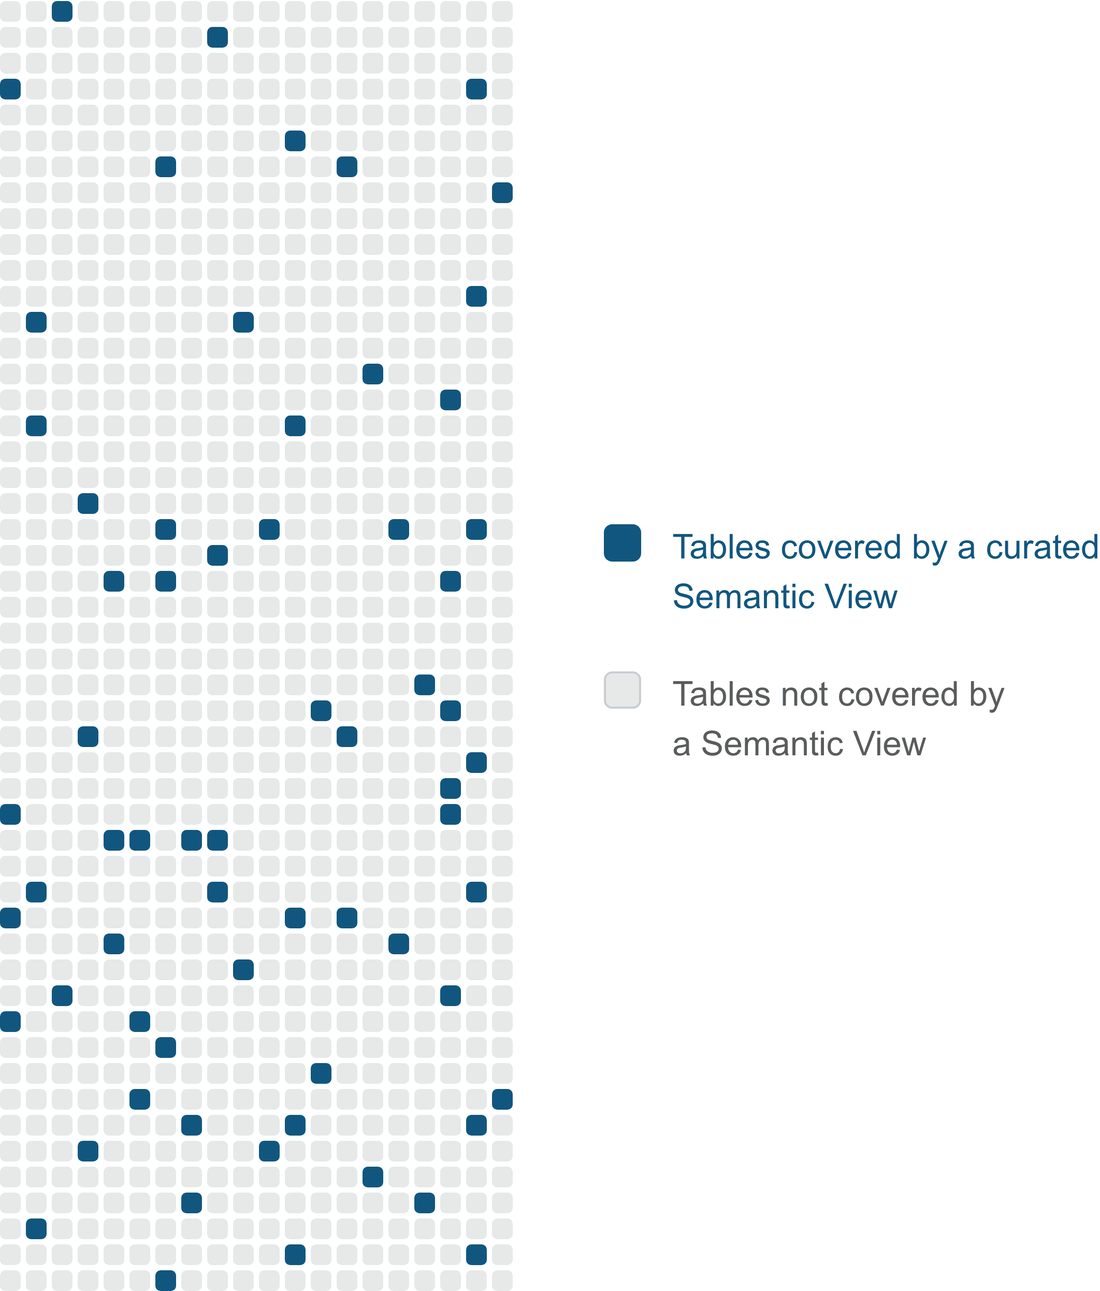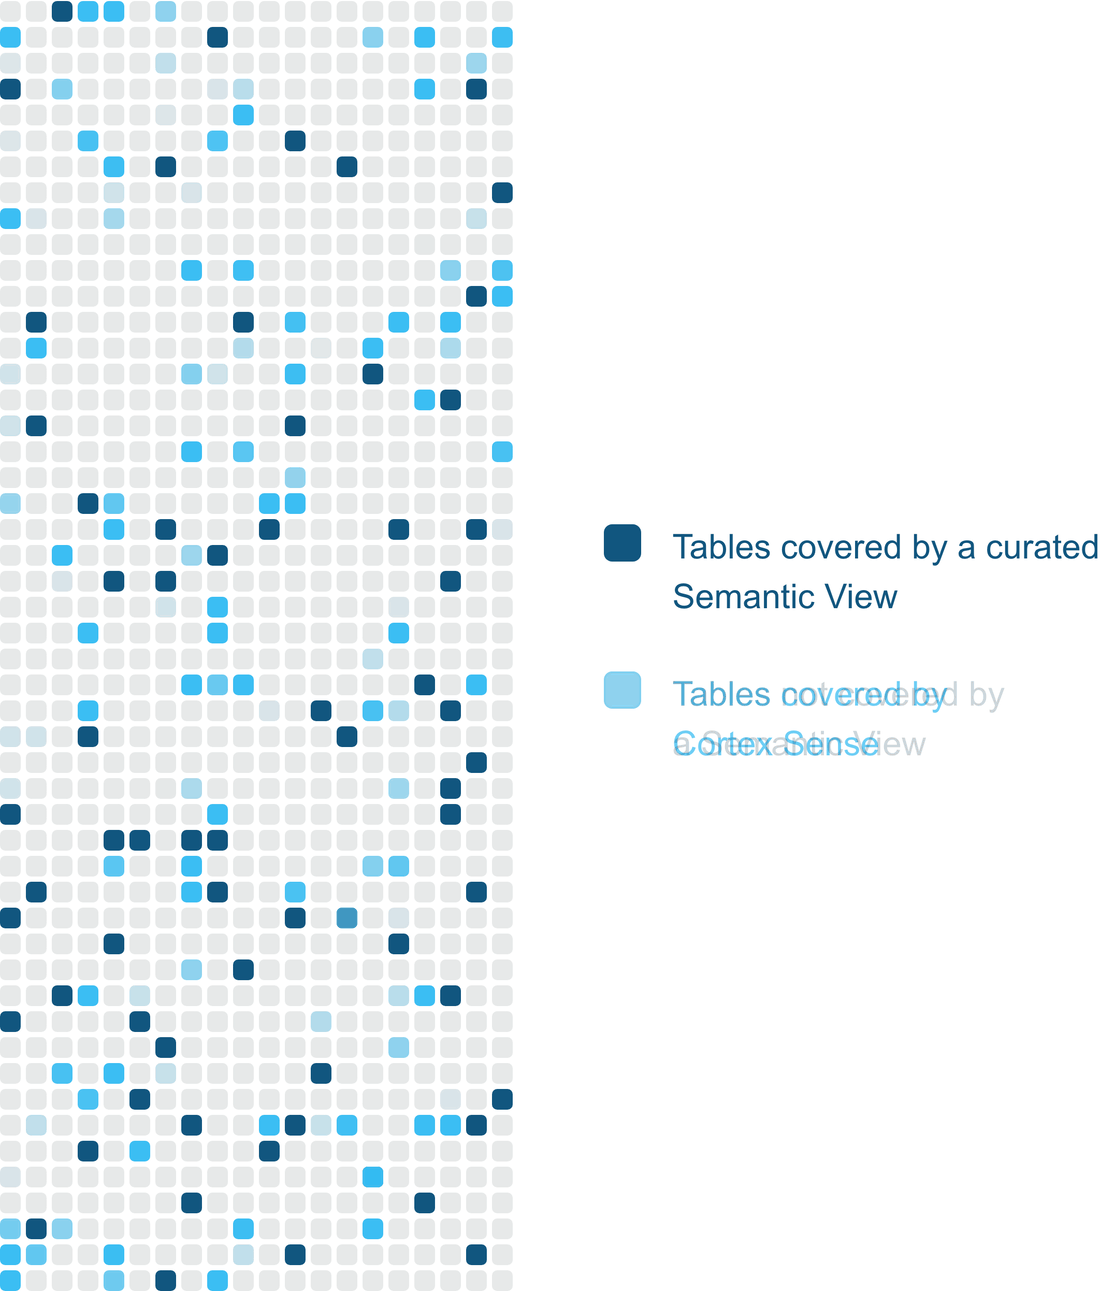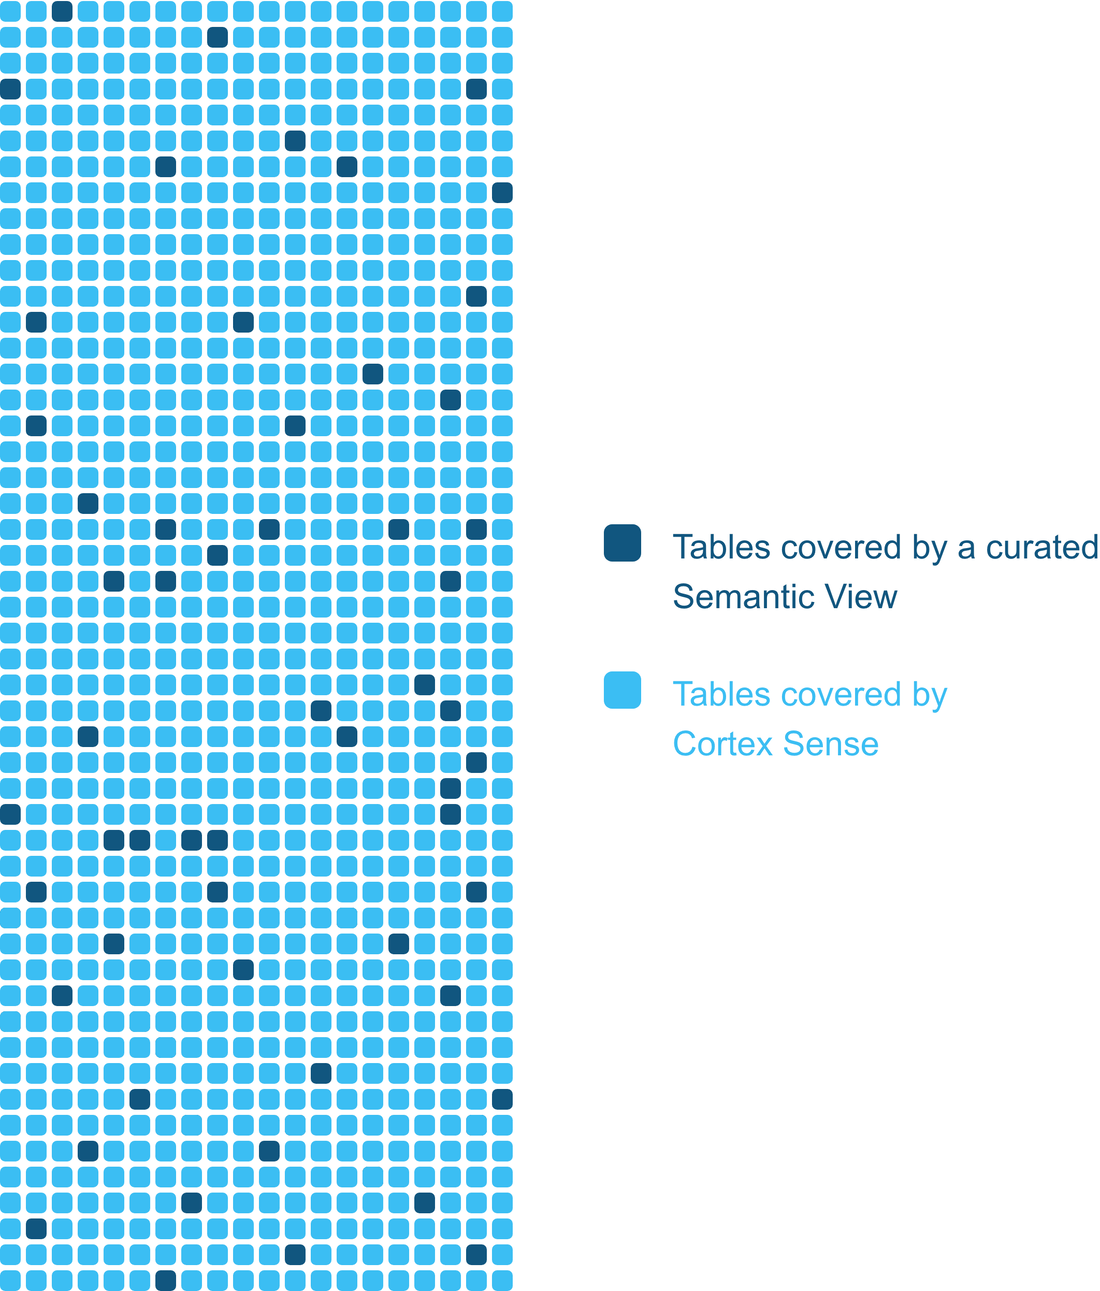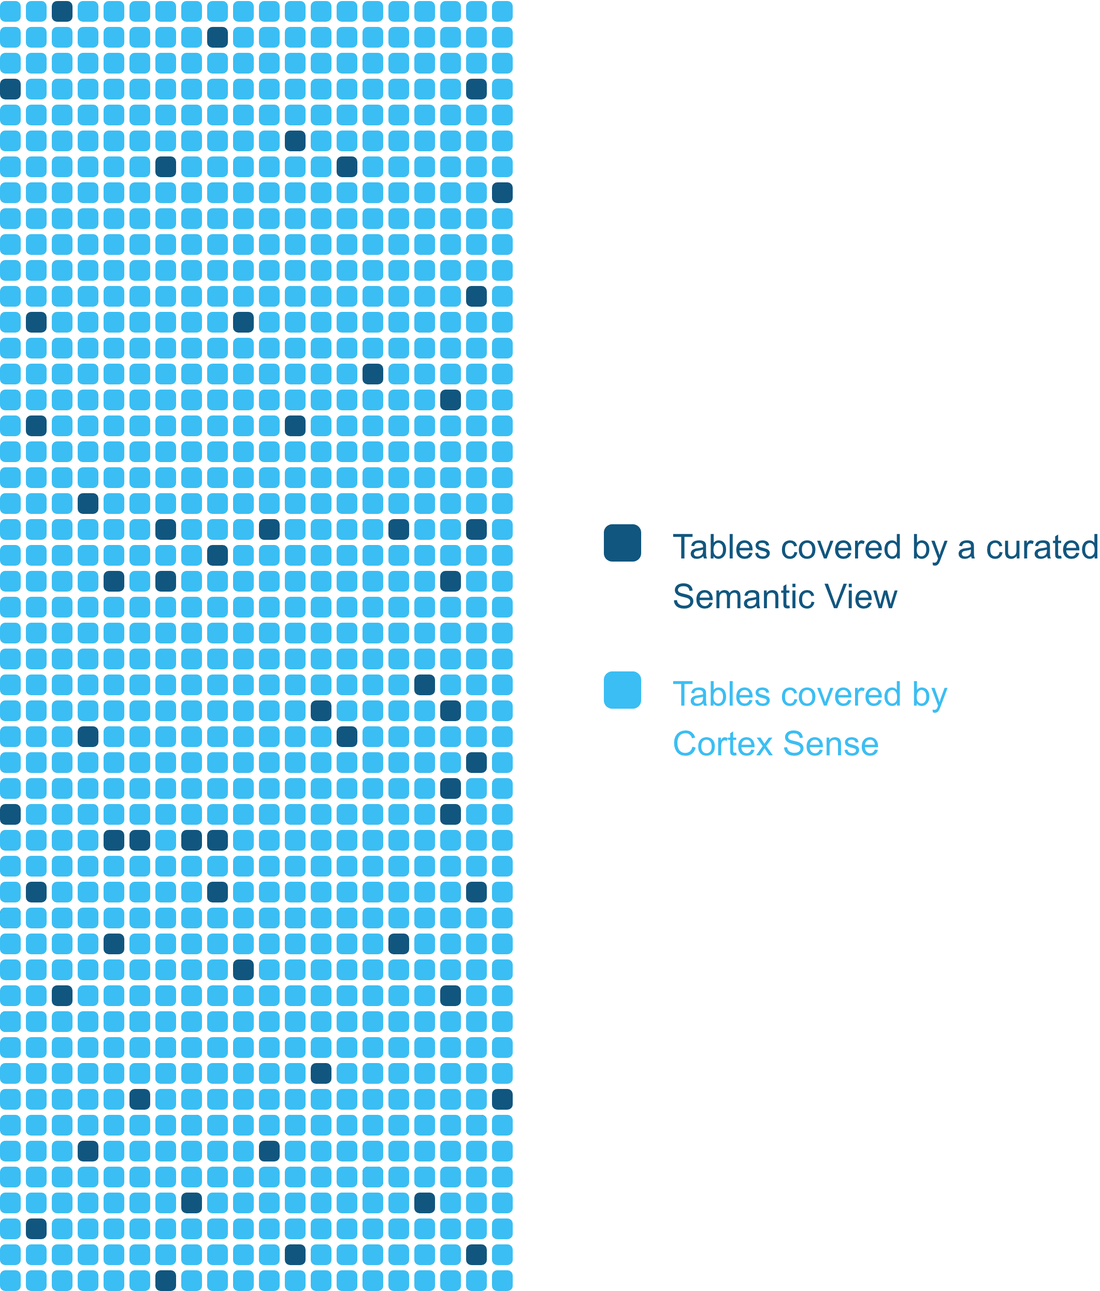
Es wird die gleiche Art von Verständnis aufbauen wie eine semantische Ansicht und noch weiter gehen, indem es ein funktionierendes Modell Ihres gesamten Unternehmens erstellt, nicht nur einen Katalog Ihrer Tabellen. Es wird dies automatisch aus den Signalen tun, die Ihr Unternehmen bereits produziert, wie z. B. den Abfragen, die Ihre Analyst:innen in der Vergangenheit ausgeführt haben, den in Ihren Transformationstools definierten Modellen und den Metriken, die bereits in Ihrer BI vorhanden sind. Ein Großteil dieses Kontexts wird über Snowflake Horizon Connectors einfließen.
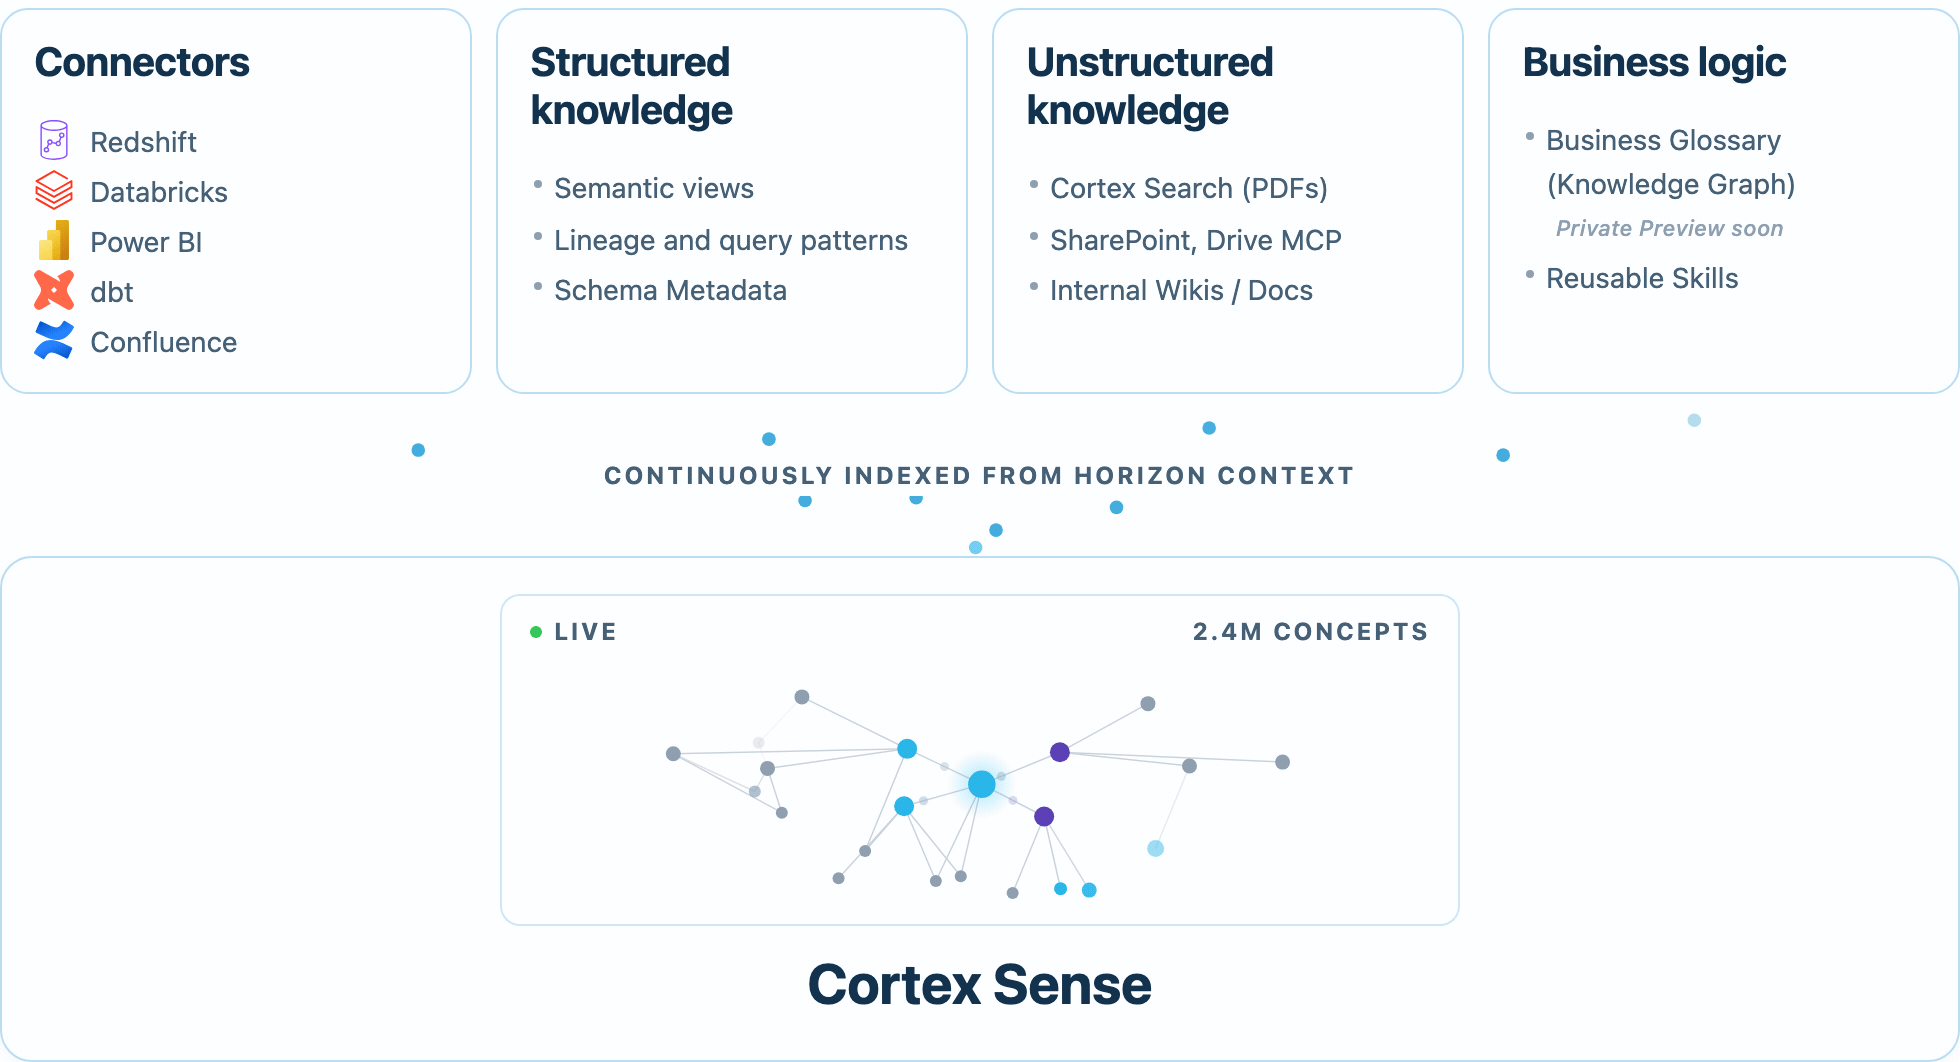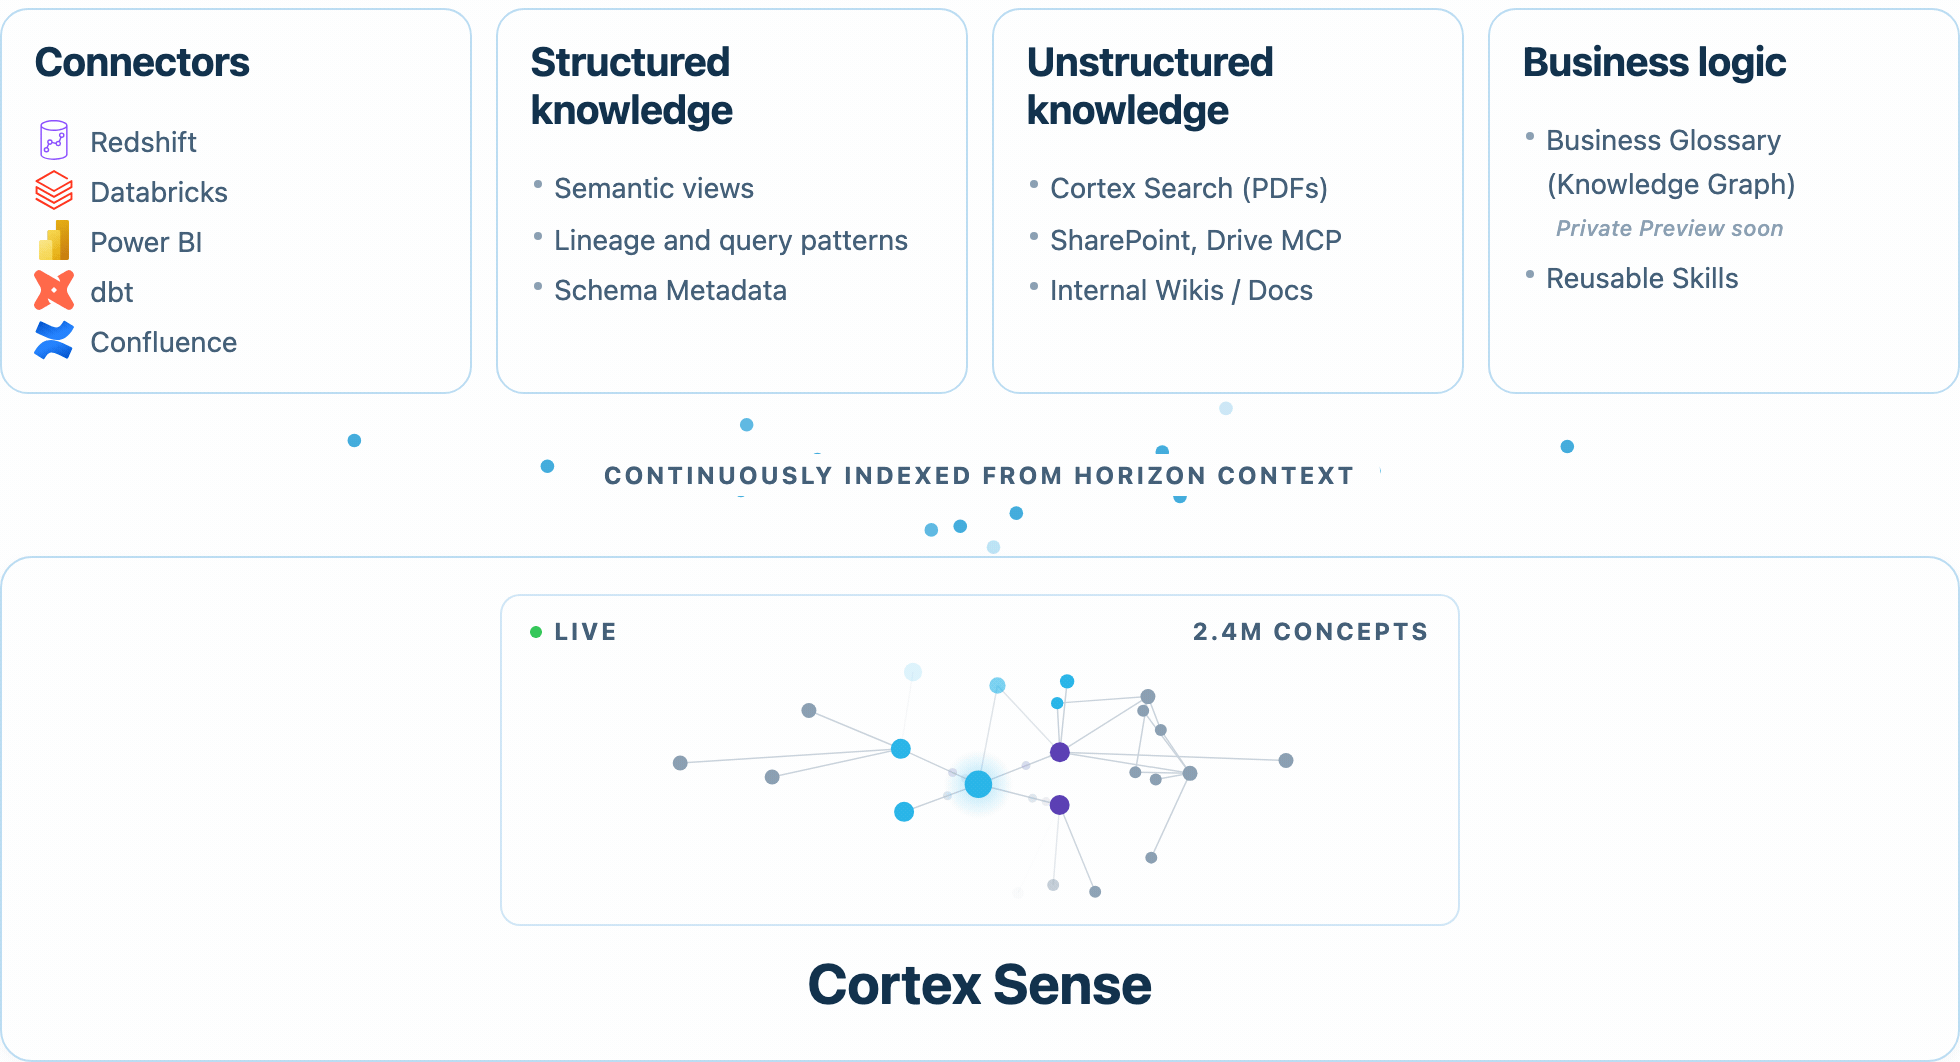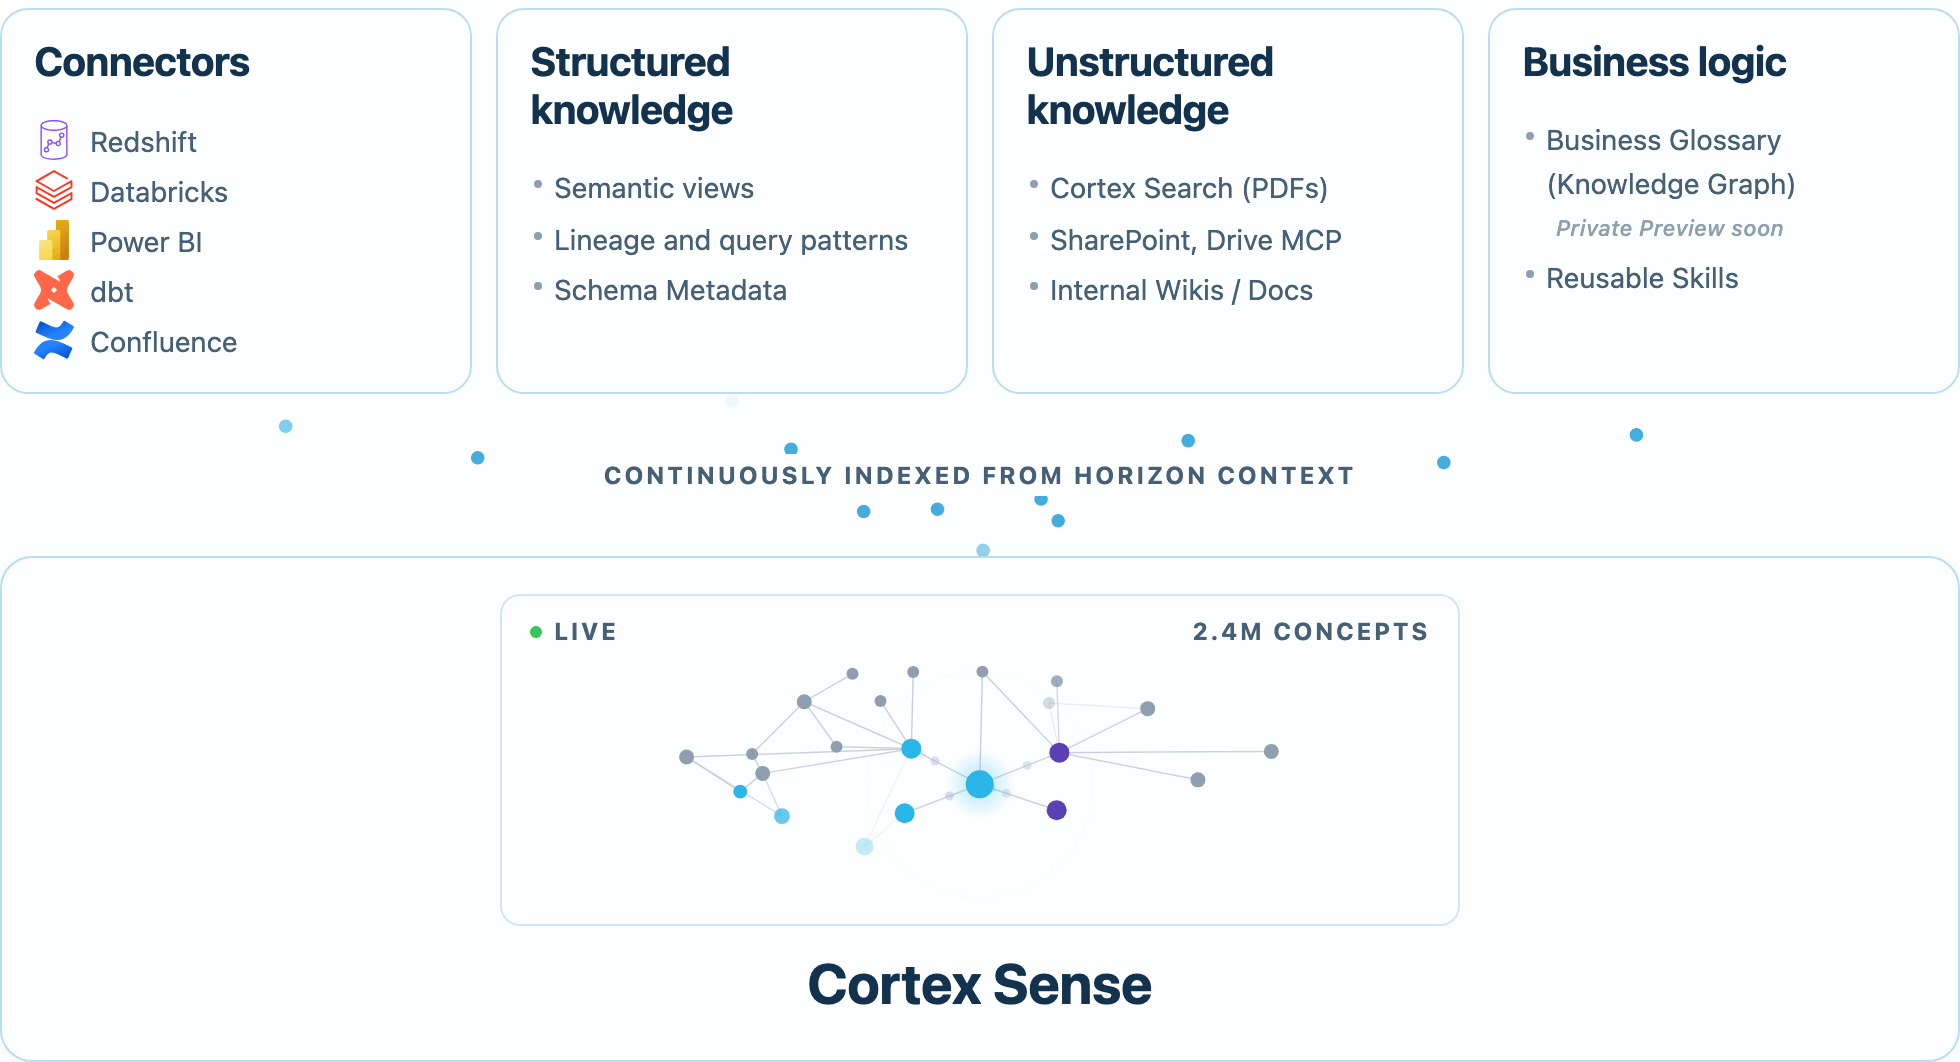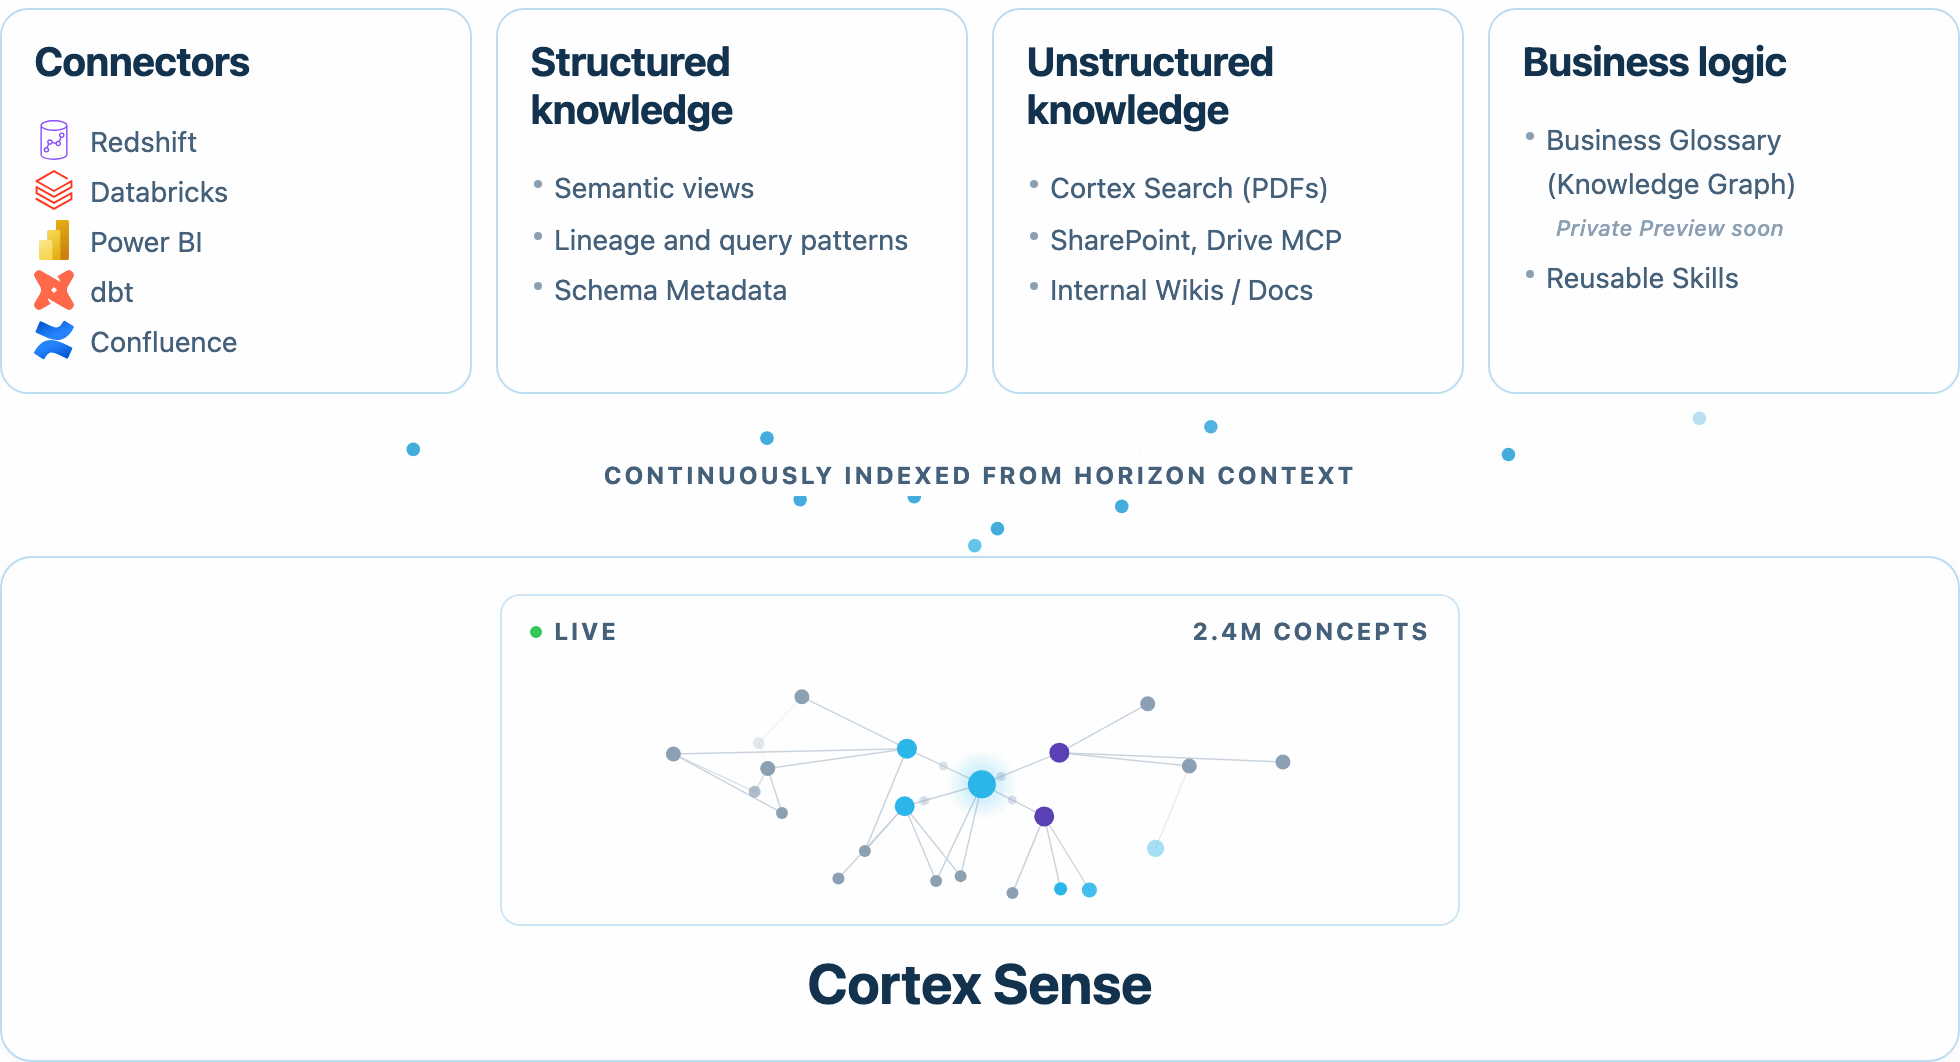
Anstatt eines zweiten Systems of Record, das Sie pflegen müssen, wird Cortex Sense eine verwaltete Lösung sein, die die Genauigkeitsuntergrenze für Agenten-Abfragen anhebt.
Um eine Baseline festzulegen, haben wir Agenten anhand von Produkt-Analytics-Fragen zu internen Daten von Snowflake evaluiert, die tabellenübergreifende Joins, das Nachschlagen von Metrikformeln und Kenntnisse über Filterkonventionen erforderten. Unser Datenteam stellte fest, dass die KI ohne jegliche Kontextschicht eine Genauigkeit von etwa 25 % aufwies, was dem Ergebnis von Anthropic bemerkenswert ähnlich war, das unabhängig davon nur 21 % gemessen hatte.
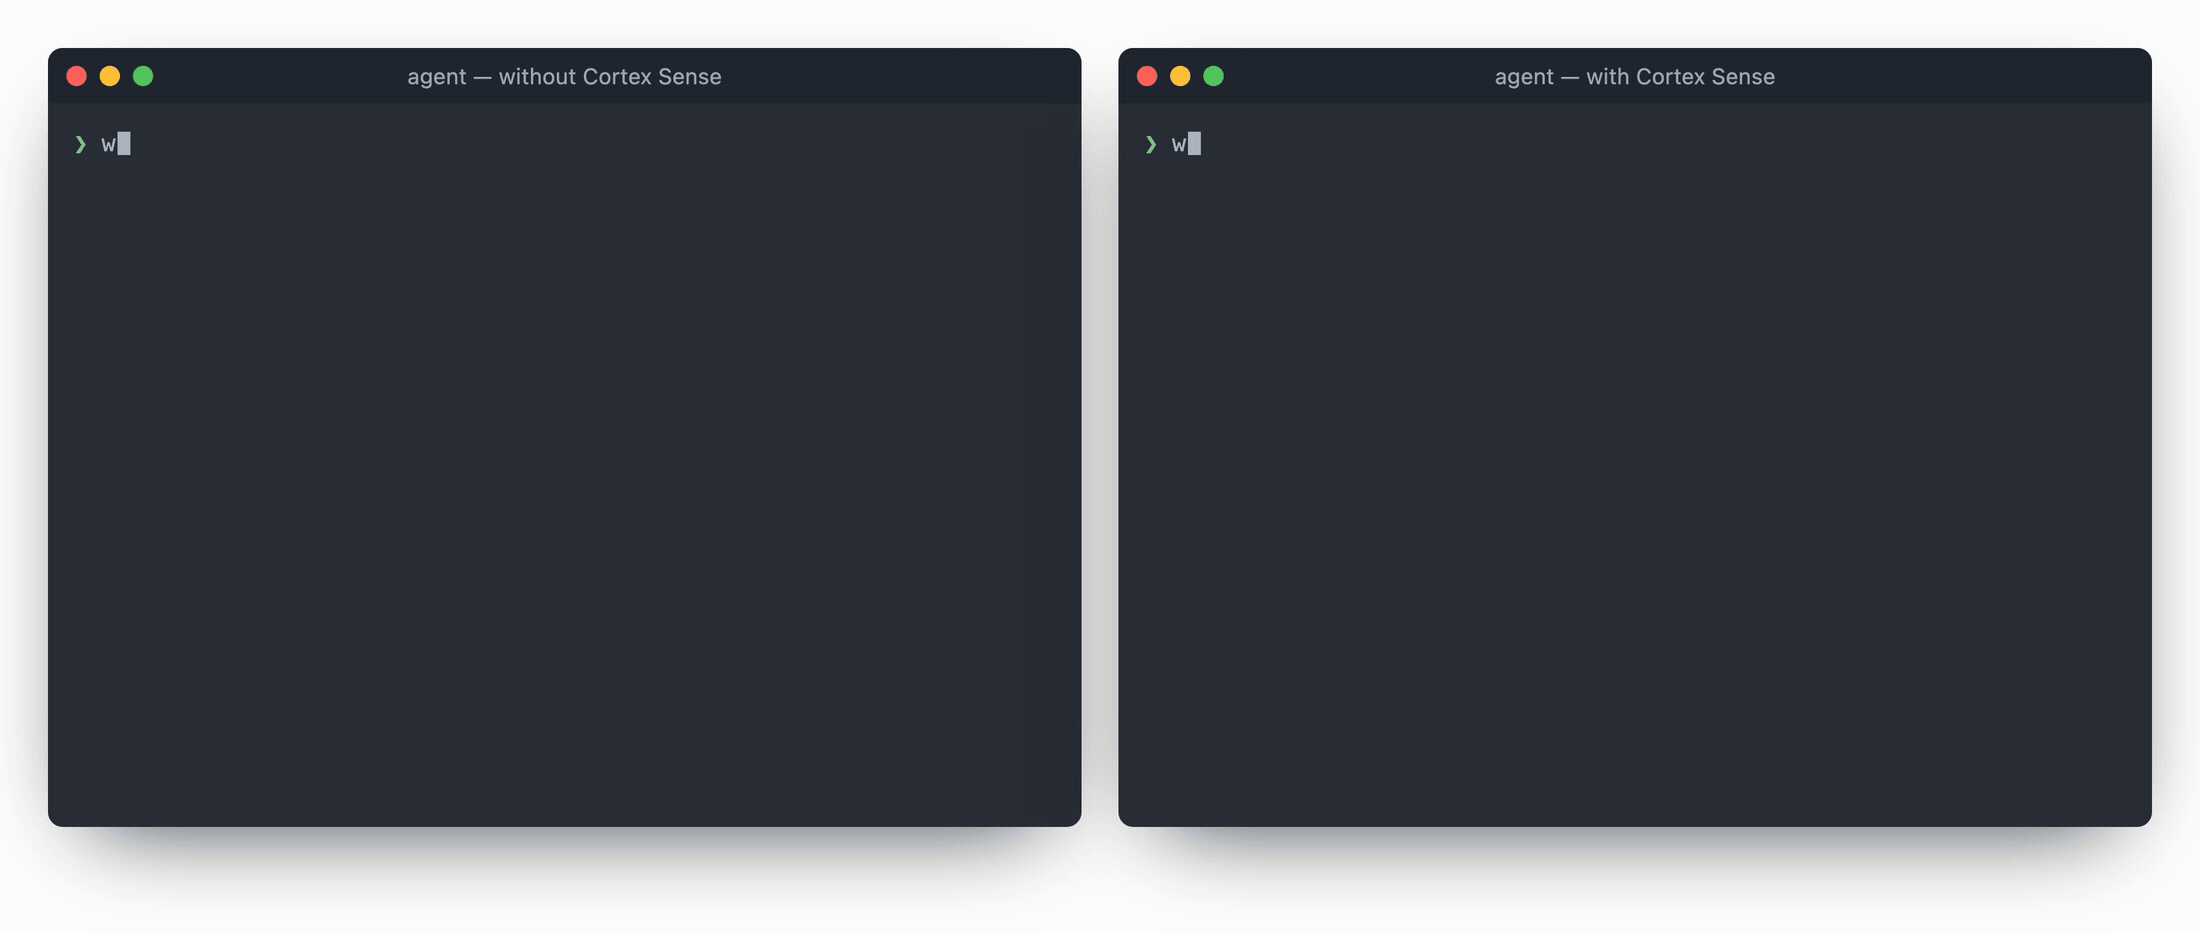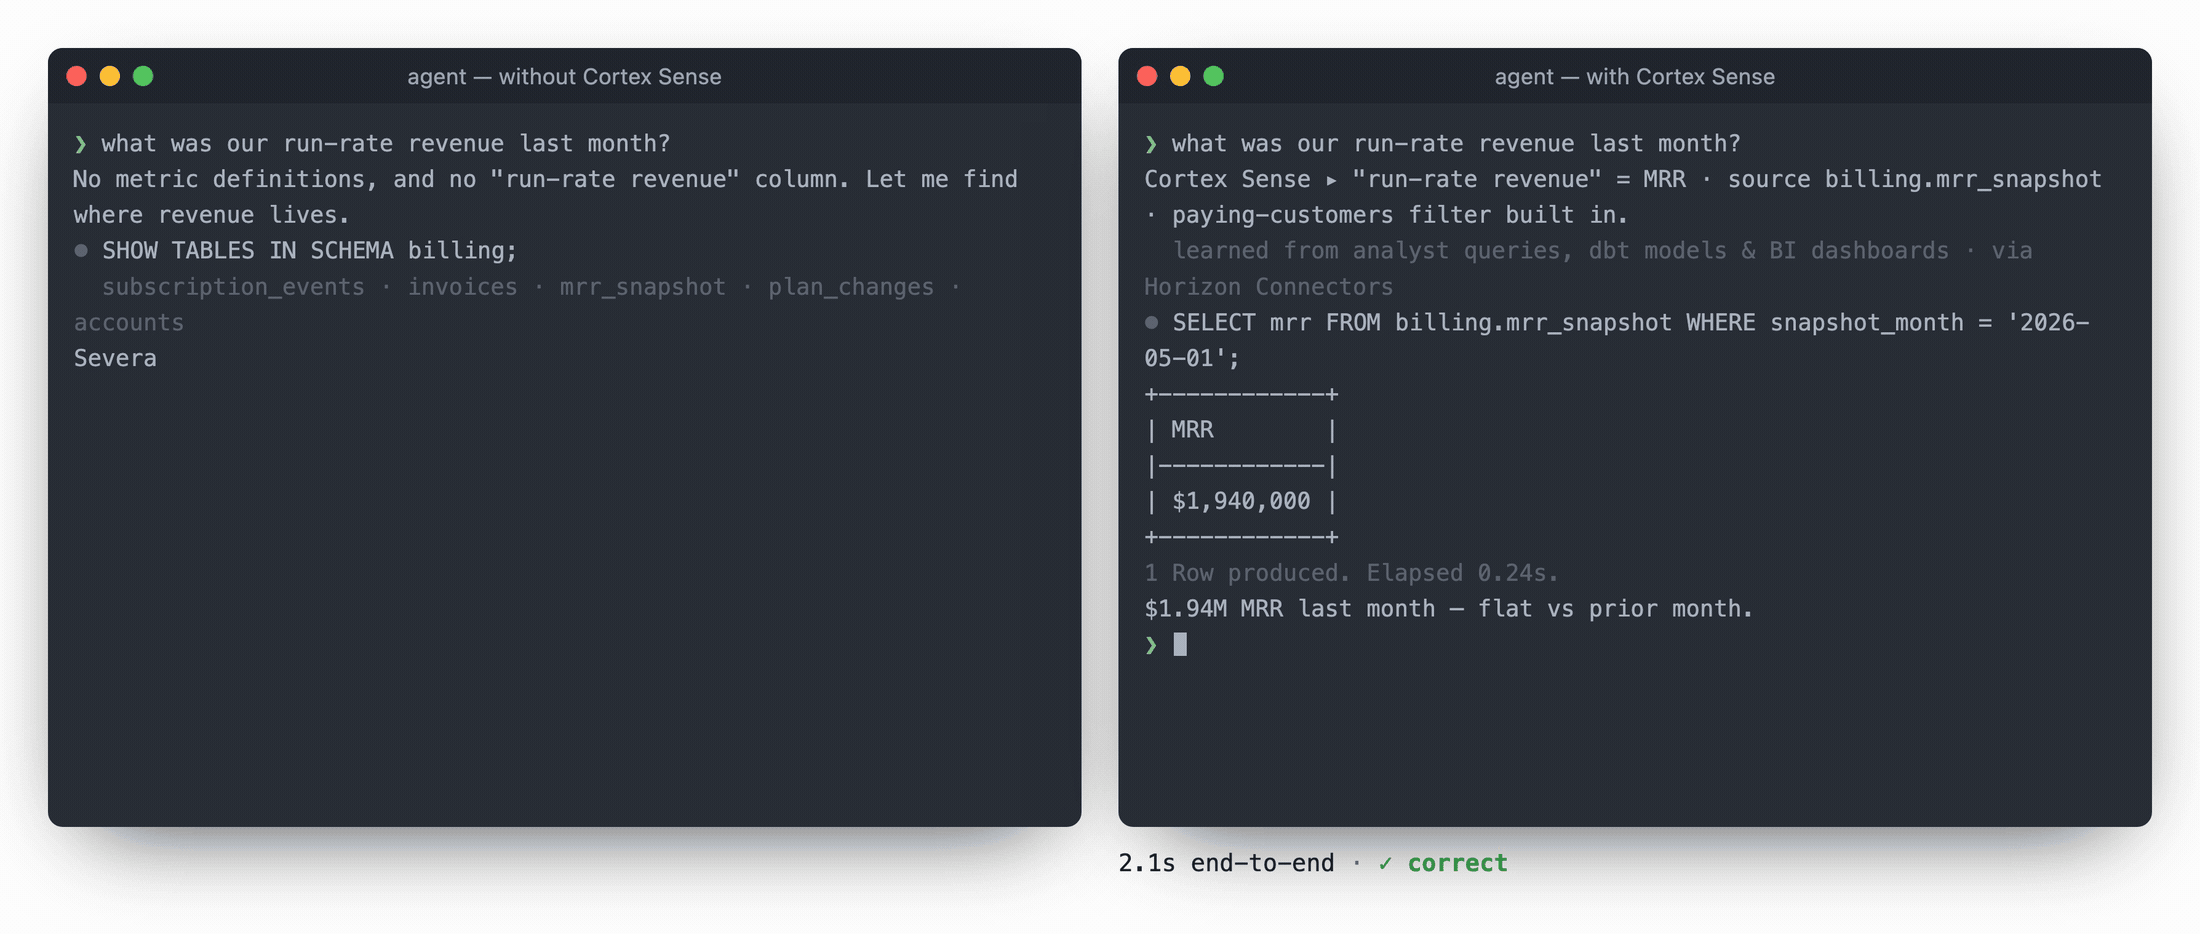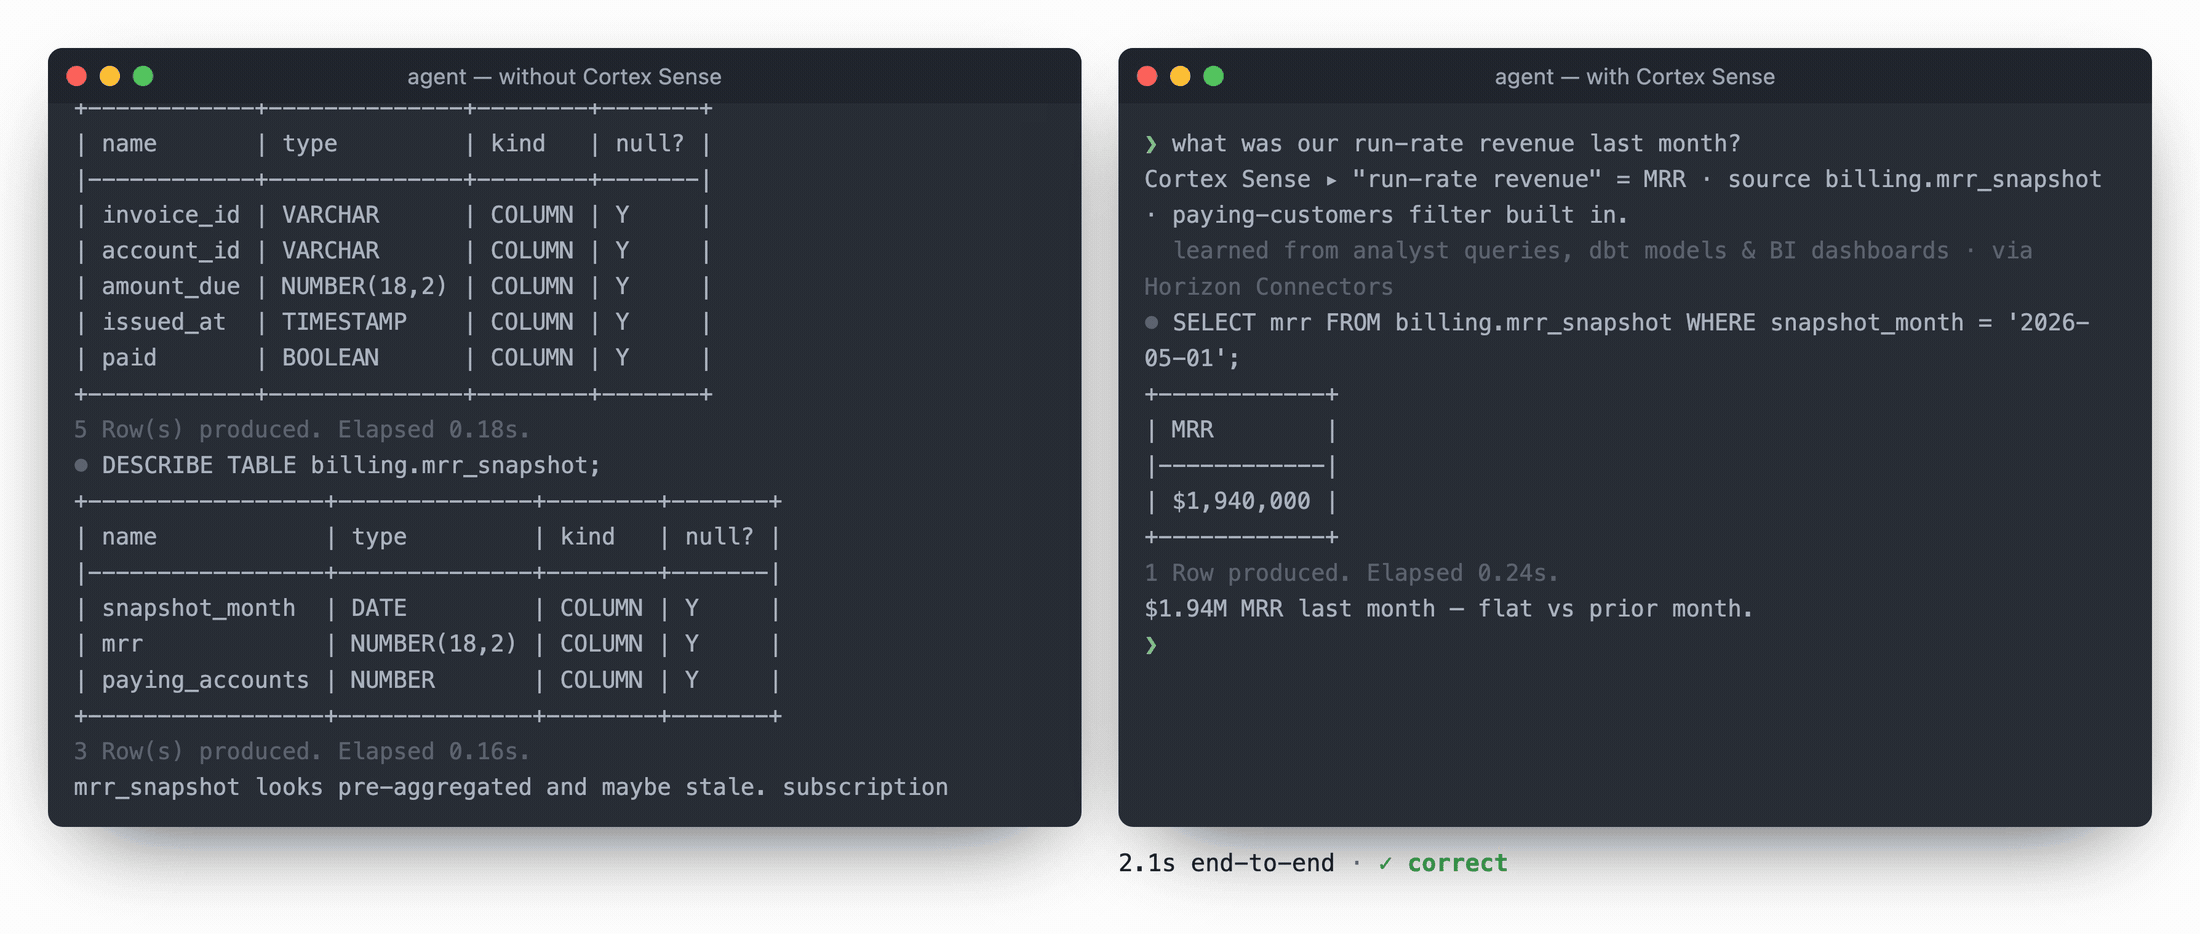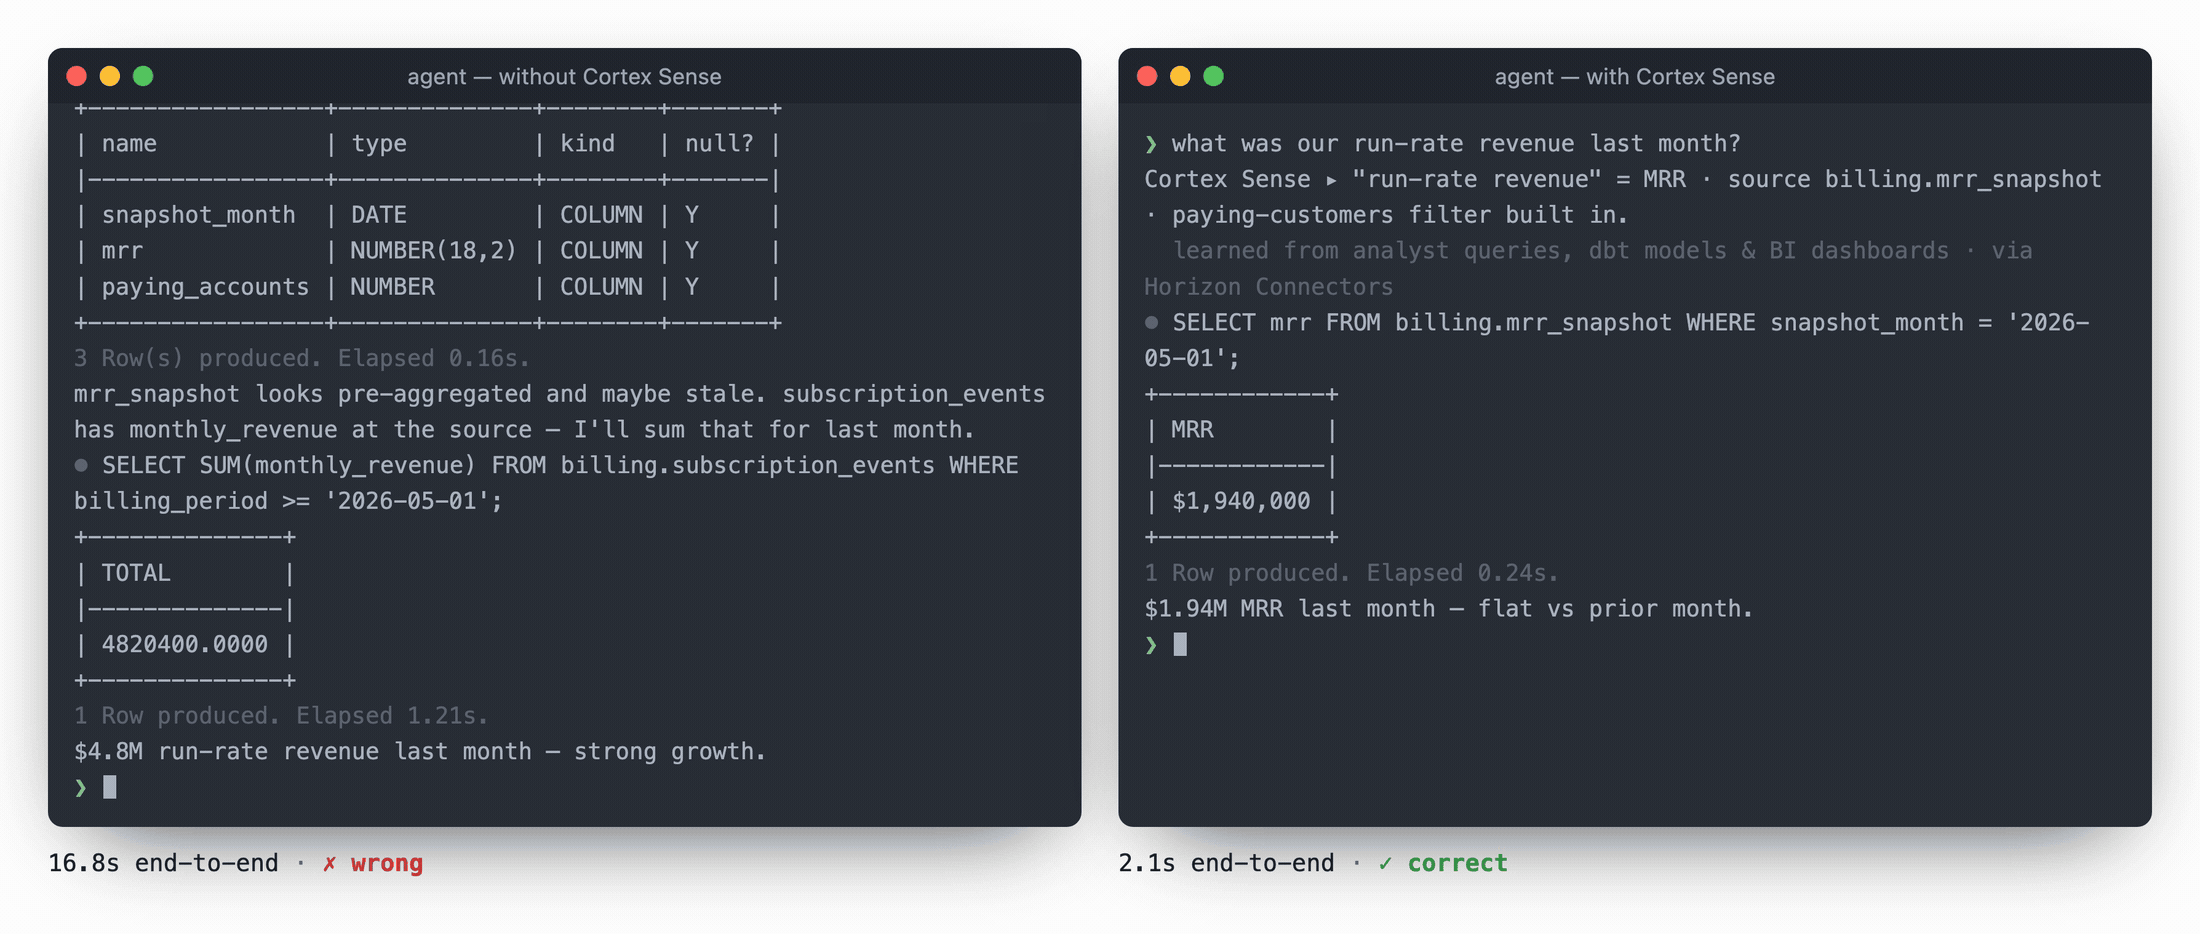
Ohne Cortex Sense untersucht CoCo jede Tabelle und jedes Schema separat und versucht zu lernen, was sie tun. Mit Cortex Sense weiß es genau, wo es suchen und was es abfragen muss.
Die Tatsache, dass es automatisch extrahiert und nicht von Hand geschrieben wird, wirft eine berechtigte Sorge auf, nämlich dass es selbstbewusst falsch sein könnte, ohne dass es jemand merkt. Cortex Sense wird dies abmildern, indem es eine selbstkorrigierende Schleife ausführt, die ständig Lücken und Konflikte in seinem eigenen Wissen identifiziert. Sie aktivieren Cortex Sense über CoCo, und es erstellt eine anfängliche Baseline aus Ihren verbundenen Quellen. Von dort aus wird es sich durch gezielte Evaluierung verbessern. Sie füttern es mit Fragen mit bekannten guten Antworten, und es wird jede Abweichung nutzen, um sein eigenes Verständnis zu korrigieren. Diese Evaluierungseingaben stammen aus drei Quellen: Ihren eigenen Goldstandard-Benchmarks, Benutzerfeedback und den eigenen Vorschlägen des Systems für Bereiche, in denen seine Abdeckung gering ist.
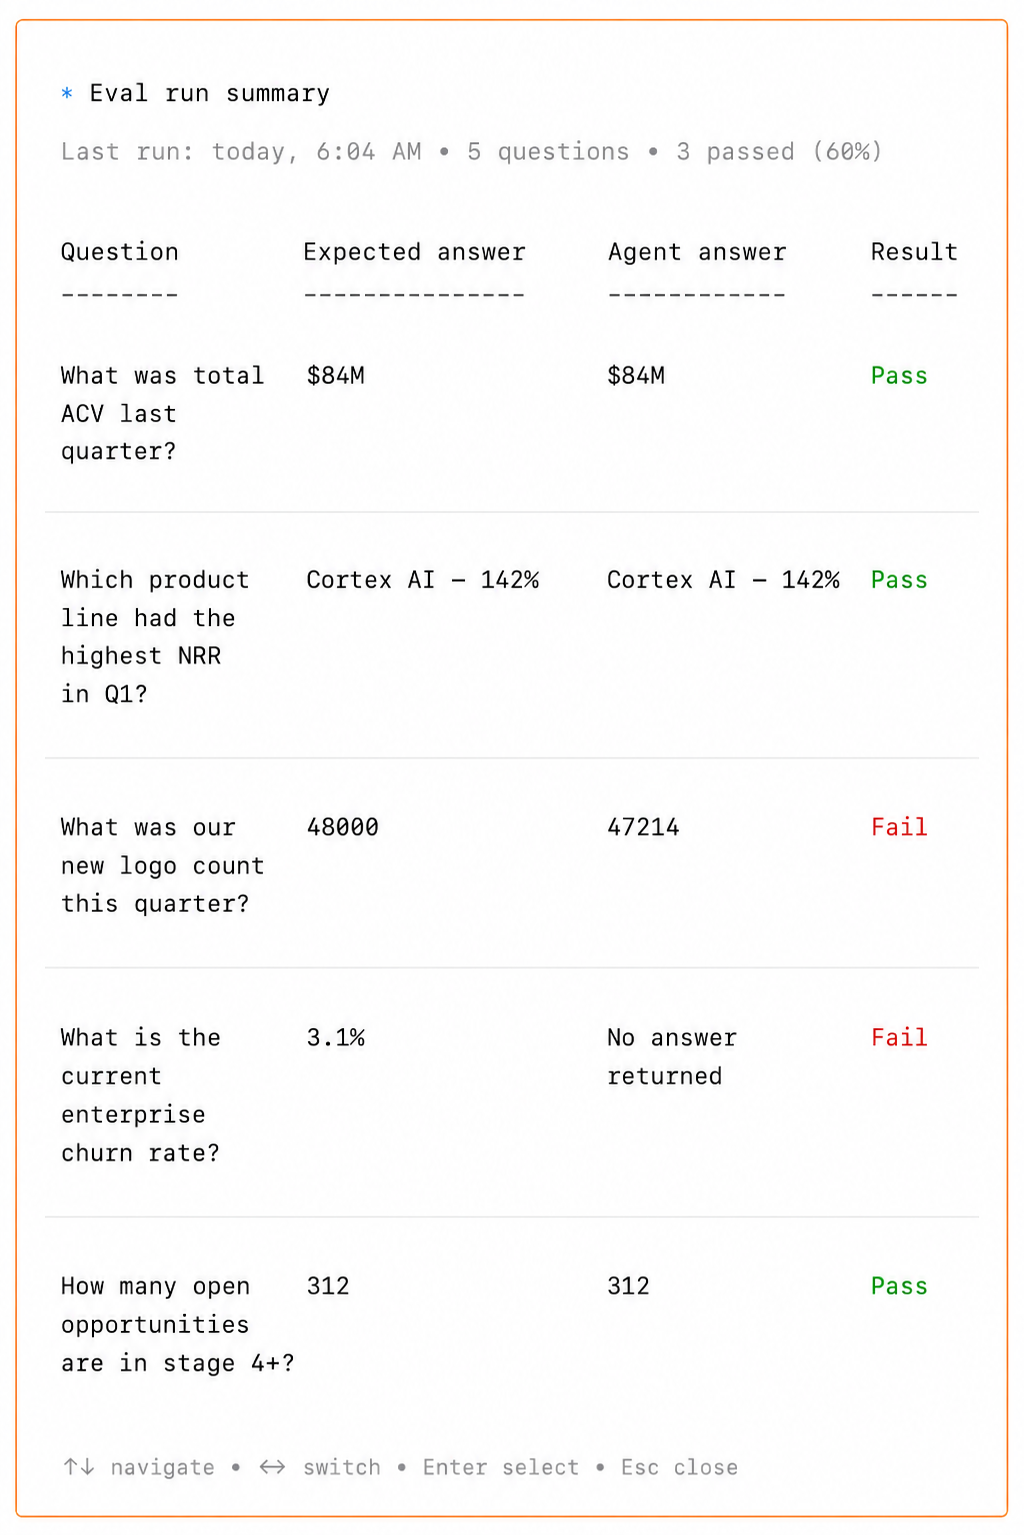
Snowflake CoCo zeigt Evaluierungsergebnisse mit Cortex Sense. (Die in dieser Abbildung aufgeführten Informationen sind fiktiv und basieren nicht auf echten Kunden- oder Snowflake-Daten.)
Wenn die Evaluierungen eine Lücke aufdecken, wird Cortex Sense sich selbst fundieren, anstatt zu raten. Um auf die Frage zurückzukommen, wie das neue Modell nach der Einführung abschneiden wird: Wenn es zwei widersprüchliche Definitionen dessen aufgegriffen hat, was ein Upgrade bedeutet, wird es diese Mehrdeutigkeit nicht in seinem Wissen belassen. Es wird den Konflikt dem Cortex Sense-Ersteller aufzeigen und den Menschen bitten, ihn zu lösen. Wir haben festgestellt, dass die Erzwingung dieses Maßes an Ehrlichkeit in Bezug auf den Kontext es von Systemen wie Retrieval-Augmented Generation (RAG) unterscheidet, die einfach abrufen, was gefunden wird. Wenn eine Evaluierung aus irgendeinem Grund fehlschlägt oder wenn widersprüchliche Informationen erkannt werden, wird Cortex Sense darüber nachdenken, warum, und versuchen, sein eigenes Verständnis zu aktualisieren. Wenn es das nicht kann, wird es um Hilfe bitten. Als wir beispielsweise begannen, Cortex Sense intern zu testen, fand es Dutzende verschiedener Definitionen von täglich aktiven Nutzer:innen. Jedes Team hatte sein eigenes System zur Berechnung dieser Metrik. Als es uns also fragte, mussten wir ihm nur in natürlicher Sprache erklären, welche Metrik zu welchem Team gehörte.
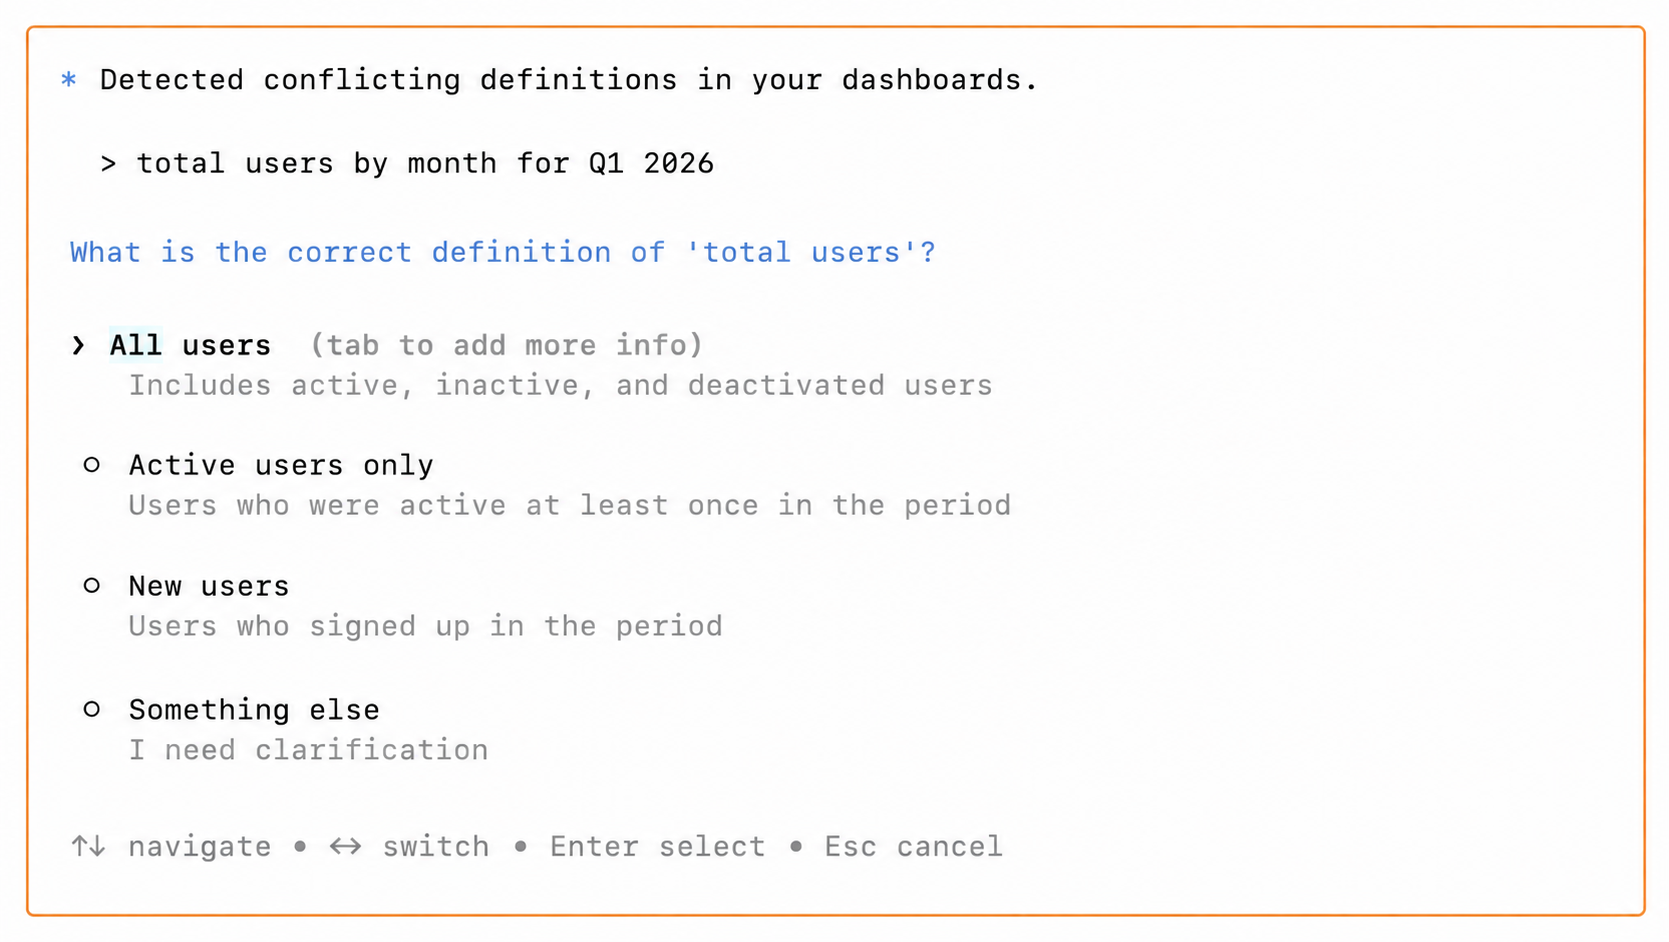
Wenn Signale in Konflikt geraten, ordnet Cortex Sense sie so ein, wie die Websuche Seiten einordnet: nach Relevanz, Autorität, Beliebtheit und Aktualität. Eine Metrikdefinition, die durch eine verwaltete semantische Ansicht gestützt wird, hat mehr Autorität als eine, die aus einer Handvoll Abfragen abgeleitet wird; ein Join-Muster, das in 500 Produktions-SQL-Anweisungen vorkommt, hat mehr Gewicht als eines, das in drei vorkommt; und eine im letzten Monat aktualisierte Definition ersetzt eine von vor zwei Jahren.
Eine der Fragen, die wir im Zusammenhang mit Cortex Sense typischerweise hören, ist, wie wir den Zugriff auf den Kontext verwalten werden. Cortex Sense wird nur Metadaten und Nutzungsmuster aufnehmen, nicht Ihre tatsächlichen Datenzeilen. Aber wie bei allen anderen Snowflake-Objekten wird der Zugriff durch die bestehende Governance von Snowflake rollenbasiert eingeschränkt. Wir starten unsere Private Preview in Kürze, indem wir Nutzer:innen erlauben, eine einzelne Rolle anzugeben, die Zugriff auf das gesamte Cortex Sense erhält, und planen, in Zukunft auf Kontexte pro Rolle zu erweitern, sodass Ihr Marketingteam und Ihr Finanzteam Zugriff auf unterschiedliche Kontexte erhalten.
Als wir dieses System zum ersten Mal für unsere internen Data Scientists freigaben, erreichte es bei einem frühen internen Evaluierungsset Parität mit ihren handkuratierten semantischen Ansichten, indem es auf der Arbeit aufbaute, die die Leute bereits in sie investiert hatten. Von da an zog es in zwei Bereichen davon: wo eine Definition veraltet war und in Domänen, die von bestehenden semantischen Ansichten nicht abgedeckt wurden. Bei diesem Set übertraf es die menschliche Performance um 10 Prozentpunkte, dank Signalen wie der jüngsten Abfragehistorie.
Um zu validieren, dass Cortex Sense einen Mehrwert bietet, haben wir es anhand einer Reihe schwieriger Fragen gebenchmarkt und dabei einen Frontier-Coding-Agenten mit direktem Zugriff auf die SQL-Ausführung über das Model Context Protocol (MCP), Vanilla CoCo (das bei Bedarf relevante semantische Ansichten abrufen konnte) und CoCo, das durch Cortex Sense fundiert wurde, verglichen. Cortex Sense verbesserte die Genauigkeit in unserem Benchmark von 24,1 % auf 86,3 %. Darüber hinaus senkte Cortex Sense im Vergleich zu einem Frontier-Agenten die Kosten von 1,76 USD auf 0,59 USD pro Abfrage, da es den Agenten daran hinderte, jede Tabelle manuell zu untersuchen. Der Frontier-Agent neigte dazu, DESCRIBE TABLE für Dutzende von Objekten auszuführen, was Token verschwendete und Latenz hinzufügte. Die Kostenvorteile von Cortex Sense werden teilweise durch anfängliche, einmalige Indexierungskosten ausgeglichen (die davon abhängen, wie viele Daten indexiert werden), aber im Allgemeinen haben wir festgestellt, dass sich die Kosten für die Vorab-Indexierung im Laufe der Zeit durch die niedrigeren Kosten pro Abfrage amortisieren können.
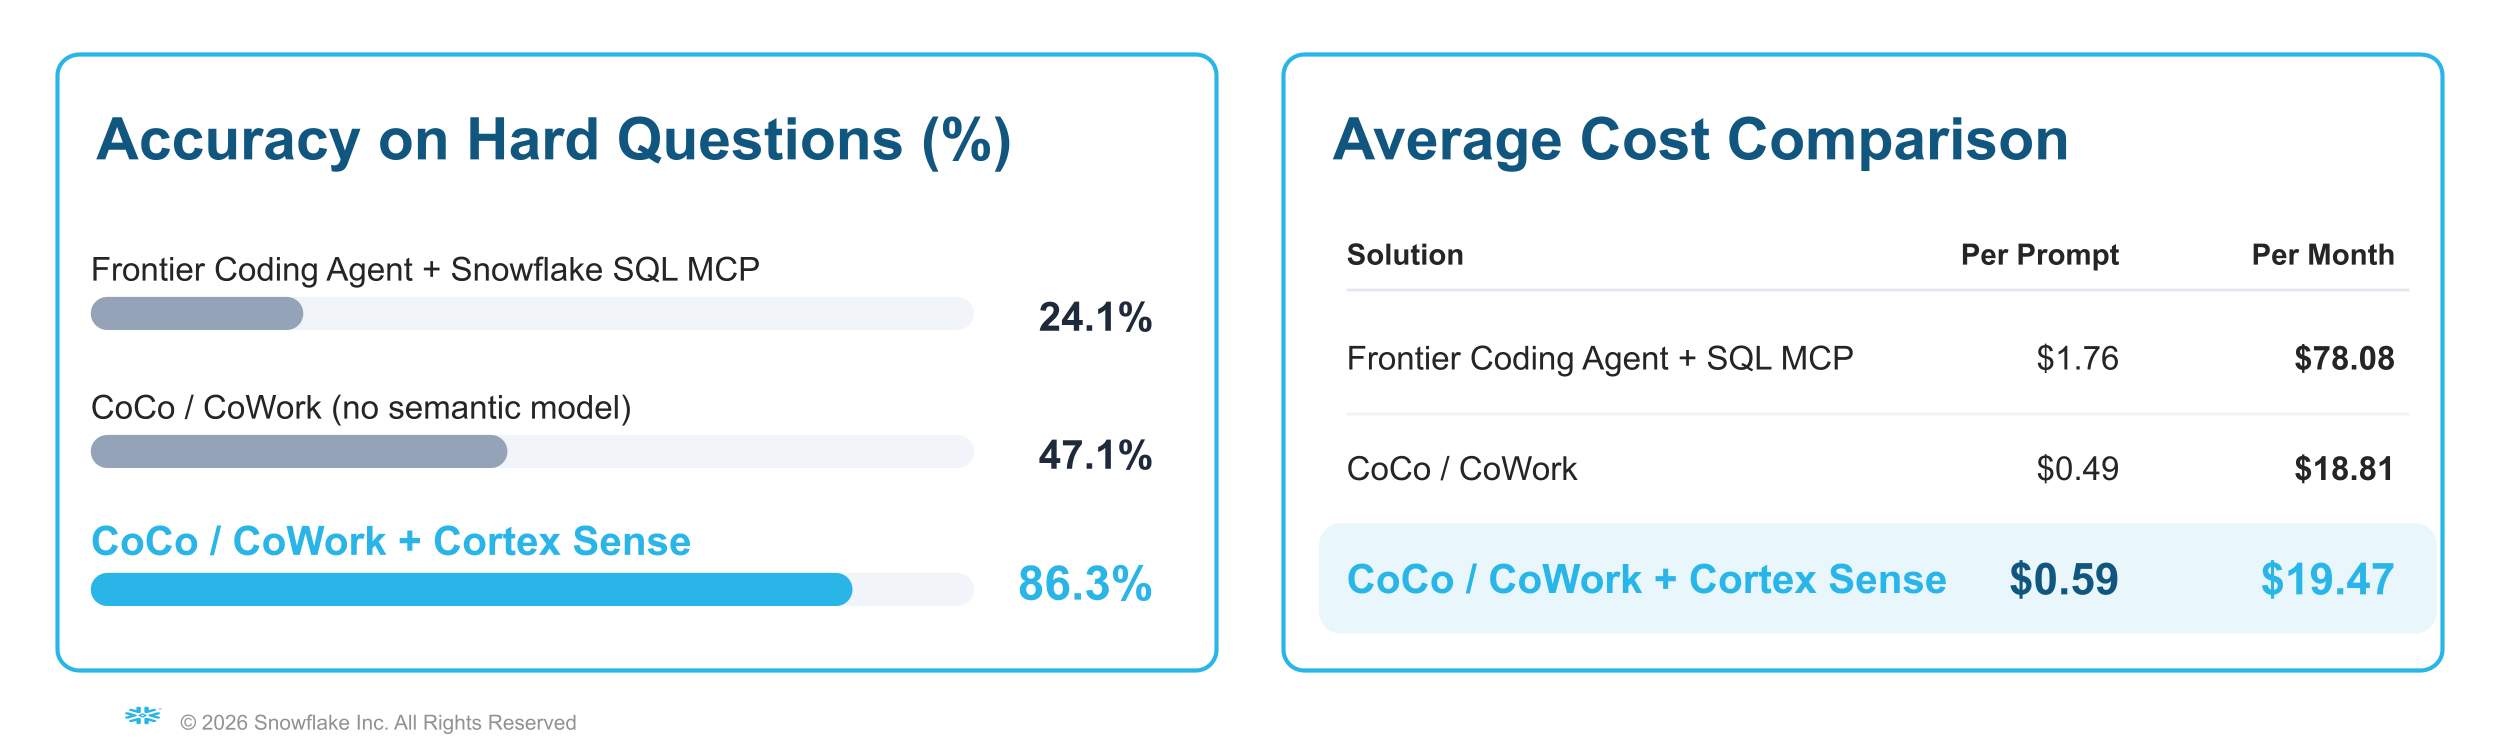
Basierend auf internen Testergebnissen und Kostenberechnungen im Juni 2026.
Die Einrichtung von Cortex Sense dauerte einen einzigen Tag und nicht die Monate, die diese Projekte normalerweise in Anspruch nehmen, da kein Beratungsauftrag oder manueller Aufbau abgewartet werden muss. Da keine neuen semantischen Ansichten erstellt werden müssen, stellen Sie einfach eine Verbindung zu den Quellen her und legen los, ohne tagelang kuratieren zu müssen. Auch das laufende Wartungsmodell ist anders. Während sich Ihr Datenbestand weiterentwickelt, nimmt Cortex Sense das Signal automatisch in einem kontinuierlichen Aktualisierungsrhythmus auf. Und wenn Sie sein Wissen wirklich aktualisieren möchten, ist der Korrektur-Workflow konversationsbasiert. Sie erklären die richtige Definition in natürlicher Sprache, und es aktualisiert sein Modell.
Als Lexika der Wikipedia wichen, bestand der Durchbruch nicht darin, dass die Menschen mehr wussten. Er bestand darin, dass Wissen nicht mehr etwas war, das Expert:innen regelmäßig veröffentlichten, sondern anfing, sich von selbst weiterzuentwickeln. Der Unternehmenskontext befindet sich im selben Moment: Semantische Ansichten bleiben der Goldstandard, wo Sie verwaltete, konsistente Antworten benötigen, aber sie sollten nicht die einzige Möglichkeit sein, wie eine KI Ihr Unternehmen kennenlernt. Cortex Sense lernt aus den Signalen, die Sie bereits produzieren, und verbessert sich kontinuierlich, während es sich verändert.
Wir freuen uns unglaublich darauf, dieses Produkt mit der Welt zu teilen. Cortex Sense wird Mitte Juli in die Private Preview gehen. Wenn Sie Vorabzugang wünschen, wenden Sie sich bitte an Ihren Snowflake-Kundenbetreuer.
Zukunftsgerichtete Aussagen: Dieser Artikel enthält zukunftsgerichtete Aussagen, unter anderem über künftige Produktangebote. Diese Aussagen stellen keine Garantie dar, dass diese Angebote wirklich bereitgestellt werden. Die tatsächlichen Ergebnisse und Angebote können abweichen und unterliegen bekannten und unbekannten Risiken und Unsicherheiten. Weitere Informationen finden Sie in unserem neuesten 10-Q-Bericht.