
고객 사례
네오위즈, Snowflake로 전사 데이터 운영 체계와 자체 AI 에이전트를 완성하다
네오위즈는 게임별로 흩어져 있던 데이터 환경을 Snowflake로 통합하여, 게임 확장에 구애받지 않는 안정적인 데이터 플랫폼을 완성했습니다. 매일 1,843개 테이블에 140억 행 이상을 안정적으로 적재하는 이 기반 위에서, 비용이 늘어난 원인을 스스로 찾아 개선안까지 만드는 자체 AI 에이전트 Snow-Q를 직접 구축해 데이터 운영 TCO를 최적화하고, AI 파이프라인 전환과 현업 셀프서비스까지 전사적인 데이터 고도화를 실현하고 있습니다.
업종
Advertising, Media & Entertainment위치
Korea고객사 소개: 오래도록 팬들의 마음에 남는 IP를 선보이는 네오위즈
네오위즈는 'P의 거짓', '디제이맥스 리스펙트 시리즈', '피망 웹보드 게임', '고양이와 스프', '브라운더스트2'로 대표되는 독창적인 자체 개발 IP와 '스컬', '산나비', '셰이프 오브 드림즈' 등 검증된 퍼블리싱 라인업을 보유한 글로벌 게임사입니다. 탄탄한 개발력과 전문화된 퍼블리싱 역량을 바탕으로 플랫폼과 국경을 넘어 글로벌 팬덤과 소통합니다. 'Built for Fans. Made to Last.'라는 슬로건 아래 오래도록 팬들의 마음에 남는 IP를 선보입니다.
주요 내용
- 검증된 안정성과 경제성: 34개 실전 시나리오 PoC와 Redshift 대비 3년 TCO 72% 수준의 경제성을 검증한 Snowflake 통합 플랫폼으로, 매일 140억 행(CDC)과 2.1억 건(Kafka)의 대규모 데이터를 지체 없이 처리합니다.
- 게임 확장에도 운영은 그대로: 게임별 독립성을 보장하는 OPT(Object Per Tenant) 구조와 코드 기반의 자동화 설계를 통해, 신규 서비스가 추가되어도 운영 리소스는 늘지 않는 구조를 완성했습니다.
- 변화에 대응하는 속도: 자체 구축한 Snow-Q가 비용 병목을 자동으로 탐지·개선하고, 새로운 게임과 AI 서비스를 별도 인프라 없이 같은 데이터 기반 위에서 바로 시작할 수 있는 구조를 완성했습니다.
서비스가 확장될수록, 관리 효율을 높이는 구조적 전환이 필요했다
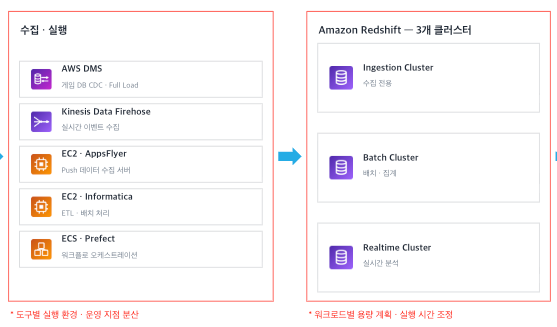
네오위즈는 AWS 위에서 Amazon Redshift를 중심으로 데이터를 수집하고 가공해 왔습니다. 그런데 데이터 소스가 늘 때마다 이를 처리하는 도구와 운영 지점이 계속 흩어졌고, 레드시프트도 수집·배치·실시간용 3개 클러스터로 나뉘어 있어 게임이 추가될 때마다 용량 계획을 다시 세우고 확인할 지점이 늘어났습니다.
기존 플랫폼이 작동하지 않았던 것은 아니었습니다. 핵심은 사업이 커질수록 운영 부담도 함께 늘던 구조에서, 유연하면서도 안정적으로 확장되는 데이터 플랫폼 체계로 전환하는 것이었습니다. 네오위즈는 Snowflake 도입을 저장소 교체가 아니라 전사 데이터 플랫폼 전체를 바꾸는 문제로 정의하고, 하나의 원칙을 세웠습니다. 엔터프라이즈 AI는 거창한 AI 모델이 아니라, 신뢰할 수 있고 운영 가능한 데이터에서 시작된다는 것입니다.
Snowflake 도입 배경: "우리 환경에서 실제로 운영 가능한가"로 검증했다
이러한 원칙 하에, 네오위즈는 성능·확장성, 운영 표준화, 비용 예측, 보안·거버넌스라는 4대 과제를 그대로 평가 기준으로 삼고, PoC와 데모, 3년 총소유비용(TCO)의 관점에서 정밀하게 검증했습니다.
PoC는 적재 7개, 변환 6개, 제공 11개, 보안 7개, 모니터링 3개로 총 5개 영역 34개 실전 시나리오로 구성했습니다. 특히 현업이 쓰던 BI 도구와 API 연결이 차질 없이 유지되는지 확인하는 운영(Delivery) 검증에 큰 비중을 뒀습니다. 기능 제공 여부가 아니라 기존 AWS 환경과의 연결과 데이터 흐름을 실제로 재현할 수 있는지를 본 것입니다.
검증 결과, Snowflake는 하나의 데이터 기반 위에서 용도별 컴퓨팅 자원을 독립적으로 운영할 수 있다는 점이 강점이었습니다. 여러 클러스터를 나눠 관리하는 대신 단일 플랫폼 안에서 데이터와 권한, 워크로드를 표준화할 수 있다는 것이 선택의 결정적 이유였습니다.
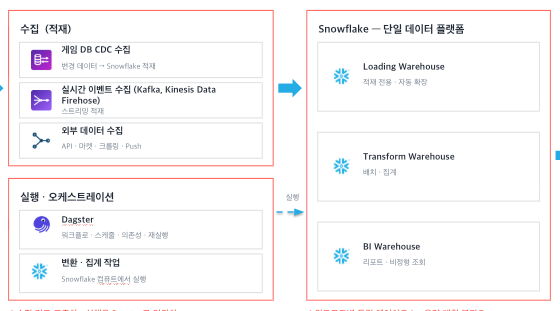
에디션 선택 시에도 현실적 제약을 엄격히 확인했습니다. 초기에는 보안 강화를 위해 비즈니스 크리티컬(Business Critical) 에디션을 검토했으나, 실제로 구성해 보니 AWS PrivateLink 설정 시 서울 리전 내 인터페이스 VPC 엔드포인트 서브넷이 가용 영역별 1개(총 3개)로 제한되고, AWS와 Snowflake 양쪽에 복잡한 추가 설정이 필요하다는 점을 확인했습니다.
이에 실질적인 보안 요구사항과 네트워크 구조, 운영 비용을 다각도로 비교해 최종적으로 엔터프라이즈(Enterprise) 에디션을 채택했으며, 이 과정에서 도출된 네트워크 제약은 다음 설계 단계의 조건으로 미리 반영했습니다. 제약을 발견한 데 그치지 않고, 그것을 곧바로 설계 조건으로 옮길 수 있었다는 점이 중요했습니다.
설계: 게임별 독립성과 공통 표준을 함께 잡은 OPT 구조
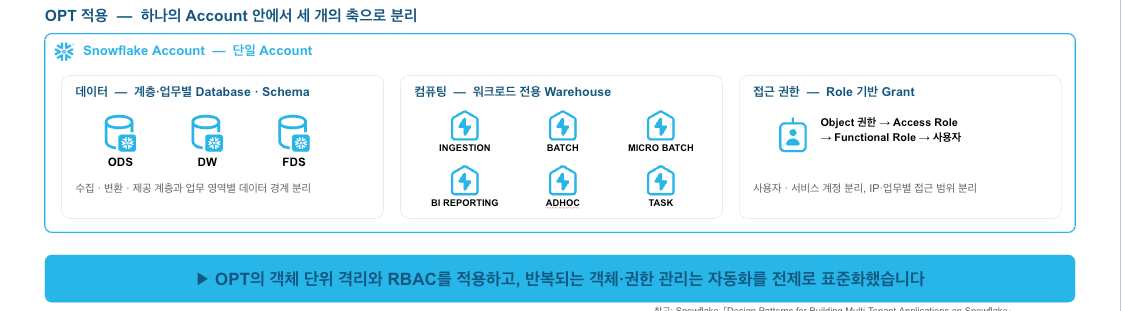
계정 구조 설계 시 네오위즈는 Snowflake의 멀티테넌트 설계 패턴을 참고해 세 가지 안을 비교했습니다. 여러 게임이 테이블과 컴퓨팅을 공유해 객체 경계를 나누기 어려운 MTT(Multi-Tenant Table), 게임별 계정 분리로 격리는 확실하지만 계정마다 구성·권한·운영 표준을 반복 관리해야 하는 APT(Account Per Tenant) 대신, 단일 어카운트 내에서 게임 IP별 객체를 독립 분리하는 OPT(Object Per Tenant) 방식을 최종 채택했습니다. 기존 레드시프트에서 그룹에 스키마 권한을 주던 방식과 유사하고, 역할 기반으로 객체별 권한을 유연하게 설정할 수 있었기 때문입니다.
OPT 안에서는 세 개의 축을 명확히 분리했습니다. 데이터는 수집·통합·서비스 계층에 따라 ODS와 DW, FDS로 나누고, 컴퓨팅은 적재·배치·마이크로배치·BI·애드혹·태스크 등 용도별 전용 웨어하우스로 구분했으며, 접근 권한은 역할 기반으로 나눴습니다. 게임이 늘어나면 객체와 권한 관리가 복잡해질 수 있다는 약점은, 신규 게임 영역 구성과 권한 설정 자동화를 처음부터 운영 전제로 설계해 보완했습니다.
데이터와 사용자가 들어오는 길목의 보안 체계도 사전에 고정했습니다. AWS와 Snowflake를 동일한 서울 리전에 배치하고, 사용자 인증은 키클락(Keycloak) 기반 SAML SSO를 통한 MFA(다중 인증) 로그인을 적용했습니다. 키 관리 부담과 네트워크 정책 제약이 있는 개인 액세스 토큰(PAT)은 배제하고, 서비스 계정 프로그램에는 Key Pair 방식을 채택했습니다.
권한은 "객체 권한 → Access Role → Functional Role → 사용자"로 상속되는 3계층 RBAC를 적용해, 객체가 바뀌는 영역과 조직이 바뀌는 영역을 분리해 관리하도록 설계했습니다. 이렇게 경계를 먼저 고정해 두면, AI도 허용된 범위 안에서만 데이터를 확인하게 됩니다.
이관: 프로그램 실행이 아니라 데이터 결과의 정합성으로 완료를 판단
이관 작업은 단순 데이터 이관을 넘어 ETL과 리포트, 권한, 운영 절차 전체를 대상으로 진행했습니다. 원천별 데이터 변경 특성과 적재 주기, 복구 가능성을 기준으로 적재 방식을 정하고, 명명 규칙과 표준 로직을 먼저 수립했습니다. 자동화와 AI는 도구로만 사용하고, 결과와 정합성은 별도로 검증했습니다.
가장 중요한 판단은 순서였습니다. 현재 작동 중인 파이프라인과 변환 로직을 Snowflake 상에서 먼저 안정화한 뒤, 과거 데이터를 단계적으로 백필(Backfill)해 채워 넣었습니다. 현재 파이프라인이 제대로 동작하는지 확인한 후 과거를 채웠기 때문에, 기준일이 섞이거나 데이터가 중복되는 위험을 줄일 수 있었습니다.
네오위즈는 이관 완료의 기준을 단순한 "프로그램 실행 완료"가 아니라 "데이터 결과의 정합성을 설명할 수 있는 상태"로 규정했습니다. 기존 환경과 신규 환경을 동시에 운영하며 건수와 주요 수치를 비교하고, 차이가 확인되면 두 가지로 나눠 처리했습니다.
로직이나 데이터 오류는 수정 후 재검증하고, 연동 방식이나 형식 때문에 생긴 의도된 차이는 현업과 합의해 예외로 관리했습니다. 모든 값이 똑같은 상태가 아니라, 차이의 원인을 설명하고 합의할 수 있으며 운영 담당자가 재처리와 장애 대응 절차를 온전히 인계받은 상태를 정합성 확보로 보았습니다. 이렇게 확보한 정합성은 훗날 AI가 어떤 데이터를 근거로 답했는지 신뢰하게 만드는 기본 조건이 되었습니다.
운영: 코드로 통제하는 인프라와 매일 140억 행의 적재 체계
운영에서 가장 먼저 정한 것은 도구가 아니라 무엇을 코드로 통제할지였습니다. 웨어하우스 비용을 통제하고 변경 이력을 남기며 계정 구성을 재현 가능하게 만들기 위해, 네오위즈는 코드 기반 인프라 관리(IaC)의 경계를 통제 대상에 맞게 나눴습니다.
AWS 인프라는 사내 표준인 테라폼(Terraform)으로 유지하고, Snowflake의 웨어하우스·계정 설정·연동 등 인프라성 리소스는 풀루미(Pulumi)로 통제했으며, 변경이 잦은 RBAC 권한은 SQL 문으로 관리했습니다. 하나의 도구로 통일하지 않고, 통제 대상과 변경 특성에 맞춰 관리 경계를 나눈 것입니다.
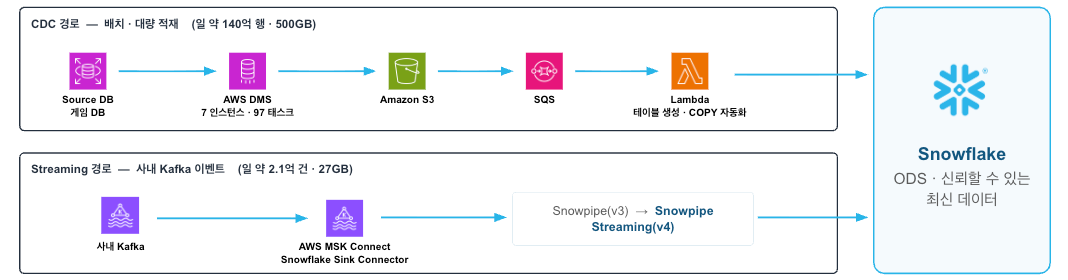
데이터 적재는 속도가 다른 두 개의 대규모 흐름을 매일 안정적으로 받아들이는 체계로 다졌습니다. 첫째, DB 변경분을 실시간으로 따라잡는 CDC(변경 데이터 수집) 파이프라인은 AWS DMS 인스턴스 7개와 태스크 97개를 통해 1,843개 테이블에서 하루 약 140억 행(약 500GB)을 수집합니다.
둘째, 사내 카프카(Kafka) 이벤트 스트림은 MSK Connect와 Snowflake 싱크 커넥터를 거쳐 하루 약 2.1억 건(약 27GB)을 Snowpipe Streaming 체계로 실시간 적재합니다. 기존 Snowpipe 방식에서 버전 변경과 신규 MSK 이전이 겹치면서 Snowpipe Streaming 기반으로 다시 구성한 것입니다.
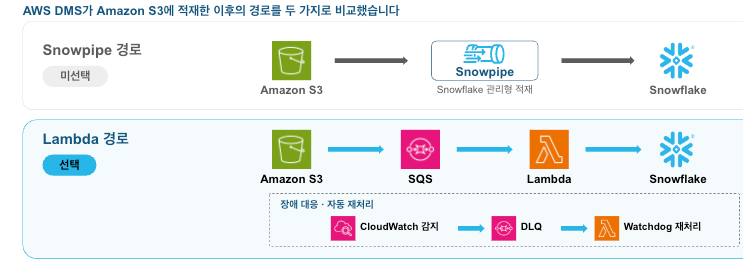
DMS가 S3에 적재한 이후 구간은 두 방식을 비교해 결정했습니다. Snowflake가 관리해 주지만 테이블과 파이프를 각각 정의해야 하는 Snowpipe와, S3에서 SQS를 거쳐 적재하며 DMS에 테이블을 추가하면 Snowflake 테이블 생성과 COPY까지 자동 처리하는 Lambda 방식을 놓고 검토했습니다.
테스트 구간에서는 Snowpipe 비용이 약 10% 낮았지만 1,843개 테이블 규모에서는 비용 예측이 어려웠고, 대규모 테이블 자동 온보딩과 CloudWatch·DLQ·Watchdog 기반의 장애 자동 재처리가 용이한 Lambda 방식을 최종 선택했습니다.
컴퓨팅은 적재·배치·BI·애드혹 등 용도별로 웨어하우스를 분리하고, 쿼리 태그로 어떤 작업이 어디에서 실행됐는지 식별해 지연 원인이 쿼리인지 큐잉인지 웨어하우스 구성인지 좁혀 조정했습니다.
고도화: 숨은 병목을 찾아내는 자체 비용 분석 AI 에이전트 Snow-Q
웨어하우스 운영을 단일 쿼리의 성공률이나 실행시간만으로 보면 숨은 병목을 놓칠 수 있습니다. 실제로 쿼리 성공률은 99.98%로 문제가 없어 보였지만, 1회 19.27초로 짧은 반복 MERGE 쿼리 하나가 주간 누적 처리시간 2,125시간(1주일 168시간의 12.6배)을 기록하며 지속적으로 컴퓨팅 부하를 유발하고 있었습니다. 네오위즈는 판단 축을 실행 빈도와 누적 처리시간, 소비 크레딧으로 넓히고, 고비용 쿼리 분석을 자동화하는 Snow-Q를 Snowflake 위에 직접 구축했습니다.
전체 운영 크레딧 중 웨어하우스 크레딧이 89%를 차지했기에 우선순위를 웨어하우스 실행 쿼리에 두고, 실행 이력과 비용·접근 데이터를 별도 테이블로 축적했습니다. 현재 약 5억 5,000만 건의 쿼리 이력(Query History)을 분석 기반으로 삼되, 비용이 변한 웨어하우스를 먼저 찾고, 영향받는 워크로드를 확인한 뒤, 개선 대상 쿼리를 선정하는 방식으로 위에서 아래로 좁혀갑니다.
분류 기준은 느린 쿼리가 아니라 비용을 만드는 세 가지 패턴, 즉 고비용 단일 실행, 동일 SQL 반복, 파티션 95% 이상 스캔입니다.
선정한 쿼리는 AI에게 한 번에 고쳐 달라고 하지 않고, 접근 패턴(JOIN·WHERE 조건의 카디널리티와 분포), 실행 계획(I/O 병목, 메모리 스필), 객체 관계(리니지), 비용 추세의 네 관점으로 나눠 병렬 분석한 뒤 다시 종합합니다.
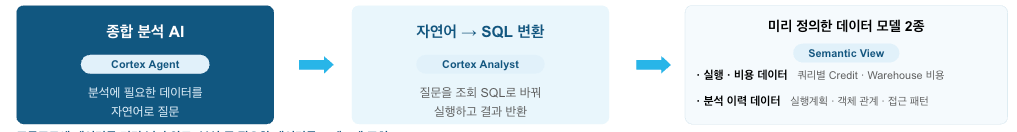
분석을 수행하는 주체는 Snowflake의 Cortex Agent입니다. Cortex Agent는 분석에 필요한 데이터를 프롬프트에 미리 담아 두지 않고, Cortex Analyst와 미리 정의한 두 종류의 시멘틱 뷰(Semantic View)를 통해 그때그때 데이터에 직접 질의해 가져옵니다. 데이터를 AI가 있는 곳으로 옮기지 않고, AI가 데이터가 있는 자리에서 조회하는 방식입니다.
이 전체 과정은 ①대상 쿼리 지정 → ②4개 영역 병렬 분석 → ③분석 결과 종합 → ④개선안 도출 → ⑤개선 SQL 생성 → ⑥전후 성능 비교에 이르는 태스크(Task) 기반 6단계 워크플로로 정의해 자동 반복 실행합니다.
산출물은 단순한 SQL 문법 수정에 그치지 않습니다. 실행 주기나 캐싱을 조정하는 Application 층, 클러스터링 키를 재정렬하는 Table 층, 스캔을 최적화하는 Query 층의 세 층위로 다각화된 개선안과 종합 평가 등급, 병목 우선순위, 구현 로드맵을 함께 제시합니다.
나아가 조직별 비용 귀속을 위한 Snow FinOps와 AI 사용량을 집계·차단하는 Cortex Code 예산 거버넌스를 결합해, 데이터와 AI 사용 비용 전반을 통합 통제하고 있습니다.


AI로의 확장: 데이터 파이프라인 전환 및 현업 셀프서비스
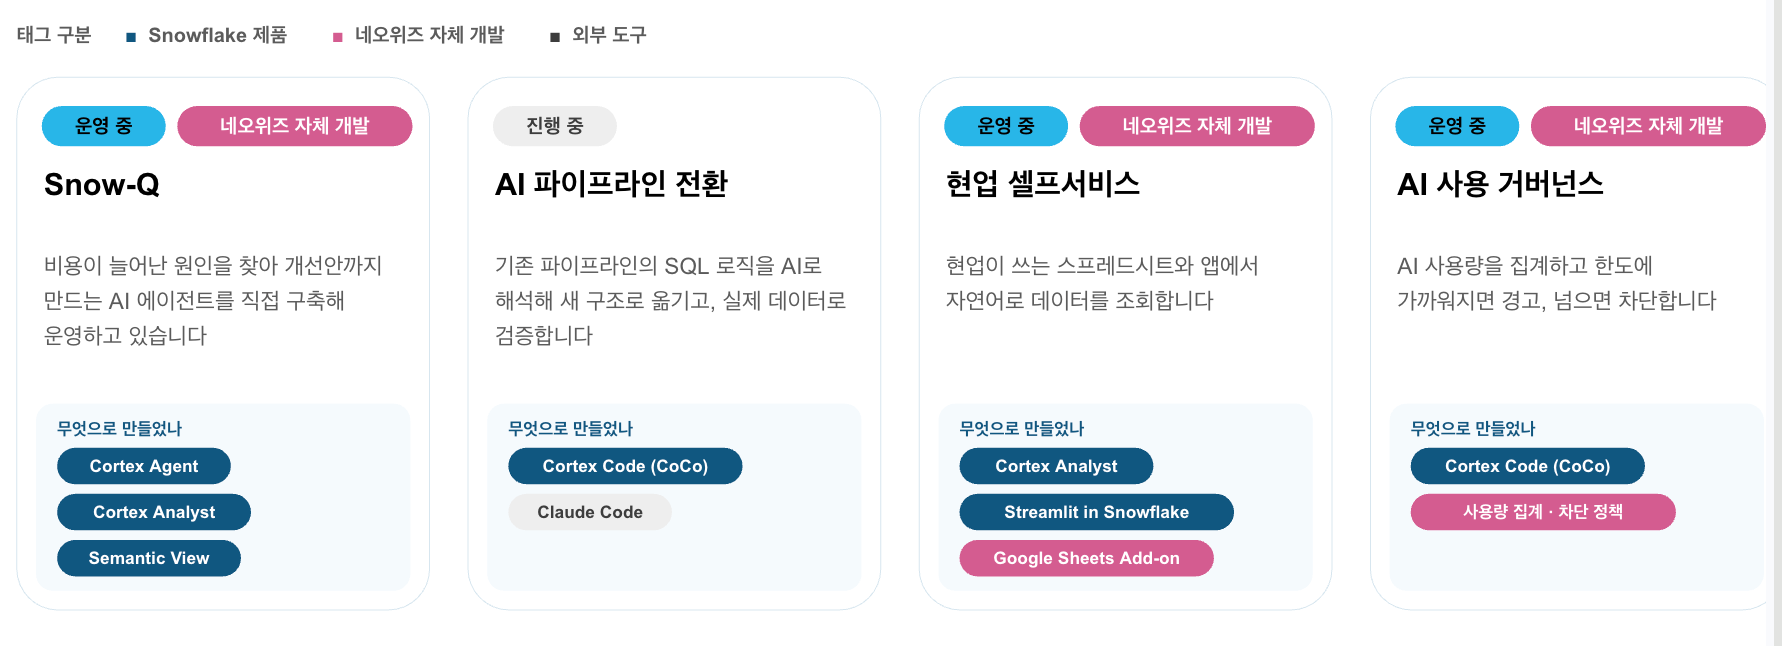
Snowflake 위에 단일화된 신뢰 기반(SSOT)을 확보한 네오위즈는 AI 활용 범위를 실무 전반으로 대폭 확장했습니다.
첫째, AI 기반 파이프라인 전환입니다. 기존 Informatica 파이프라인을 Dagster Asset 구조로 옮기면서, 파이프라인 바깥의 구조·코드는 Claude Code가, Snowflake 내부의 SQL 로직 해석과 데이터 검증은 Snowflake CoCo가 맡도록 역할을 나눠 전환 속도와 정확도를 높였습니다.
둘째, 현업 셀프서비스입니다. 사용자를 데이터로 부르는 대신, 현업에 익숙한 Google Sheets에서 Snowflake 데이터를 바로 조회·갱신하는 커넥터를 자체 개발했습니다. 여기에 Cortex Analyst 기반 자연어 질의와 Streamlit 보고 자동화를 연동하여, 현업 사용자가 데이터 분석가 도움 없이도 직접 필요한 데이터를 시각화된 보고서나 대시보드 형태로 즉시 확인할 수 있게 했습니다.
셋째, AI 사용 거버넌스입니다. CoCo로 사용자별 AI 사용량을 집계해 한도에 가까워지면 경고, 넘으면 차단합니다.
도입 효과: 다음 변화를 더 빠르고 안전하게 시작하는 기반
레드시프트 중심의 다중 클러스터 구조에서 Snowflake 단일 플랫폼과 용도별 독립 웨어하우스 구조로 전환한 결과, IT 조직에는 운영 복잡도와 성능 간섭을 줄이는 기반이, 비즈니스에는 신규 게임과 분석 요구가 늘어도 플랫폼이 병목이 되지 않는 확장성이 남았습니다.
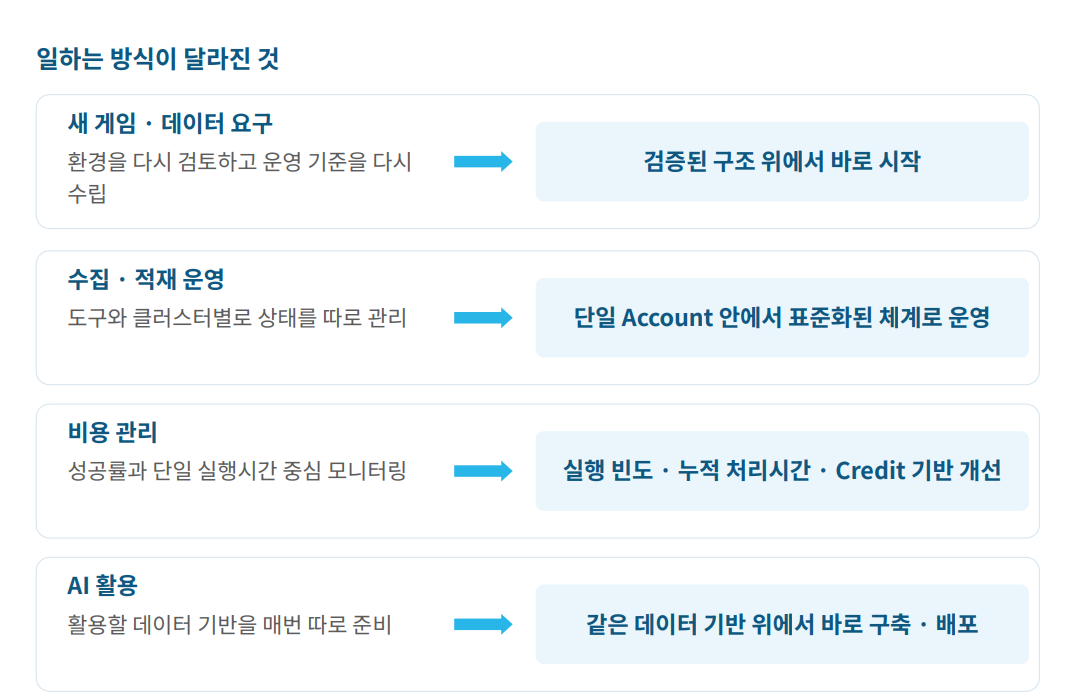
① 변화 대응 속도의 전환(Scalability): 새 게임이나 데이터 요구가 생길 때마다 환경을 다시 설계하던 방식에서, 검증된 공통 기반 위에서 즉시 구축·배포하는 방식으로 바뀌었습니다.
② 수집·적재 운영의 표준화: 예전에는 도구와 클러스터별로 상태를 따로 관리해야 했지만, 이제는 단일 어카운트 안에서 수집·적재와 권한·변경을 표준화된 체계로 일관되게 운영합니다.
③ 보이지 않던 비용을 관리 대상으로(FinOps): 성공률 중심의 모니터링을 실행 빈도와 누적 처리시간, 크레딧 기반의 선순환 개선 루프로 바꿨습니다. Snow-Q를 통해 상시 부하를 일으키는 쿼리를 자동 포착하고 종합 개선안을 적용함으로써 데이터 운영 TCO를 최적화했습니다.
④ 신뢰할 수 있는 데이터 위에서 바로 만드는 AI(Data to AI): 파이프라인 이관(CoCo), 비용 분석(Snow-Q), 현업 셀프서비스(Sheets Add-on), 사용량 통제(예산 거버넌스)에 이르는 4가지 핵심 AI 서비스를 별도의 인프라 구축 없이 동일한 Snowflake 데이터 체계 위에서 즉시 구축하고 성공적으로 작동시켰습니다.
신뢰할 수 있는 데이터에서 판단과 실행으로
네오위즈는 지금의 데이터 구조와 권한, 적재 체계 위에서 AI의 역할을 실시간 게임 관제, 운영 상황 판단, 백오피스 자동화, 게임 AI 데이터 공급으로 넓혀갑니다. Snowflake 기반의 표준화된 데이터 구조와 보안·권한 체계는 새로운 비즈니스 요구를 더 빠르게 구현하고 안전하게 배포할 수 있는 토대가 되었습니다.

엔터프라이즈 AI는 거창한 AI 모델에서 시작하는 것이 아니라, 신뢰할 수 있고 지속 운영 가능한 데이터에서 출발합니다. 저희는 Snowflake 단일 플랫폼 위에 전사 데이터 운영 체계를 세워, 신규 게임이 늘어도 시스템을 다시 설계하지 않는 확장 기반을 확보했습니다. 그리고 그 위에 비용의 원인을 스스로 찾아 개선하는 자체 AI 에이전트를 완성했습니다.”
네오위즈 데이터서비스실 데이터엔지니어링팀 팀장


