
고객 사례
뱅크샐러드, 데이터 인프라 혁신으로 '서비스와 AI가 믿고 쓰는 데이터 기반'을 완성하다
뱅크샐러드는 기존 Spark 환경을 Snowflake로 전환하며 연간 데이터 비용을 대폭 절감하고 운영 안정성을 확보했습니다. 서비스 중단 없는 인프라 이관으로 배치 복구 부담을 해소했으며, 엔지니어들이 반복적인 인프라 관리 업무에서 벗어나 데이터 기반의 서비스 혁신에 집중할 수 있는 안정적인 데이터 기반을 확보했습니다.

업종
Financial Services위치
Korea고객사 소개: 데이터로 더 나은 선택을 돕는 뱅크샐러드
뱅크샐러드는 핀테크, 마이데이터, 디지털 헬스케어를 주요 영역으로 하는 데이터 전문 기업으로, 대한민국 최초로 금융 마이데이터 서비스를 출시한 이후 개인화된 자산관리 서비스를 선도하고 있습니다. 현재 150여 명의 임직원이 누적 앱 다운로드 1,200만 건 이상의 대규모 서비스를 운영하며, 자산 관리 및 수입·지출 분석(PFM), 금융상품 중개, 건강검진 및 보험 상담 연계 등의 데이터 기반 서비스를 제공하고 있습니다.
모든 서비스가 고객 데이터를 정확히 이해하고 정교하게 계산하여 필요한 가치로 연결한다는 공통점을 지니는 만큼, 데이터를 안정적으로 집계하고 서빙 계층으로 전달하는 데이터 인프라의 신뢰성은 뱅크샐러드 비즈니스의 핵심입니다.
주요 내용
- 안정성: Spot 인스턴스 회수로 하루 10회 넘게 발생하던 배치 실패가, Snowflake 전환(2024년 8월) 이후 수동 재실행 일평균 0회로 사라졌습니다.
- 비용: 기존 AWS 기반 환경 대비 실제 운영 비용을 크게 절감했습니다.
- 통합: Airflow, EKS/PySpark, S3, Glue, Athena, Spark SQL Thrift Server로 흩어졌던 파이프라인을 Snowflake 하나로 통합했습니다. 그 위에서 실시간 개인화(내 자산 순위)와 쿼리 기반 실시간 타겟팅(알림) 등의 서비스를 분석과 동일한 기반 위에서 구현합니다.
반복되는 배치 복구가 삼킨 엔지니어의 시간
2023년 초, 뱅크샐러드 데이터 엔지니어링 팀은 제한된 인원 속에서 복잡한 아키텍처를 운영하는 부담을 안고 있었습니다. 당시 분석계 아키텍처는 Airflow가 오케스트레이션을 맡고, EKS 환경의 PySpark가 데이터 변환과 집계를 수행한 뒤 S3에 적재하는 구조였습니다. 이후 AWS Glue(메타데이터), Spark SQL Thrift Server·Athena(조회), Metabase·JupyterHub(분석)를 거쳐 활용하는 다층 구조를 갖추고 있었습니다. 이 구조의 문제는 비용 효율을 위해 사용하던 AWS EKS 스팟 인스턴스의 강제 회수였습니다. 노드 회수로 일배치 파이프라인이 반복 실패했고, 담당 엔지니어는 로그 확인과 실패 지점 재실행 등 수동 복구 작업에 하루 10번 이상 시달려야 했습니다.
파이프라인을 개선하는 엔지니어링 대신 전날 실패한 배치를 복구하는 데 시간을 쏟는 일이 잦았습니다. 또한 복구 지연은 매일 아침 앱을 열기 전 데이터가 서빙 계층에 도착하지 못하는 리스크를 초래했고, 분석 쿼리 역시 3~4분, 대시보드 로딩은 10분 이상 걸려 분석가의 생산성을 저해했습니다.
Snowflake를 선택한 배경: 기술, 운영, 비용
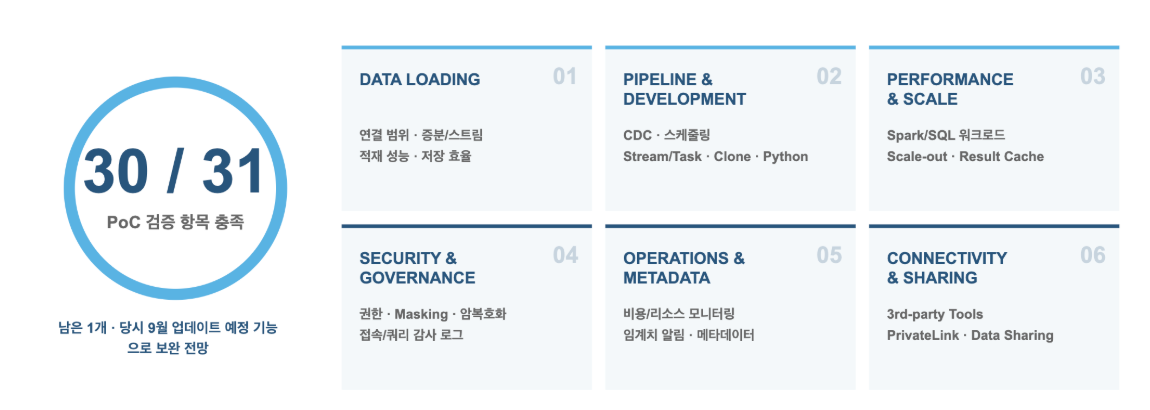
뱅크샐러드는 2023년 8월, 단순히 기능 구현 여부를 확인하는 수준을 넘어, 실제 운영 시나리오를 투영한 철저한 PoC(개념 검증)를 수행했습니다. 데이터 로딩, 파이프라인/개발, 성능/스케일, 보안/거버넌스, 운영/메타데이터, 연결성/공유(기존 도구 연동, PrivateLink, 계정 간 공유) 등 6개 핵심 범주에서 총 31개 항목을 엄격하게 검증한 결과, 30개 항목을 즉시 충족하며 Snowflake의 기술적 완성도와 운영 안정성을 확인했습니다. 이 과정을 통해 뱅크샐러드는 Snowflake가 기존 데이터 환경의 불안정성을 근본적으로 해소할 수 있는 플랫폼임을 확인했습니다.
기술 적합성과 운영 가능성에 더해, 비용 모델에서 기존 환경 대비 연간 약 63% 절감 가능성을 확인하며 Snowflake를 선택했습니다.
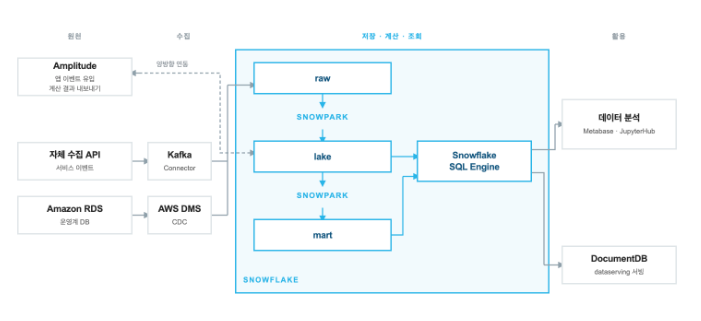
입력부터 활용까지 이어지는 공통 계산 기반
기존에 분리되어 운영되던 Spark, Glue, Athena, Thrift Server의 기능이 Snowflake 단일 플랫폼으로 완전 통합되었습니다. Snowflake 내부에는 Raw, Lake, Mart의 3단계 구조로 데이터를 정제하며, 계층 간 데이터 가공 및 통계 연산은 스노우파크 파이썬(Snowpark Python)과 SQL을 활용합니다. 이 전체 이관은 사용자 기능을 한 번도 중단하지 않은 채 진행됐습니다.
운영 방식도 함께 정립했습니다. 전체 파이프라인은 데이터 도메인과 실행 주기에 따라 여러 태스크 그래프(Task Graph/DAG)로 분할 운영됩니다. 모든 파이프라인 정의는 테라폼(Terraform)을 활용한 IaC 코드로 관리되어 리뷰 후 반영되며, 개인정보 암호화, 운영·스테이징 계정 분리, RBAC 권한 제어, 네트워크 정책, Query/Login/Access History 감사 로그 별도 보관 등 금융권 수준의 거버넌스와 보안 체계를 확립했습니다.
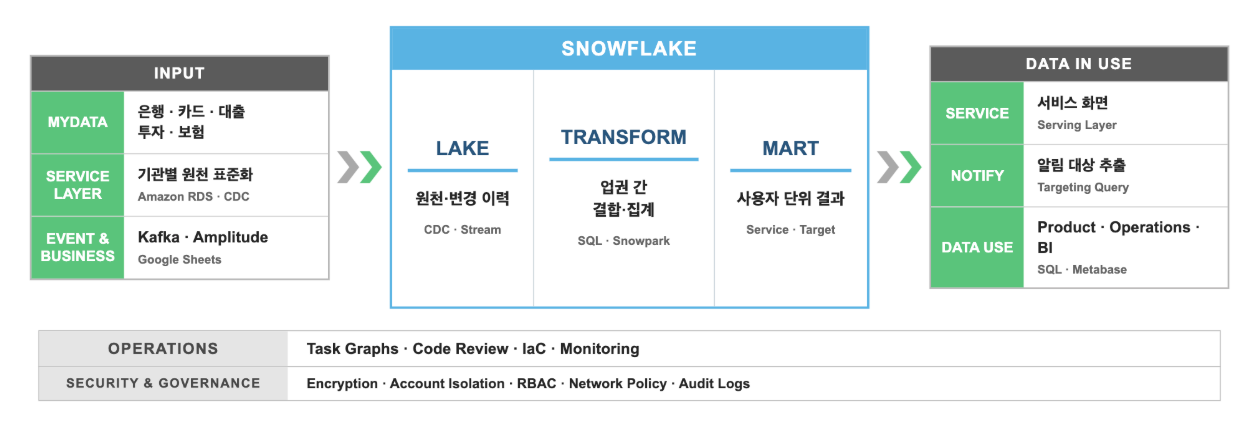
분석 데이터를 서비스로 직접 연결
사례 1. 실시간 값과 배치 값이 만나는 '내 자산 순위'
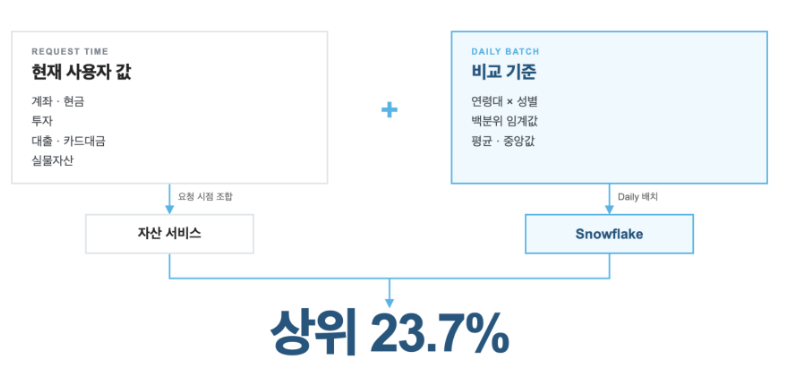
분석계 데이터를 서비스와 직접 연결한 대표 사례는 뱅크샐러드 앱의 '내 자산 순위' 기능입니다. 이 서비스는 요청 시 실시간으로 계산되는 '사용자 본인의 통합 자산'과, Snowflake에서 일배치로 미리 분석·정제해 둔 '그룹별 비교 기준(예: 30대 초반 상위 % 금액)' 데이터를 결합하여 최종 결과를 화면에 제공합니다.
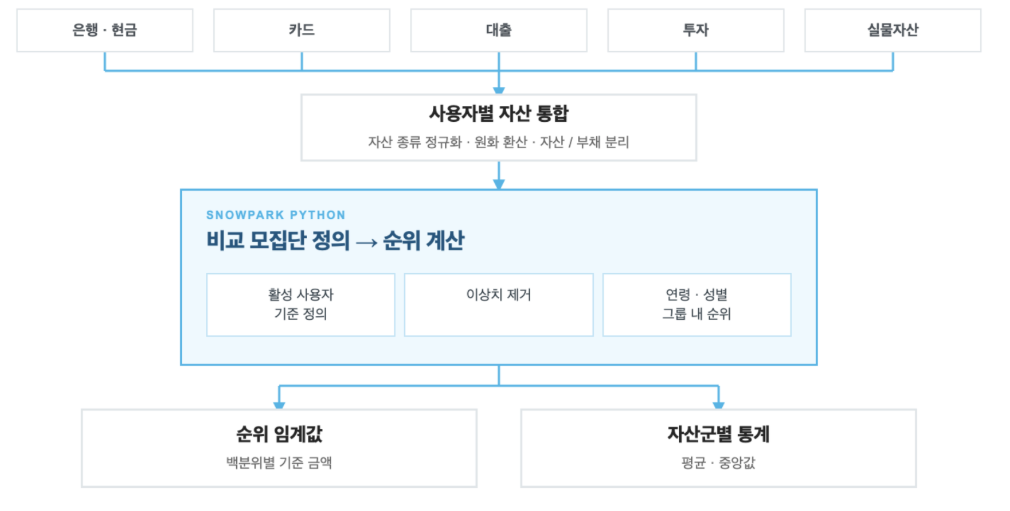
Snowflake는 은행, 카드, 대출, 투자, 실물 자산 등 다양한 업권 데이터를 정규화하고, 이상치 제거와 백분위 순위 산출 등 복잡한 파이썬 통계 연산(Snowpark)을 전담합니다. 과거 별도 Spark 클러스터로 적재하던 환경이 Snowflake 단일 파이프라인으로 일원화되면서 운영 공수가 크게 줄었습니다.
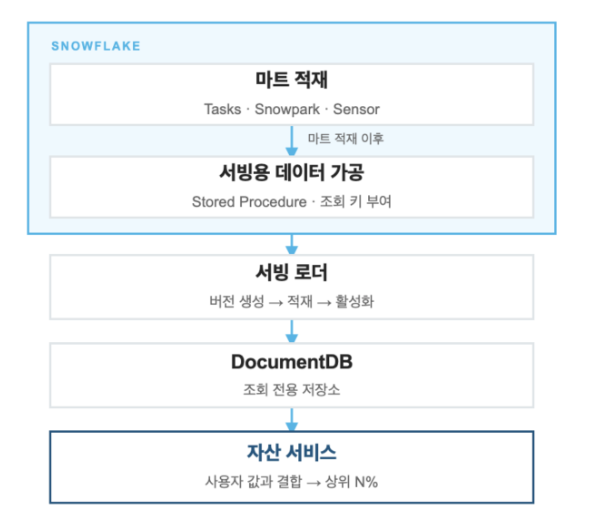
계산된 마트는 태스크 그래프와 스토어드 프로시저를 거쳐 서빙 레이어인 DocumentDB로 빠르게 적재되고, 자산 서비스가 실시간 자산값과 결합해 최종 화면을 완성합니다. 특히 각 단계는 이전 단계의 완료 여부를 확인하는 Sensor로 연결되어, 상위 배치가 지연되면 하위 단계가 대기하며 데이터 정합성을 보장합니다. 이로써 인프라 불안정성에서 비롯된 배치 지연 장애는 더 이상 발생하지 않으며, 이슈가 발생하더라도 원인을 추적해 즉시 개선할 수 있게 되었습니다.
사례 2. 쿼리 자체가 실행되는 '알림'
또 다른 사례인 알림은, 사전에 정의된 발송 조건을 권한이 부여된 담당자가 Snowsight에서 검증하면, 승인을 거친 쿼리가 그대로 알림 발송 워크플로우의 입력이 됩니다.
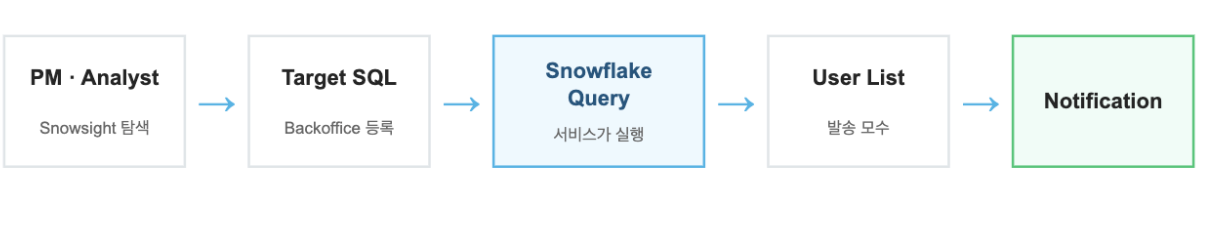
알림 발송 조건은 고객이 동의한 범위 내에서 사전에 정의됩니다. PM이나 분석가는 Snowsight, 즉 Snowflake의 조회 화면에서 해당 조건이 의도대로 동작하는지와 대상 규모를 검증합니다. 이렇게 검증한 대상 추출 쿼리를 뱅크샐러드 백오피스에 등록해 두면, 실제 알림을 발송하는 시점에 Snowflake가 등록된 쿼리를 직접 실행합니다. 핵심은 이 결과를 CSV 파일로 내려받아 쓰는 것이 아니라, 쿼리 자체가 그대로 알림 대상 추출에 사용된다는 점입니다. 분석 쿼리의 결과가 일회성 보고서로 끝나지 않고, 실제 고객 커뮤니케이션 워크플로우의 입력이 되는 구조로, 분석과 서비스가 같은 데이터 기반 위에서 이어지는 구조입니다. |
도입 효과: 비용 절감, 다운타임 0, 그리고 되찾은 시간
① 연간 데이터 비용 대폭 절감: 기존 AWS 기반 데이터 분석 환경과 비교해, 최근 1년간 Snowflake의 실제 운영 비용은 크게 절감되었습니다. 2023년 PoC 시점에 추정했던 63%와는 별개로, 도입 후 1년의 실제 운영 실적을 통해 확인한 수치입니다.
② 다운타임 0: 2024년 8월 전환 이후 Snowflake 계정의 수동 재실행이 일간 평균 0회로 유지되며, 이관 과정에서도 서비스 다운타임이 없었습니다. 이관 전 심한 날에는 하루 10번 넘게 발생하던 실패가 사실상 사라지면서, 엔지니어들이 반복적인 복구 대신 파이프라인 개선과 신규 데이터 활용에 시간을 쓸 수 있게 되었습니다.
③ 대표쿼리 응답 시간 4분에서 1분 미만으로: 분석가 인터뷰에 따르면, 기존 Spark 연결 환경에서 3~4분 걸리던 쿼리가 1분 미만으로 개선되었고, 10분 넘게 걸리던 BI 대시보드 로딩도 체감이 확연히 달라졌습니다.
거버넌스 위에서 시작하는 AI
Snowflake 기반 단일 데이터 인프라는 뱅크샐러드의 PFM, 금융 중개, 건강 서비스뿐만 아니라 코어 개발, 고객 응대, 대시보드, 고객 커뮤니케이션을 아우르는 전사 공통 계산 기반으로 안착했습니다.
특히 뱅크샐러드는 AI를 본격적으로 확장하기에 앞서 신뢰할 수 있는 데이터 거버넌스 체계를 다지는 데 집중했습니다. AI 모델 도입 전 어떤 데이터를 참조해야 하는지 명확히 정의하고, 사용자 및 역할별 접근 범위를 엄격히 제어하며, 생성된 결과의 출처와 이력을 추적할 수 있는 기반을 구축했습니다. 여기에 AI 지속 활용에 따른 비용 통제 체계까지 완성함으로써, 안심하고 활용할 수 있는 높은 신뢰도의 데이터 인프라를 마련했습니다.
이제 뱅크샐러드는 Snowflake AI 기능의 PoC를 검증하고 있습니다. 탄탄한 거버넌스 기반 위에서 사내 구성원들이 필요한 데이터를 보다 직관적으로 탐색·이해·활용할 수 있도록 AI 활용의 범위를 넓혀갈 계획입니다.

저희에게 필요했던 것은 작은 팀이 반복 복구에서 벗어나 안정적으로 다음 활용을 만들 수 있는 기반이었습니다. 신뢰할 수 있는 기반 위에서, 데이터의 가능성을 계속 쌓아가고 있습니다.
뱅크샐러드 AI Data Platform팀


