10 de set. de 2026/Leitura: 8 minEstratégia e insights
Engenharia de dados autônoma: 5 estágios para uma verdadeira maturidade com agentes de IA
O trabalho de engenharia de dados é difícil: deparar-se com execuções com falhas que levam horas para investigar, precisar lidar com um backlog constante de pedidos e necessidades das equipes de negócios e ainda responder às equipes financeiras que querem saber por que o custo de todos esses pipelines não para de subir. E, de muitas formas, a IA está tornando isso ainda mais difícil, trazendo tipos de dados mais numerosos e variados e permitindo que muito mais pessoas na empresa usem esses dados por meio de agentes de codificação e chat capazes de escrever SQL para elas. A maioria das equipes de engenharia de dados está tentando se manter atualizada adotando seus próprios agentes de codificação, mas, ainda assim, parecem ficar cada vez mais para trás.
Um relatório da MIT Technology Review intitulado "Redefining Data Engineering in the Age of AI" constatou que, apesar de 8 em cada 10 organizações já terem implementado ferramentas de engenharia de dados baseadas em IA, os engenheiros de dados por sua vez estão lidando com mais complexidade, sendo o maior desafio relatado garantir a segurança e a privacidade dos dados (55%).
Precisamos de uma mudança mais radical. Em vez de recorrer à IA para tornar os processos existentes mais rápidos, é hora de repensar os próprios processos e deixar para trás a construção e manutenção manual de pipelines. Com isso, as equipes de dados terão mais tempo para se concentrar no resultado da engenharia de dados, os produtos de dados, em vez do processo de transformar esses dados brutos passo a passo. É necessário que as equipes garantam que os dados estejam prontos para consumo tanto pelas pessoas quanto pela IA, com o contexto e a governança preservados.
O futuro da engenharia de dados vai depender da criação de produtos de dados reais e utilizáveis, capazes de auxiliar as decisões de negócios, além de contar com agentes de IA verdadeiramente autônomos para construir, preservar e otimizar tudo o que for necessário para manter esses produtos atualizados, tendo as pessoas como os principais árbitros e responsáveis pelas decisões.
Esses agentes de IA ficarão atentos a novos produtos necessários, a problemas e falhas nos já existentes, e vão buscar oportunidades de melhoria, limpeza e otimização.
Por sua vez, as pessoas, claro, continuarão sendo fundamentais, mas seu papel será elevado, tais como: definir os problemas de negócios mais importantes, orientar os agentes sobre a arquitetura geral correta e garantir que o contexto do negócio seja capturado de forma adequada para os agentes que consomem os produtos de dados.
Empregos "profissionalizados" pela IA estão crescendo duas vezes mais rápido do que empregos "democratizados" pela IA, com aumento de salário 42% mais rápido desde 2021.
Fonte: PwC AI Jobs Barometer 2026
A jornada rumo à engenharia de dados autônoma
Trata-se de uma grande mudança, e as equipes não conseguirão chegar lá da noite para o dia, nem deveriam. Uma abordagem melhor é decidir que esse é o objetivo certo e, então, avançar em direção a ele de forma incremental e ponderada. A cada etapa, as equipes vão aprender mais sobre o que os agentes e os modelos são capazes de fazer, além de ganhar confiança sobre quanto pode ser automatizado com segurança e onde são necessárias verificações adicionais com trabalho humano no circuito (human in the loop, HITL), ferramentas ou processos. Muitas empresas já estão avançando nesse caminho: toda equipe que adotou um ciclo de vida definido por software, controle de versão, pipelines declarativos ou desenvolvimento assistido por IA já deu um passo em direção ao futuro.
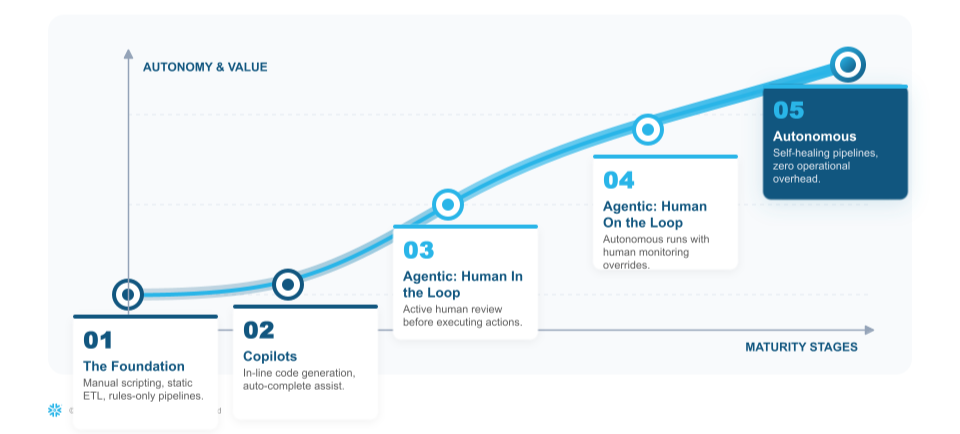
Curva de maturidade da engenharia de dados autônoma
| Estágio 1: a base |
Neste estágio, os engenheiros de dados constroem e mantêm pipelines manualmente. Toda alteração de esquema, decisão de orquestração e resposta a falhas exige esforço humano. As equipes que tratam o estágio 1 como o momento de acertar as bases de engenharia terão mais sucesso nos estágios seguintes. A migração para práticas mais modernas de engenharia de dados, como pipelines declarativos, pode gerar ganhos de eficiência. A Travelpass, por exemplo, tornou seus esforços de engenharia de dados mais acessíveis, o que ajudou a equipe a ajustar a escala e a fornecer dados às unidades de negócios com mais de 350% de eficiência. |
| Estágio 2: copilotos |
É a fase de integração da IA ao editor. O autocomplete e a geração de código inline reduzem o atrito da transformação e da configuração, mas os engenheiros continuam responsáveis por toda decisão. A essência do fluxo de trabalho não mudou, mesmo com o aumento da produtividade. |
| Estágio 3: agente de IA: trabalho humano incluído no circuito |
O estágio 3 é onde a IA começa a se tornar uma colaboradora. Os agentes podem propor mudanças, como modificações em pipelines, correções de falhas e migrações de esquema, mas nada é executado sem a aprovação explícita de um profissional. Os engenheiros revisam o código em vez de escrevê-lo, o que ajuda a reduzir drasticamente o tempo de resposta a incidentes. |
| Estágio 4: agente de IA: supervisão humana incluída no circuito |
É nesse ponto que os benefícios da automação realmente começam a se destacar. Os agentes atuam de forma independente em tarefas selecionadas e claramente definidas, como detectar anomalias e adaptar pipelines a mudanças upstream, sem esperar por aprovação. Os engenheiros continuam tendo observabilidade sobre o que os agentes estão fazendo e podem substituir as ações deles quando necessário. |
Estágio 5: |
No estágio 5, a engenharia de dados consegue transformar, por completo, o que significa trabalhar com dados. Os pipelines detectam suas próprias falhas, identificam a causa raiz dos problemas em todo o stack, implementam correções, validam os resultados e documentam o que mudou, sem intervenção humana. A sobrecarga operacional se aproxima de zero. Os engenheiros de dados definem as políticas, os padrões e a semântica de negócios. Eles também decidem o que a plataforma pode fazer de forma autônoma e o que requer seu julgamento, de modo que mudanças de alto impacto sejam direcionadas para revisão humana. Seu papel passa totalmente da execução para a governança, e eles deixam de ser construtores de pipelines para se tornarem verdadeiros parceiros de negócios. |

“Foi revolucionário poder realizar todas as tarefas usando somente a plataforma Snowflake. Hoje, se pensamos em algo na quinta-feira, até a terça seguinte já está em produção."
Thomas Bodenski
COO & Chief Data & Analytics Officer, TS Imagine
Redefinindo a construção dos produtos de dados na era dos agentes de IA
Uma das grandes mudanças que viabiliza isso é deixar de encarar dados como pipelines e passar a encará-los como produtos de dados, que abrangem não apenas os dados, mas também semântica, qualidade e tudo o que um agente precisa para conseguir realizar suas tarefas com esses dados. Por exemplo, um produto de dados de fidelidade de clientes pode incluir dados de risco de rotatividade de clientes, que combinam os dados de atividade de cada conta individual com uma visão semântica que define o que a empresa considera como "em risco", além de verificações de qualidade documentadas. Assim, qualquer agente ou analista que acessar esse produto de dados obtém uma resposta consistente e confiável para suas iniciativas de fidelidade de clientes.
O modelo tradicional parte da infraestrutura e vai construindo a partir dela: cria a base de dados, define esquemas, cria pipelines e, só então, atende a uma necessidade de negócio. Isso funcionava quando os produtos de dados eram poucos e estáveis.
As equipes de dados modernas estão fazendo o processo inverso: começam pelo problema de negócio e identificam o fluxo de trabalho do agente que o resolve. Determinam que dados esse agente precisa e constroem o produto de dados para entregá-los. Isso reorienta o data estate em torno de resultados de negócio, em vez de camadas técnicas, e traz um modelo vertical para produtos de dados, no qual os pipelines são projetados para resultados, não para esquemas.
Em uma verdadeira engenharia de dados autônoma, a plataforma é tão importante quanto a escolha da estrutura de trabalho com agentes. Equipes de alta performance precisam primeiro consolidar o controle de versão, os testes automatizados e os pipelines de CI/CD, as mesmas práticas recomendadas que equipes de dados de alta performance vêm adotando há anos. Governança, interoperabilidade e dados unificados são as pré-condições que tornam seguro confiar em fluxos de trabalho autônomos.
Construa a base e a engenharia de dados autônoma virá a seguir
A mudança para a engenharia de dados autônoma é uma necessidade operacional. As equipes que alcançam a maturidade mais rápido não vão chegar lá por terem os melhores modelos. Elas vão chegar lá porque elevaram o papel do engenheiro de dados a parceiro de negócios e construíram uma base sólida o suficiente para que agentes autônomos possam operar, com uma governança robusta o suficiente para que sejam confiáveis.
Para ter sucesso nessa jornada, os clientes precisam apostar em uma plataforma que não apenas atenda às suas necessidades atuais, mas que continue evoluindo e absorvendo novas inovações tanto em engenharia de dados quanto em IA, sem que seja necessário integrar ou construir tudo por conta própria. Entenda como a Snowflake está adotando o data-eng-benchmark para definir o padrão de medida da qualidade e da eficiência de tokens no trabalho de engenharia de dados autônoma.
Para um guia prático de como começar a trabalhar com a engenharia de dados autônoma, incluindo padrões de arquitetura, estruturas de governança e as práticas de engenharia que tornam os fluxos de trabalho confiáveis com agentes de IA, leia Crie pipelines para IA: um guia essencial para uma engenharia de dados mais inteligente (EN).
4 de fev. de 2026Produto e tecnologia
Snowflake adquire a TensorStax para acelerar a IA com agentes na engenharia de dados

4 de set. de 2026IA ML
Build Reproducible Data Pipelines with CoCo, Snowflake's AI Coding Agent
18 de mar. de 2026Produto e tecnologia
