
3 nov. 2026/Lecture : 10 minIA et ML
Maîtrisez votre intelligence avec Cortex Training
Chaque application d’IA en production génère des millions de données précieuses sur votre activité, notamment les préférences des clients, les habitudes d’utilisation et les résultats obtenus. Pourtant, la plupart des entreprises ne les exploitent jamais. Beaucoup choisissent par défaut de créer des agents à partir de modèles de fondation fermés, qui peuvent être coûteux et ne pas comprendre tous les petits détails de votre activité. Alors que les modèles à poids ouverts rivalisent de plus en plus avec les modèles de pointe, les entreprises peuvent personnaliser l’IA à partir de leurs propres données et de leur contexte. Jusqu’à présent, cette démarche exigeait toutefois de gérer une infrastructure GPU complexe et coûteuse, ou de s’appuyer sur des API managées offrant peu de flexibilité et de contrôle.
Nous sommes ravis d’annoncer aujourd’hui la public preview de Cortex Training, l’offre serverless de Snowflake qui permet de personnaliser et de déployer des LLM à poids ouverts. Avec Cortex Training, les équipes peuvent utiliser leurs frameworks d’entraînement habituels ou créer des boucles d’entraînement avancées et sur mesure à l’aide d’API serverless de bas niveau, le tout sans avoir à gérer les complexités liées au provisionnement des GPU, à la planification, aux checkpoints et à l’exécution distribuée.
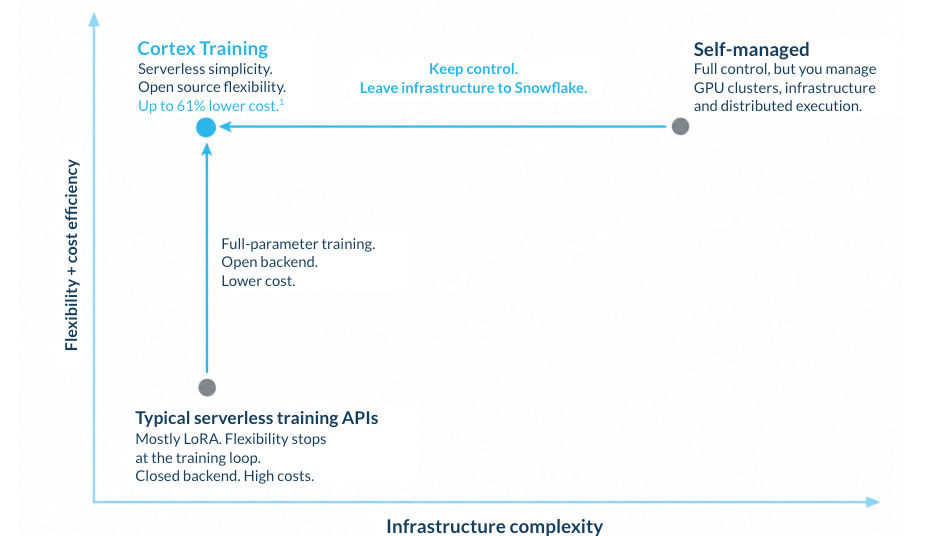
Cortex Training repose sur un backend open source hautement personnalisable et optimisé. Il offre la flexibilité et l’efficacité d’un cluster d’entraînement bare metal complexe et autogéré, avec la simplicité d’une expérience serverless. Nos benchmarks montrent des coûts jusqu’à 61 % inférieurs à ceux des offres serverless concurrentes,[1] si bien que les équipes n’ont plus à choisir entre simplicité, flexibilité et maîtrise des coûts pour personnaliser et déployer leurs modèles.
Avec Cortex Training, les équipes peuvent exploiter la plateforme data intégrée de Snowflake pour préparer facilement des jeux de données prêts pour l’entraînement et capturer les traces et les logs des agents. Elles créent ainsi une boucle de feedback qui alimente la personnalisation et l’amélioration des modèles.
Pourquoi les entreprises ont besoin du post-entraînement
Les modèles à poids ouverts prêts à l’emploi sont généralistes par défaut. Le post-entraînement permet toutefois de les optimiser pour le domaine, les données propriétaires, les cas d’usage et le budget propres à chaque entreprise. Les méthodes de post-entraînement comme le SFT et le RL apprennent aux LLM à adopter le comportement attendu et à prendre des décisions plus précises et plus rentables en tenant compte du contexte propre à votre organisation.
Le SFT apprend aux modèles à adopter le comportement attendu. À partir d’exemples de qualité, les entreprises peuvent apprendre à un agent de service client à diagnostiquer les problèmes, à communiquer avec les clients, à appliquer les politiques d’escalade et à suivre des schémas éprouvés d’appel d’outils et de workflows. Au lieu de s’appuyer sur des prompts qui détaillent chaque étape, le modèle apprend, grâce aux interactions réussies, comment l’entreprise souhaite que le travail soit effectué.
Le RL apprend aux modèles à prendre de meilleures décisions pour atteindre les résultats visés. Contrairement au SFT, qui apprend à partir de démonstrations, le RL optimise le comportement grâce au feedback sur des résultats mesurables, comme la résolution des problèmes, la conformité aux politiques, la latence et les coûts. Par exemple, un agent de service client peut apprendre quand solliciter un système de gestion des tickets, appeler une API de facturation ou transmettre le dossier à une personne. En tirant les enseignements du feedback recueilli sur de nombreuses trajectoires d’interaction, il peut découvrir des moyens plus efficaces d’accomplir ses tâches. Il évite ainsi les appels d’outils et les étapes superflus, tout en trouvant le juste équilibre entre qualité, rapidité et coûts.
Découvrez Cortex Training
Cortex Training est l’offre serverless de Snowflake conçue pour créer et déployer des modèles à poids ouverts personnalisés. Les équipes d’IA conservent un contrôle précis sur le SFT, le RL et les boucles d’entraînement sur mesure, tandis que Snowflake gère l’infrastructure GPU. Les développeurs peuvent ainsi se concentrer sur l’amélioration des modèles plutôt que sur l’exploitation des clusters.
Cortex Training repose sur un backend open source hautement personnalisable et optimisé. Il offre la flexibilité et l’efficacité de déploiements bare metal complexes et autogérés, avec la simplicité d’une expérience serverless. Il prend en charge un large éventail de familles de modèles à poids ouverts, le fine-tuning supervisé (SFT) et l’apprentissage par renforcement (RL) avec un entraînement de tous les paramètres ou LoRA, ainsi que l’orchestration via des frameworks open source populaires comme SkyRL, Hugging Face TRL et veRL.
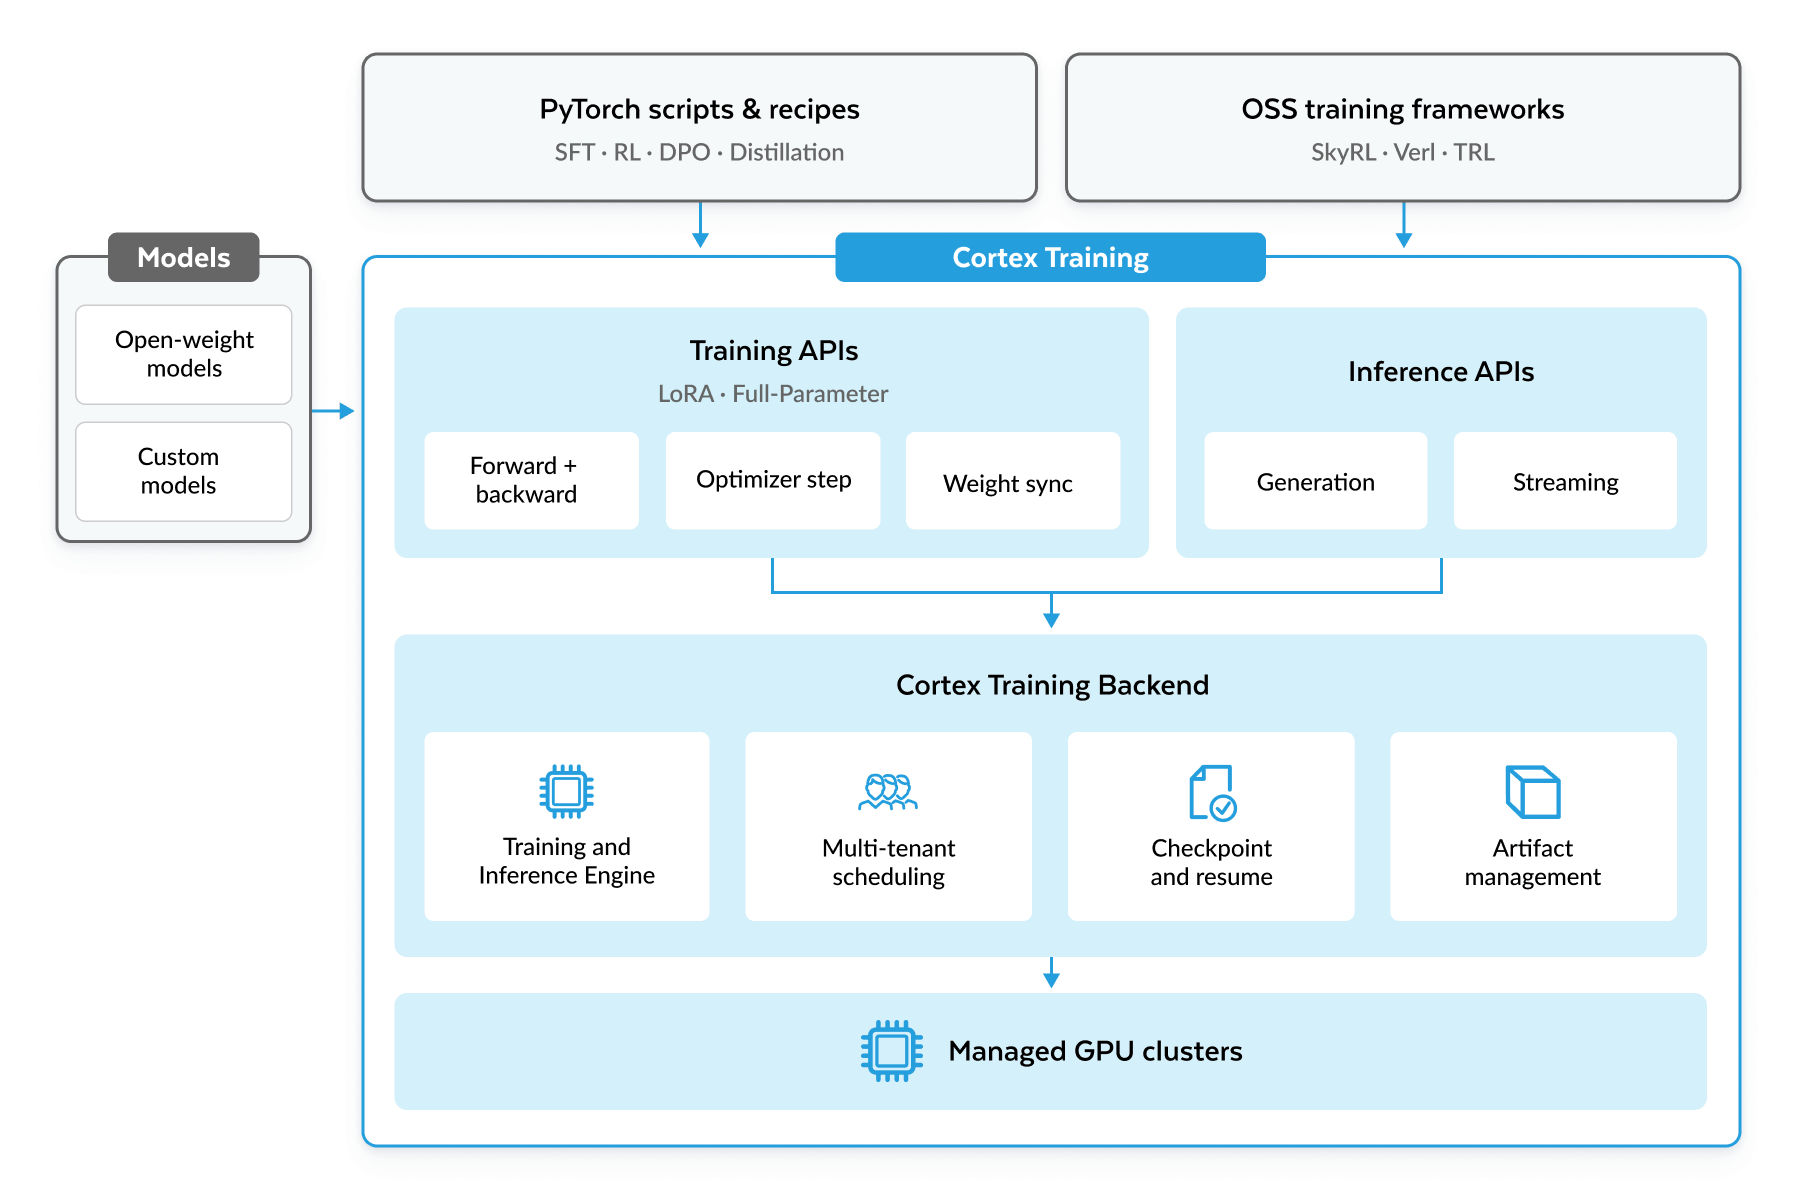
La plateforme couvre l’ensemble du cycle de vie des modèles : évaluez les principaux modèles à poids ouverts, personnalisez-les avec des frameworks d’entraînement populaires ou des API d’entraînement serverless de bas niveau, évaluez et comparez les checkpoints, puis déployez-les via des points de terminaison d’inférence compatibles avec OpenAI. Vous créez ainsi un cercle vertueux continu, dans lequel les données de production et le feedback donnent naissance à des modèles toujours plus performants et spécialisés.
Cortex Training étend les contrôles de gouvernance de Snowflake à l’ensemble du cycle de vie des modèles. Les contrôles d’accès basés sur les rôles gouvernent les données d’entraînement, l’entraînement des modèles, le déploiement et l’inférence. Les données, les poids des modèles et l’état de l’optimiseur restent dans l’environnement managé de Snowflake.

Chez ResolveAI, nous améliorons la fiabilité des logiciels en plaçant des agents SRE fondés sur l’IA au cœur des opérations critiques, tout en assumant la responsabilité des résultats. Pour créer des SRE aux capacités surhumaines, capables d’analyser et de résoudre de manière autonome les incidents de production, nous devons les entraîner sur des tâches de longue durée. Ces entraînements mobilisent des centaines, voire plus d’un millier de GPU. Grâce aux API serverless de Cortex Training, nous pouvons travailler à cette échelle sans avoir à gérer l’infrastructure sous-jacente ni à optimiser les clusters. L’expertise système des équipes Snowflake complète également nos travaux de recherche en IA. Nous pouvons ainsi innover rapidement et améliorer nos modèles de manière itérative jusqu’à atteindre nos objectifs de performance. »
Sean Bell
Research Lead, ResolveAI
Concentrez-vous sur les modèles, pas sur l’infrastructure GPU
Cortex Training fournit des API serverless qui permettent aux équipes de se concentrer sur la logique d’entraînement plutôt que sur le provisionnement et l’exploitation de l’infrastructure GPU.
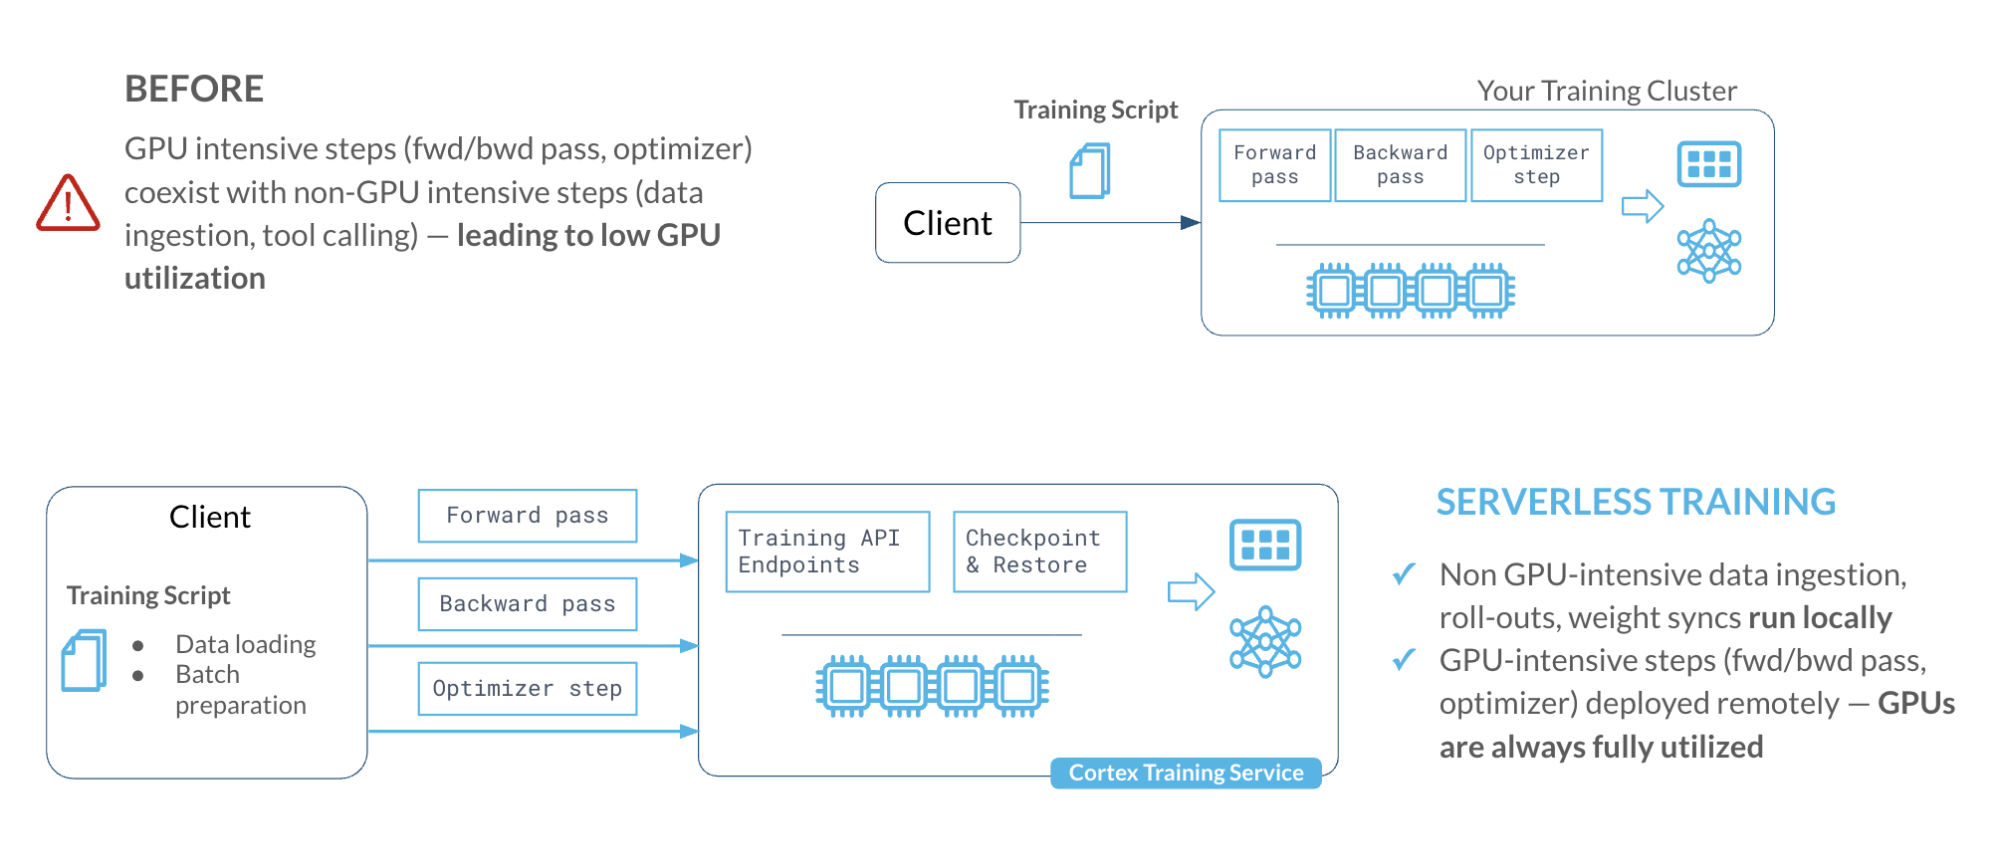
Votre script d’entraînement contrôle la boucle d’entraînement, tandis que les API Cortex Training prennent en charge les opérations intensives sur GPU, comme les passes avant et arrière, les étapes d’optimisation, la synchronisation des poids et la génération. Vous définissez comment le modèle apprend ; Snowflake gère les GPU, l’exécution distribuée, l’état du modèle et les checkpoints.
Enclenchez le cercle vertueux de l’amélioration des modèles
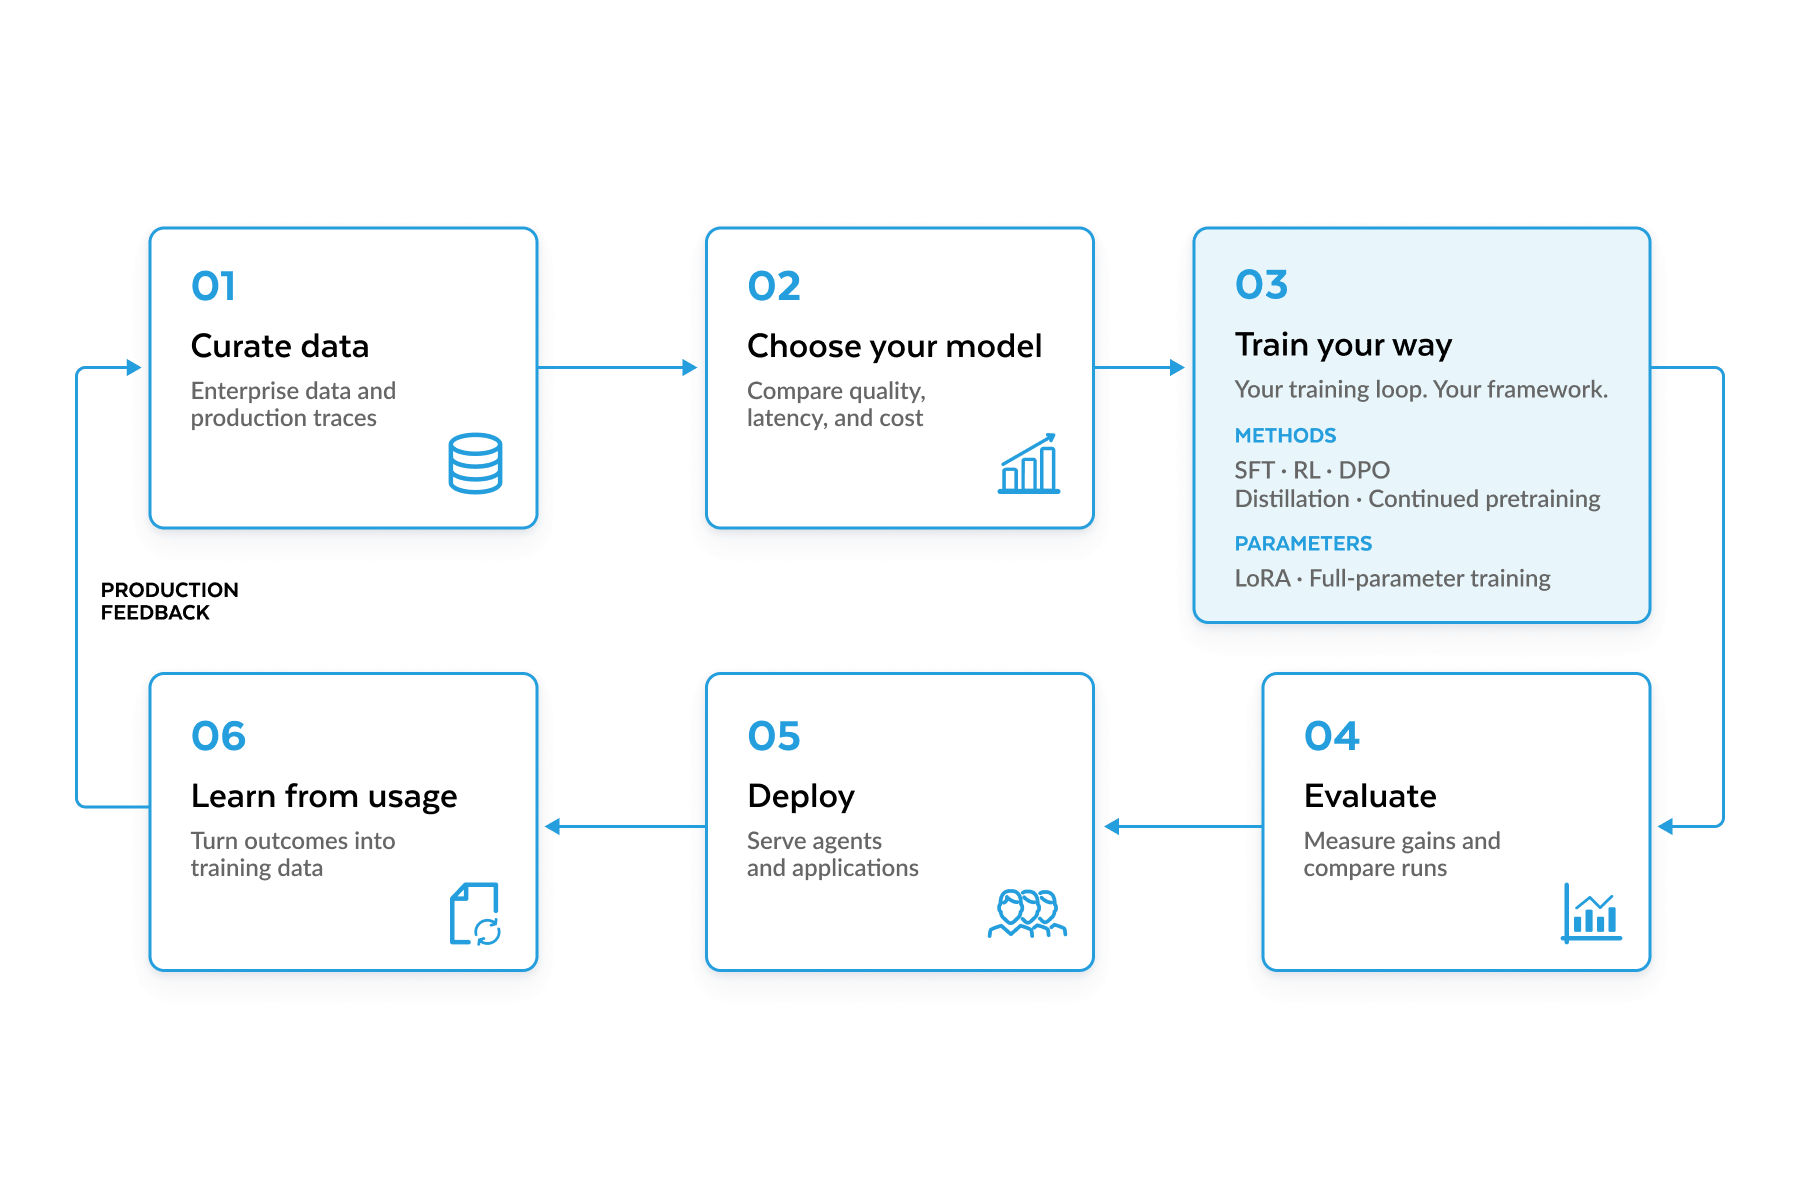
Snowflake crée un cercle vertueux d’amélioration des modèles : capture des traces et des logs des agents en production, préparation des données d’entraînement, personnalisation des modèles à poids ouverts selon les besoins propres à l’entreprise, puis déploiement pour répondre aux besoins d’inférence.
Préparez vos données
Une personnalisation réussie des modèles commence par des données d’entraînement de qualité. La plateforme data de Snowflake permet aux équipes de nettoyer, filtrer, enrichir et étiqueter les données d’entreprise, structurées comme non structurées, afin de créer des jeux de données prêts pour l’entraînement avec les Fonctions Cortex AI, SQL et Snowpark. Cortex AI Gateway aide à boucler la boucle de feedback entre les agents en production et l’entraînement des modèles. Les équipes peuvent capturer les traces et les logs des agents, ainsi que les interactions avec les modèles, afin de comprendre le comportement des agents et de repérer les possibilités d’amélioration. En associant ces signaux aux résultats des applications et au feedback humain, les équipes peuvent préparer des jeux de données d’entraînement à forte valeur ajoutée pour le SFT, l’optimisation des préférences et le RL. L’expérience concrète des agents alimente ainsi l’amélioration continue des modèles.
Comparez et évaluez le bon modèle à poids ouverts
Commencez par tester des modèles à poids ouverts sur votre charge de travail avant d’investir dans leur personnalisation. Comparez les candidats selon les critères qui comptent pour votre application : qualité, latence et coûts. Cortex Training propose un riche catalogue de modèles à poids ouverts, notamment les familles Qwen, GLM, Nemotron, Gemma et DeepSeek, avec une inférence en batch et en streaming qui facilite leur comparaison.
Chez OpenHands, nous utilisons régulièrement l’apprentissage par renforcement pour entraîner les modèles de notre agent à réaliser des tâches de développement lorsqu’un utilisateur lui indique des fichiers ou des fonctions. Auparavant, nous devions gérer notre propre cluster d’entraînement et passions des jours, voire des semaines, à l’administrer et à résoudre les problèmes. Avec Snowflake Cortex Training, nous pouvons consacrer tout notre temps aux expérimentations et à l’entraînement. Et surtout, nous n’avons eu ni à changer nos frameworks de prédilection ni à faire de compromis sur la flexibilité. »
Jeff Ma and Parinthapat Pengpun
Researchers, OpenHands
Entraînez et personnalisez le modèle à votre façon
Une fois le bon modèle de base sélectionné, adaptez-le avec la stratégie d’entraînement la mieux adaptée à votre tâche. Cortex Training prend en charge des modèles à poids ouverts de pointe, notamment Qwen, Nemotron, Gemma et DeepSeek, dans différentes tailles de paramètres. Les équipes peuvent utiliser LoRA ou l’entraînement de tous les paramètres pour le SFT, le RL, l’optimisation directe des préférences, la distillation, la poursuite du pré-entraînement et l’entraînement intermédiaire.
Cortex Training s’intègre aux frameworks de post-entraînement populaires comme Hugging Face TRL, PrimeRL, veRL et SkyRL. Les équipes qui les utilisent déjà peuvent donc démarrer rapidement. La solution s’intègre également à des plateformes d’agents comme OpenHands pour entraîner les modèles et l’intégralité des environnements d’exécution des agents. Au-delà de ces intégrations, les API serverless permettent aux agents de piloter la personnalisation des modèles pour les charges de travail d’entreprise. Elles réduisent la complexité de l’entraînement et rendent la personnalisation accessible sans expertise spécialisée en IA.
Pour gagner en contrôle, les équipes ML avancées peuvent utiliser des API de plus bas niveau afin de définir des fonctions de perte, des architectures de modèles et des boucles d’entraînement sur mesure. Par exemple, Cortex Training fournit des API pour générer des rollouts, c’est-à-dire des réponses de modèles ou des interactions d’agents, mettre à jour les poids des modèles et synchroniser ces poids dans l’ensemble du système. Ces composants permettent de créer des workflows de RL qui génèrent des comportements de façon répétée, évaluent les résultats et les exploitent pour améliorer progressivement le modèle.
Cette flexibilité s’étend à l’infrastructure sous-jacente. Cortex Training, sur Arctic Platform, repose sur un backend open source qui offre aux utilisateurs une visibilité complète sur le code exécuté par les GPU. Les équipes avancées peuvent proposer des PR et intégrer les nouvelles techniques et innovations de la communauté IA/ML à leurs charges de travail d’entraînement.
Consultez nos exemples Cortex Training pour découvrir l’ensemble des recettes, intégrations et compétences disponibles.
Au sein de l’équipe de modélisation de Snowflake AI Research, nous développons nos agents d’ingénierie logicielle, dont Arctic-SWE, avec prime-rl et Cortex Training comme backend. Nous pouvons ainsi concevoir librement nos propres frameworks algorithmiques et méthodes d’entraînement sur des GPU serverless. Nous bénéficions de la dynamique d’entraînement nécessaire pour atteindre des performances de pointe en ingénierie logicielle, sans avoir à gérer le cluster. »
Boyi Liu
Senior Research Scientist, Snowflake AI Research
Évaluez et améliorez
L’entraînement n’a de valeur que si le nouveau modèle est manifestement plus performant. Cortex Training permet aux équipes de charger des checkpoints entraînés pour l’inférence en batch ou de les déployer derrière des points de terminaison afin d’évaluer et de tester les applications. Vous pouvez utiliser Snowflake ML Experiments pour suivre les exécutions d’entraînement, consigner des métriques personnalisées, observer les performances et comparer les exécutions entre plusieurs expériences. Vous gardez ainsi un contrôle total sur les données capturées, sans dépendre d’une journalisation automatique. Les checkpoints sont conservés côté serveur afin que les équipes puissent reprendre l’entraînement ou lancer de nouvelles expériences à partir de checkpoints antérieurs.
Déployez vos modèles dans les agents et les applications
Une fois les objectifs de qualité et de coûts atteints, les équipes peuvent déployer le modèle pour l’inférence.
Cortex Training prend en charge des points de terminaison d’inférence compatibles avec OpenAI et adossés à des GPU dédiés, notamment l’inférence en streaming pour les applications interactives et les agents, ainsi que l’inférence en batch pour les besoins non interactifs.
Le cycle recommence ensuite lorsque les applications en production génèrent de nouvelles trajectoires, évaluations et de nouveaux résultats : comparer → entraîner → générer des rollouts → évaluer → déployer et servir → apprendre de la production → entraîner à nouveau. Grâce à cette boucle, les données d’entreprise et l’expérience acquise par les applications donnent naissance à des modèles toujours plus performants et spécialisés.
Une base ouverte pour optimiser les coûts
Cortex Training fournit des configurations optimisées prêtes à l’emploi. Les équipes avancées peuvent toutefois les ajuster à des charges de travail précises ou contribuer à leur amélioration en amont. L’utilisation étant facturée en fonction du temps GPU, un entraînement plus rapide réduit directement les coûts.
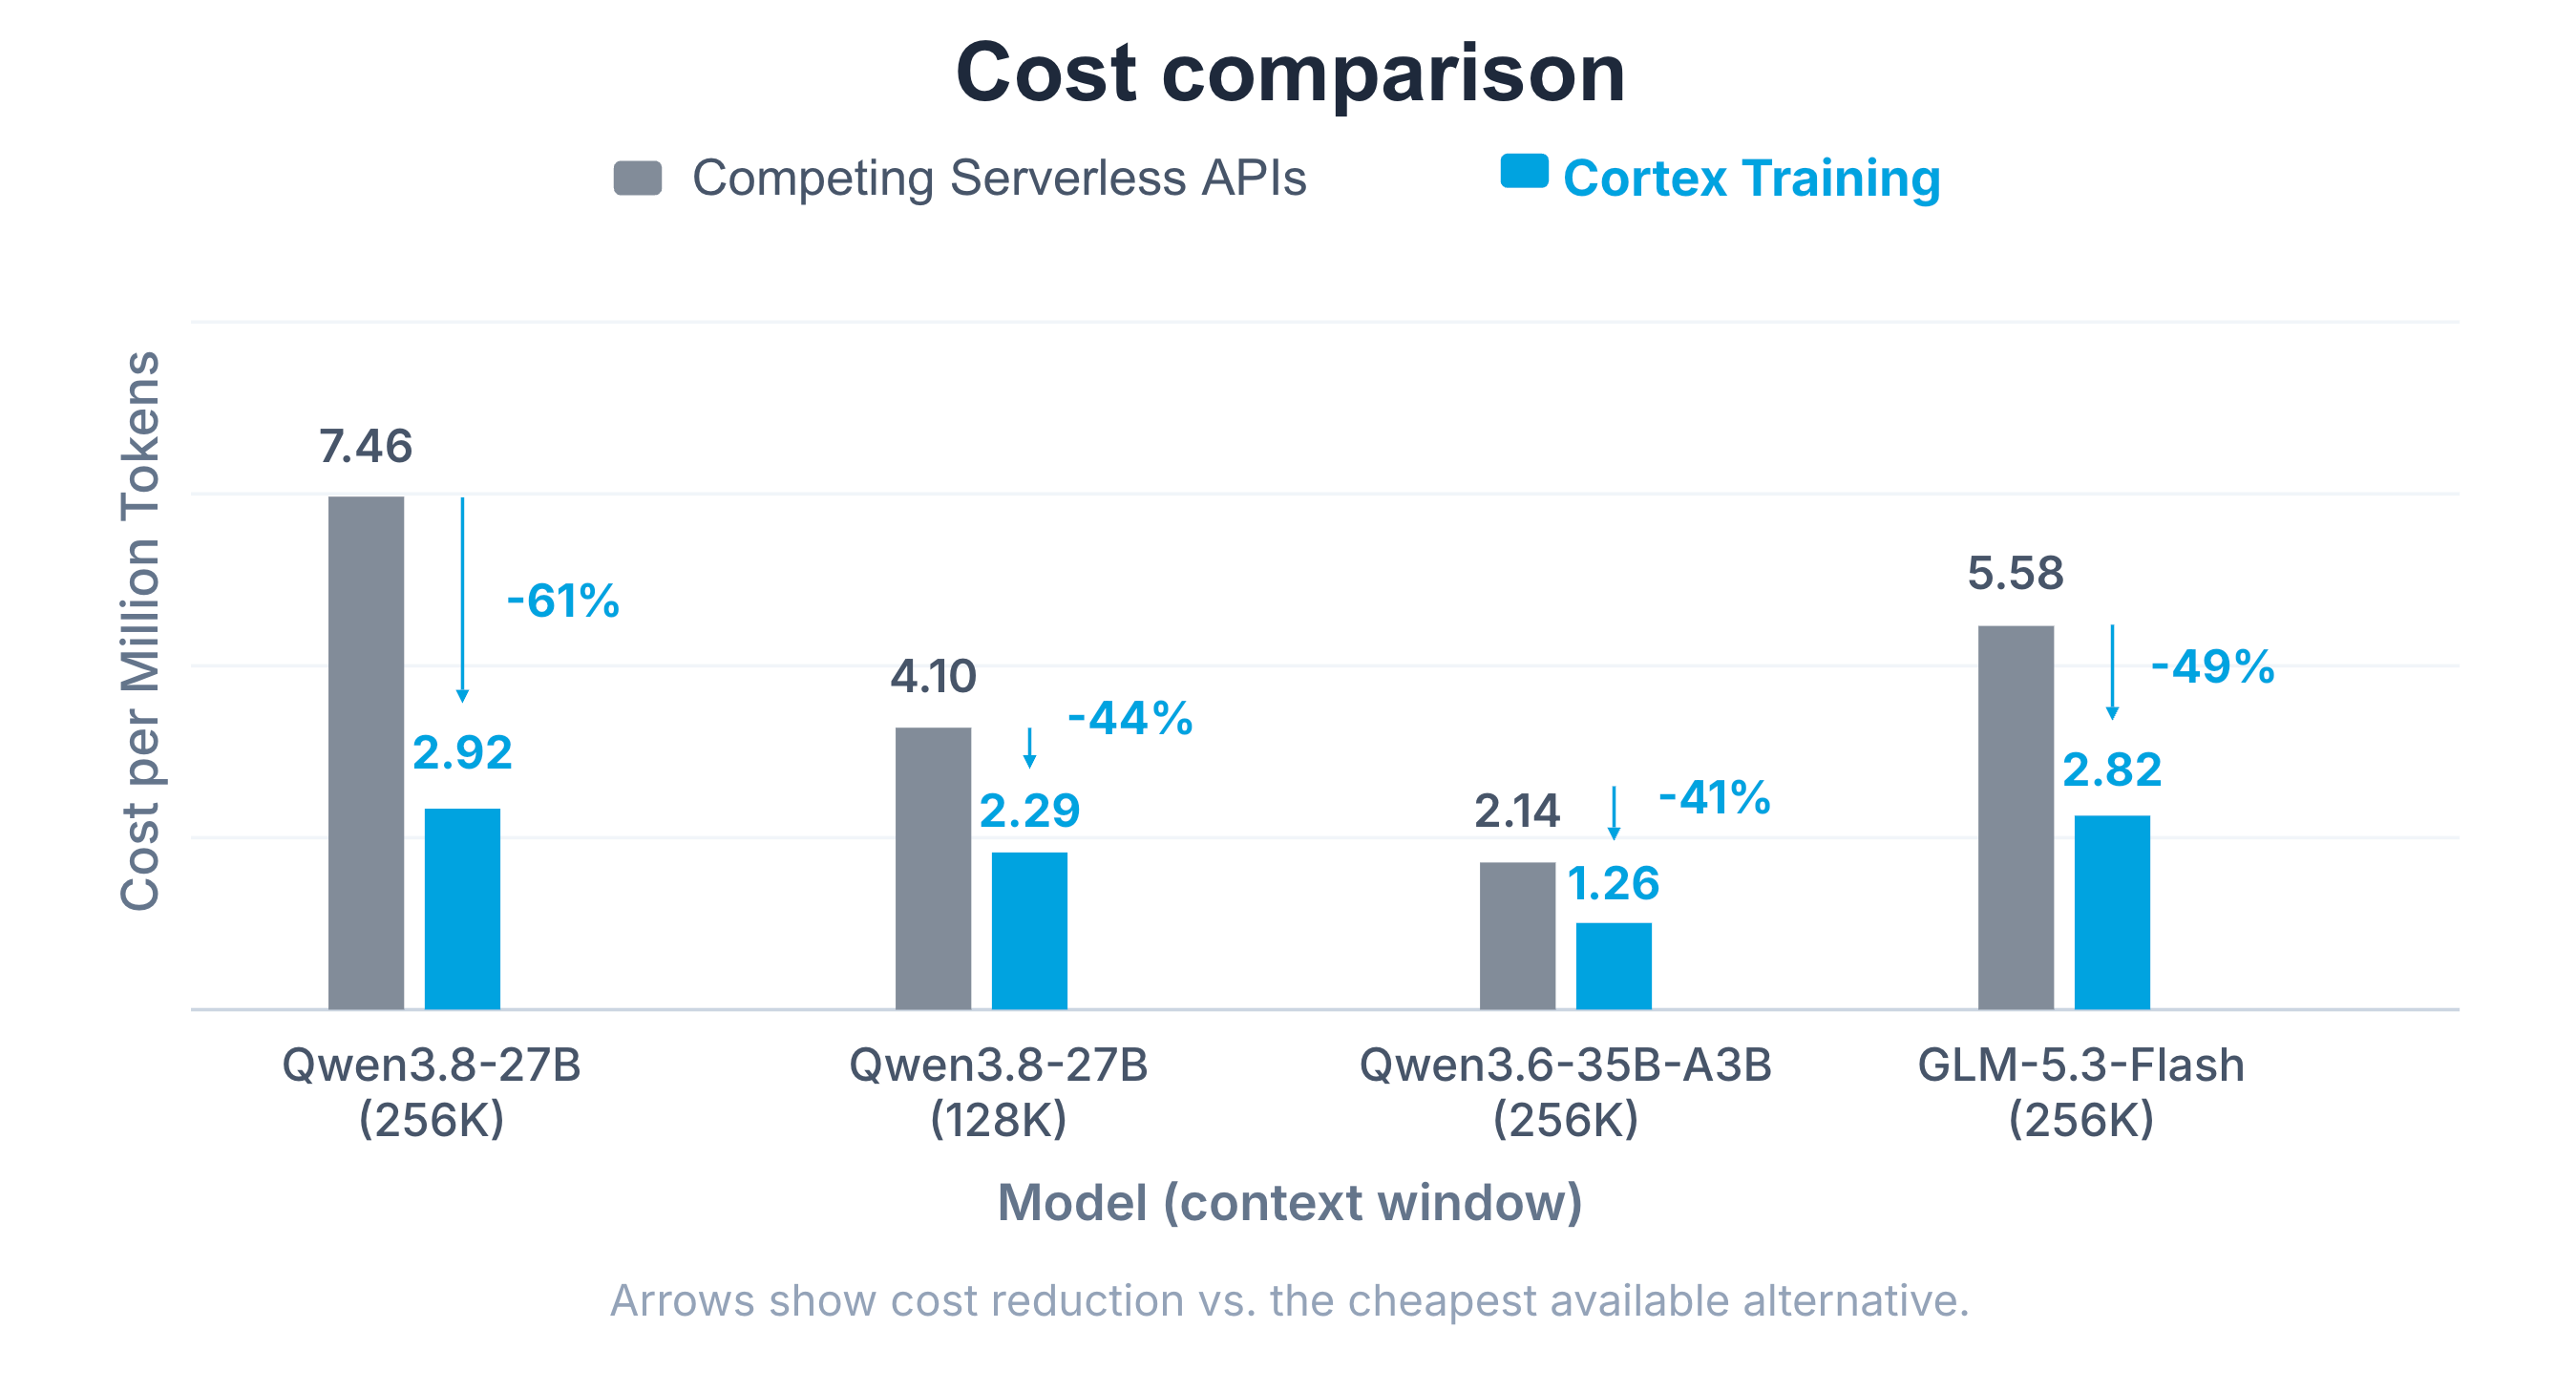
Par rapport aux autres API d’entraînement serverless, Cortex Training offre une excellente maîtrise des coûts pour l’entraînement LoRA. Selon nos benchmarks, Cortex Training coûte jusqu’à 61 % moins cher que les produits d’API d’entraînement serverless concurrents, notamment Tinker.[1]
Poetiq développe l’optimiseur le plus puissant au monde grâce à sa propre approche d’auto-amélioration récursive. Avec Snowflake, nous avons commencé le post-entraînement du premier LLM au monde spécialisé dans l’optimisation. Cortex Training nous offre la simplicité d’utilisation et la flexibilité nécessaires pour répondre à tous nos besoins, de LoRA au SFT, jusqu’au post-entraînement de l’ensemble des paramètres avec notre propre implémentation de GRPO. »
Ian Fischer
Co-CEO, Poetiq
Lancez-vous dans le post-entraînement des LLM
- Pour vous aider à démarrer, nous avons créé ce notebook de démarrage rapide simple d’utilisation, qui s’exécute entièrement dans votre compte Snowflake existant.
- Consultez le référentiel de démarrage ou choisissez l’une de ces recettes prêtes à l’emploi.
- Pour en savoir plus sur Cortex Training, consultez la documentation ou visitez la page web.
- Contactez l’équipe chargée de votre compte pour obtenir de l’aide ou échanger avec un spécialiste de l’IA chez Snowflake.
- Méthodologie de comparaison des coûts : les tarifs des offres d’API serverless concurrentes reposent sur les prix publiés sur leurs pages web au 22 octobre 2026. Nous avons exécuté des charges de travail d’entraînement SFT avec LoRA sur Cortex Training, en utilisant la longueur de contexte indiquée dans la figure 5, puis mesuré le débit par GPU H200. Nous avons utilisé le débit (tokens/s) pour calculer le prix par million de tokens de Cortex Training selon la formule (price_per_second / throughput) x 1M. ↩


