13 nov. 2026/Lecture : 10 minData lake
Snowflake nommé Leader du tout premier Magic Quadrant™ Gartner® pour les plateformes de data lakehouse
Dans son premier rapport évaluant les plateformes de data lakehouse comme un marché à part entière, Gartner nomme Snowflake Leader du tout premier Magic Quadrant™ pour les plateformes de data lakehouse. Nous sommes particulièrement fiers de cette reconnaissance dans le domaine de la modernisation des data warehouses. Pour nos clients, se moderniser ne signifie plus se lancer dans une nouvelle migration.
Selon nous, cette étape marque une transformation de notre plateforme comme du marché qui l’entoure.
Le marché a dépassé l’opposition entre « warehouse ou lake »
Échangez avec n’importe quel chief data officer (CDO), et vous entendrez le même constat : les données sont réparties entre différentes plateformes, différents clouds et différentes régions, chaque système possédant son propre modèle de confiance. Pour avancer, les équipes copient les données. Or, chaque copie fragilise un peu plus leur gouvernance et leur sens. Chaque nouveau pipeline augmente les coûts et les risques.
Mais une crainte plus profonde demeure. Pendant des décennies, chaque nouvelle vague technologique a imposé aux clients de migrer vers un autre système propriétaire, souvent à des coûts impossibles à prévoir ou à maîtriser. Puis l’IA a encore relevé les enjeux. Les agents ont besoin de données fiables et d’un contexte cohérent, sur chacun des clouds utilisés par l’entreprise.
À elle seule, l’ouverture ne suffit pas à dissiper cette crainte. Aujourd’hui, presque tous les fournisseurs du marché prennent en charge Apache Iceberg™ et les standards ouverts, ce qui est une bonne nouvelle pour les clients. Les vraies questions sont plus complexes : une plateforme élimine-t-elle les raisons qui poussent les équipes à copier les données ? Leur permet-elle de gouverner de manière unifiée tout ce que produit l’environnement multimoteur actuel ?
« Gartner définit les plateformes data lakehouse comme des systèmes de gestion des données analytiques reposant sur une architecture cloud native unifiée. Elles permettent de gérer et d’analyser tous les types de données : structurées, semi-structurées et non structurées. Le lakehouse marque une rupture en réunissant les performances, la gouvernance et la forte simultanéité d’un data warehouse d’entreprise (EDW) avec l’évolutivité, la flexibilité et la compatibilité avec plusieurs moteurs d’un data lake. Il s’appuie pour cela sur des formats de table ouverts et prend en charge différents moteurs de traitement. Le lakehouse répond ainsi à un large éventail de workloads analytiques et d’IA. »
La transformation de Snowflake
À nos débuts, nous proposions un data warehouse conçu pour le cloud, qui séparait le stockage du calcul. Les équipes pouvaient ainsi faire évoluer indépendamment leurs analyses, sans gérer l’infrastructure. À mesure que les données de nos clients se sont réparties entre plusieurs plateformes et clouds, l’étape suivante s’est imposée : accéder aux données là où elles résident. Nous avons modernisé notre plateforme selon l’approche que nous recommandons à nos clients : connecter l’existant plutôt que repartir de zéro.
Selon nous, l’IA d’entreprise ne doit pas exploiter des données auxquelles vous ne pouvez pas faire confiance. Cette conviction a façonné l’AI Data Cloud de Snowflake autour de quatre principes : une frontière de confiance unique pour toutes vos données ; la connexion chaque fois que possible et le déplacement des données uniquement lorsque cela s’impose ; la maîtrise du calcul et des coûts ; le choix du modèle, du cloud et de l’interface.
Une frontière de confiance unique et un contexte gouverné pour toutes vos données
Les projets de modernisation promettent toujours aux organisations de repartir sur des bases saines, mais tiennent rarement cette promesse. Avec Snowflake, la modernisation repose au contraire sur un autre principe : la coexistence de plusieurs plateformes est une réalité en entreprise. Connecter les plateformes grâce à des standards ouverts et interopérables permet aux clients de conserver leurs environnements et la maîtrise de leurs données. Avec Snowflake, les clients définissent la confiance une seule fois, puis l’étendent à l’ensemble de leur patrimoine de données.
C’est, selon nous, ce qui a permis à Snowflake d’occuper la 1re place, avec une note de 4,29/5, pour ce cas d’usage dans le rapport complémentaire Critical Capabilities de Gartner. Les clients réunissent leurs warehouses, lakes et lakehouses sous une frontière de confiance unique, au lieu de déplacer leurs données vers un silo supplémentaire.
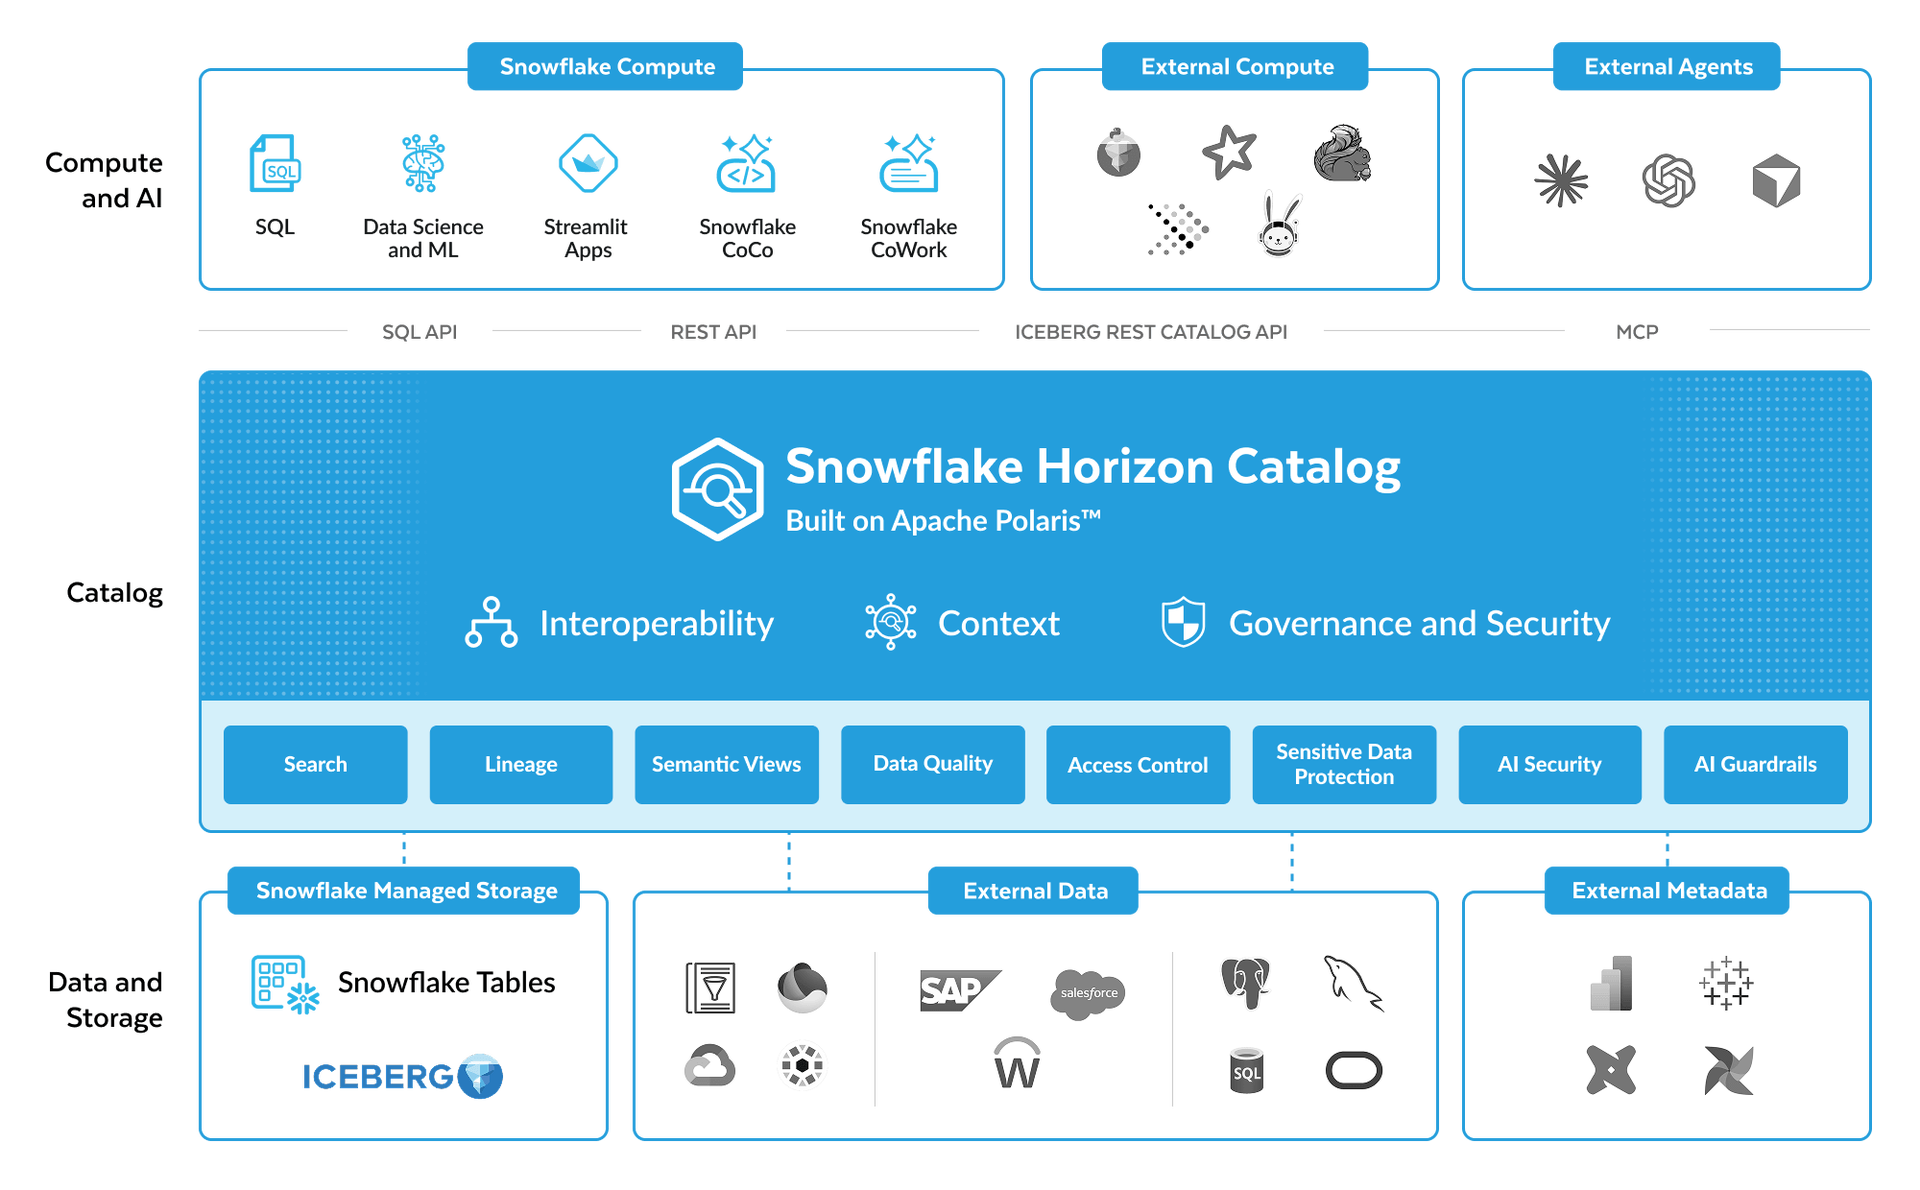
Cet environnement partagé, c’est Snowflake Horizon Catalog, qui repose sur Apache Polaris pour assurer l’interopérabilité avec Iceberg. Horizon Catalog réunit les fonctionnalités de gouvernance et le contexte métier afin d’établir une frontière de confiance unique pour toutes vos données. Snowflake permet d’appliquer des politiques de masquage et d’accès aux lignes aux requêtes portant sur les tables prises en charge. Cela inclut les données fédérées de catalogues externes, les données accessibles via des intégrations zero-copy et celles partagées entre des comptes et des partenaires. En parallèle, des contrôles basés sur les rôles régissent l’accès aux modèles et aux agents. Les équipes définissent des indicateurs et des relations métier dans des vues sémantiques réutilisables par les utilisateurs et les agents, puis étendent ce socle gouverné à mesure que leur patrimoine de données se développe.
Klarent, une entreprise technologique spécialisée dans l’assurance, a mis cette approche en pratique en définissant une seule fois dans Snowflake chaque client, contrat, voyage et sinistre. Les agents, les rapports et les applications utilisent ces définitions partagées. Les équipes marketing et de support peuvent ainsi suivre le parcours d’un client, du prospect au sinistre, et obtenir des réponses cohérentes. Consultez l’étude de cas complète ici.
Pour autant, unifier la sécurité et la gouvernance n’impose pas de tout déplacer. Ce qui nous amène au deuxième principe.
Connectez chaque fois que possible, déplacez les données uniquement lorsque cela s’impose
Pour la plupart des équipes data, le véritable problème n’est pas celui des données, mais celui des copies : chaque nouveau cas d’usage exige une nouvelle extraction et un nouveau pipeline à maintenir. En réalité, le moyen le plus rapide d’unifier les analyses consiste à laisser les données là où elles résident déjà.
Snowflake occupe également la 2e place, avec une note de 4,23/5, pour le cas d’usage Unified Analytics Data Platform dans le rapport Critical Capabilities. Les clients disposent d’une plateforme d’analyse unique pour toutes leurs données, car Snowflake s’y connecte là où elles résident.
Horizon Catalog fonctionne avec les tables Iceberg de différents catalogues externes, tandis que des intégrations zéro copie poussées permettent d’accéder à des systèmes de référence comme Workday, Salesforce, SAP et bien d’autres.
Lorsque les données doivent être déplacées, des outils de streaming et de traitement par lots conçus pour améliorer la productivité des équipes d’ingénierie les acheminent en réduisant considérablement le travail lié aux pipelines. Résultat : un environnement unique pour analyser toutes les données, avec moins de copies à stocker et moins de pipelines à gouverner.
Maîtrisez le calcul et les coûts
L’IA bouleverse l’équation économique des plateformes de données. Lorsque des agents interrogent les données 24 h/24, la maîtrise des coûts doit être intégrée à la plateforme dès sa conception. Nos clients nous l’ont clairement indiqué : la prévisibilité compte autant que les performances. Nous avons pris ce retour très au sérieux.
Le moyen le plus simple de maîtriser les coûts consiste à réduire les besoins en infrastructure. Snowflake rapproche le calcul des données pour presque tous les workloads, des applications transactionnelles sur Snowflake Postgres aux analyses et aux workloads à forte intensité de lecture sur les tables interactives. Le calcul s’adapte à chaque workload et optimise automatiquement les ressources, un atout d’autant plus essentiel que les workloads pilotés par des machines deviennent la norme.
À cela s’ajoutent des contrôles de coûts unifiés pour chaque workload et chaque opération d’IA exécutée dans Snowflake. Les alertes budgétaires au niveau de l’organisation, du compte et de l’objet établissent une nouvelle référence en matière de contrôle granulaire. Les quotas par utilisateur peuvent même bloquer les nouvelles requêtes sur les services d’IA pris en charge lorsque les limites sont atteintes, ce qui aide les équipes à contenir les dépenses d’IA imprévues. La détection des anomalies permet de signaler rapidement les pics inattendus.
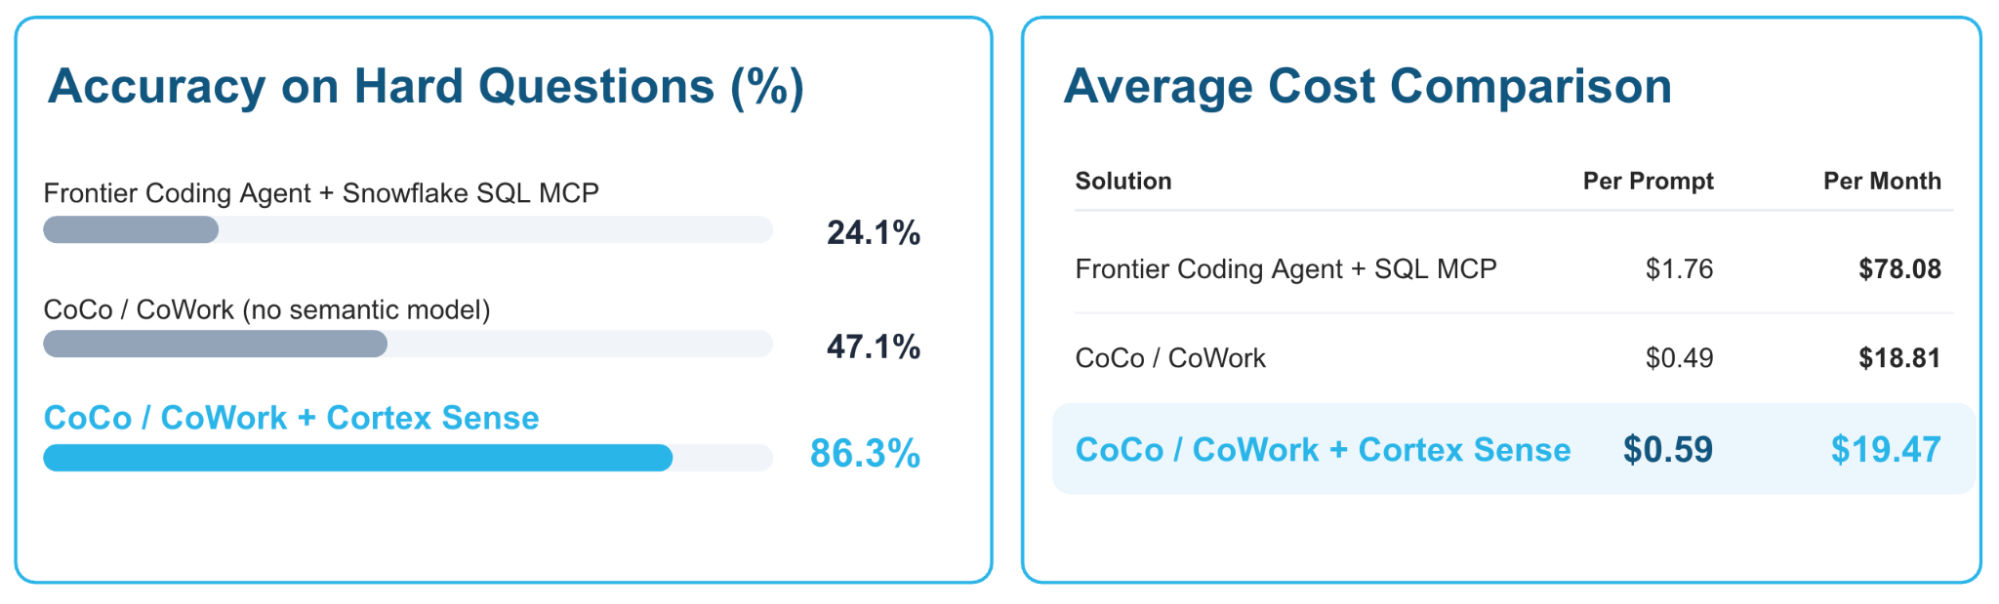
Pour les équipes de développement qui cherchent à améliorer l’efficacité de l’intelligence, Snowflake CoCo fournit un environnement de test natif pour les données, qui réduit les coûts tout en améliorant la précision.
Chez Indeed, plateforme mondiale de recrutement, l’adoption des tables interactives et des warehouses Snowflake a permis à l’équipe de regrouper les analyses destinées aux employeurs, en passant de 10 clusters de calcul à quatre. Le temps de réponse moyen des requêtes a diminué de 60 %, tandis que les coûts d’infrastructure ont encore reculé de 45 %. Les employeurs bénéficient ainsi de tableaux de bord plus rapides, avec moins d’infrastructure à maintenir. Consultez l’étude de cas complète ici.
Le choix du modèle, du cloud et de l’interface
Dès le prochain trimestre, le paysage de l’IA aura déjà changé. Une plateforme qui vous enferme dans un modèle ou un cloud vous oblige à tout reconstruire chaque fois que le marché évolue. Aujourd’hui, les données sont réparties entre plusieurs clouds et de nouveaux modèles apparaissent constamment. Snowflake permet d’associer facilement chaque tâche au modèle le plus adapté, avec des modèles de pointe disponibles au sein de la frontière de sécurité Snowflake. Les agents accèdent aux outils nécessaires pour effectuer des tâches concrètes grâce à des serveurs intégrés prenant en charge le protocole de contexte de modèle (Model Context Protocol, MCP). Les équipes peuvent également utiliser leurs propres serveurs.
La plateforme fonctionne dans plusieurs clouds et régions, avec un partage gouverné. Les équipes de développement travaillent dans Snowflake CoCo, tandis que les knowledge workers obtiennent leurs réponses dans Snowflake CoWork, le tout sur un même socle gouverné.
Ce que cela change pour les CDO
Ensemble, ces principes redéfinissent les attentes de la modernisation envers une organisation data. Vous modernisez en unifiant plutôt qu’en migrant, sous une frontière de confiance unique pour les données, les modèles et les agents. Vous vous connectez aux données là où elles résident et ne les déplacez que lorsque le travail l’exige. Le calcul s’adapte à chaque workload, avec des contrôles qui assurent la prévisibilité des coûts. Les équipes choisissent le modèle, le cloud et l’interface adaptés à chaque tâche. Toute la plateforme devient le plan de contrôle agentique, ce qui permet aux équipes data de mettre plus rapidement leurs données au service d’applications d’IA en production.
Et maintenant ?
Selon nous, c’est ce que le marché exige désormais : une plateforme unique, une frontière de confiance unique, ainsi qu’une architecture ouverte et interopérable à chaque niveau. Cette reconnaissance vient saluer notre transformation.
Merci à nos clients, dont les retours ont guidé chaque étape de notre transformation, à nos partenaires et à la communauté open source, ainsi qu’aux équipes Snowflake qui l’ont concrétisée.
Consultez le rapport Gartner Magic Quadrant pour les plateformes de data lakehouse dans son intégralité :
- Gartner, Magic Quadrant for Data Lakehouse Platforms, Aaron Rosenbaum, Michael Gonzales et al., 4 novembre 2026.
- Gartner, Critical Capabilities for Data Lakehouse Platforms, Michael Gonzales, Ramke Ramakrishnan et al., 5 novembre 2026.
Gartner et Magic Quadrant sont des marques commerciales de Gartner, Inc. et/ou de ses sociétés affiliées.
Gartner ne recommande aucune entreprise, aucun fournisseur, produit ou service présenté dans ses publications et ne conseille pas aux utilisateurs de technologies de choisir uniquement les fournisseurs ayant obtenu les meilleures notes ou toute autre distinction. Les publications de Gartner reflètent les opinions de son organisation spécialisée dans les analyses technologiques et métier et ne doivent pas être interprétées comme des déclarations factuelles. Gartner décline toute garantie, expresse ou implicite, concernant cette publication, y compris toute garantie de qualité marchande ou d’adéquation à un usage particulier.
- Selon des benchmarks internes, CoWork avec Cortex Sense fait passer la précision de 24,1 % à 86,3 % et réduit le coût par requête de 1,76 USD à 0,59 USD, soit une baisse de 66 %, par rapport à un agent de pointe sans ancrage dans les données. Pour en savoir plus, consultez : L’efficacité de l’intelligence en pratique : réduire le coût de chaque résultat fiable avec Snowflake CoCo et CoWork ↩