10 sept. 2026/Lecture : 11 minIA et ML
Réinventer la comptabilité fournisseurs avec l’IA native sur Snowflake
Malgré les nombreuses avancées des applications d’entreprise, les processus de comptabilité fournisseurs (AP) reposent encore largement sur des workflows manuels.
Les factures arrivent dans différents formats et différentes langues, dans des fichiers de qualité variable. Certaines font référence à des bons de commande qui ont évolué au fil du temps. D’autres ne contiennent pas les métadonnées clés requises par le progiciel de gestion intégré (ERP) avant toute comptabilisation. Les outils d’automatisation traditionnels savent généralement extraire les champs d’un document. Mais chaque cas particulier, comme les formats propres à chaque fournisseur, les factures sans bon de commande, les correspondances de lignes ambiguës, les données d’entreprise fragmentées ou les règles business variables selon l’organisation, vient alourdir les coûts opérationnels.
Pour combler cette lacune, nous avons créé InvoiceIQ, un outil que nous utilisons en interne chez Snowflake.
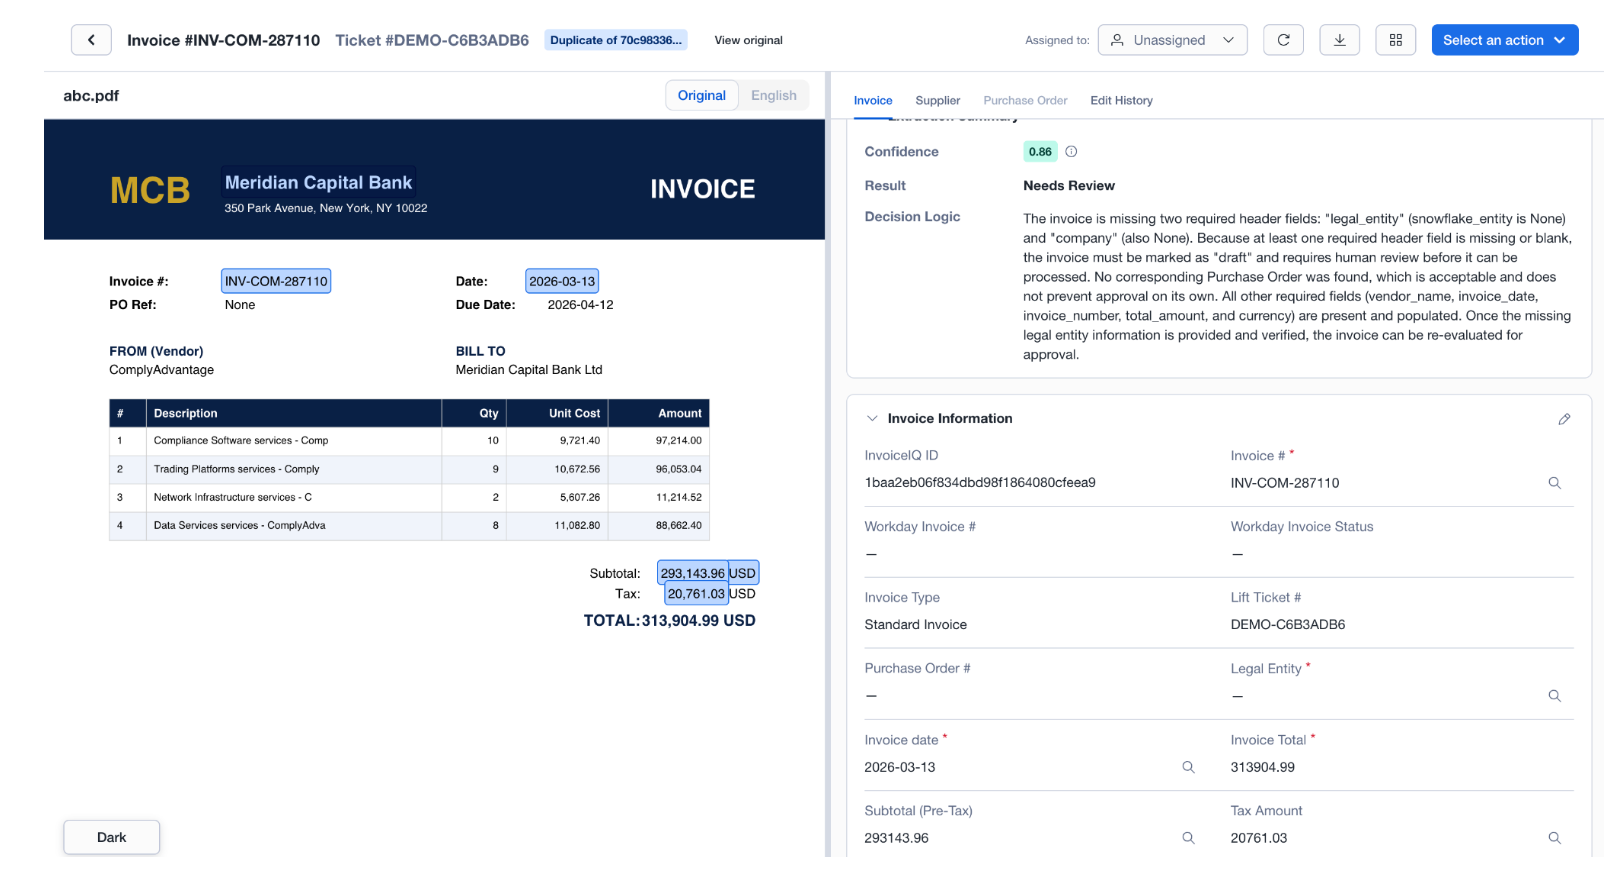
Figure 1 : détail d’une facture dans InvoiceIQ.
Plutôt que d’aborder le traitement des factures comme un simple problème d’analyse documentaire, nous l’avons repensé comme un enjeu de données gouvernées et de workflows, directement pris en charge dans Snowflake. Résultat : une application de comptabilité fournisseurs native de Snowflake qui réunit compréhension documentaire, enrichissement avec les données d’entreprise, règles business et soumission à l’ERP dans un seul système.
Dans cet article, nous verrons :
- pourquoi l’automatisation traditionnelle de la comptabilité fournisseurs laisse encore trop de valeur inexploitée
- pourquoi nous avons choisi une architecture native de Snowflake
- comment InvoiceIQ transforme des factures brutes en enregistrements prêts pour la comptabilité
- ce que nous avons appris en exécutant des workflows pilotés par l’IA en production
Le véritable goulot d’étranglement de l’automatisation AP
Les modèles multimodaux modernes savent déjà lire les factures. La difficulté technique n’est plus de déterminer si l’IA peut lire le texte d’une page. La vraie question, plus complexe, consiste à fiabiliser la compréhension du modèle au sein d’un véritable workflow financier.
Dans la pratique, les échecs de l’automatisation AP tiennent moins à l’incapacité d’un modèle à lire un document qu’à la fragmentation du workflow qui l’entoure. Les données sont réparties entre plusieurs systèmes. Les fonctionnalités d’IA des solutions SaaS sont souvent généralistes et difficiles à adapter aux workflows AP propres à chaque organisation. Les schémas d’intégration ne sont pas conçus pour des workflows adaptatifs. Et les exceptions les plus importantes sont souvent propres aux fournisseurs, aux politiques et aux exigences ERP de chaque organisation.
InvoiceIQ a précisément été conçu pour franchir cette dernière étape. En interne, nous avons abordé le problème comme la création d’un système capable de réduire les contrôles manuels, de renforcer la maîtrise des processus et d’établir un schéma réutilisable pour les applications d’IA directement fondées sur les données d’entreprise gouvernées.
Pourquoi nous avons conçu InvoiceIQ nativement sur Snowflake
Dès le départ, nous avons adopté un principe architectural simple : rapprocher le workflow des données, conserver une logique déterministe pour les composants qui s’y prêtent et intégrer l’IA comme une couche d’un système plus vaste, plutôt que de transformer l’ensemble du workflow en agent opaque.
Ce choix était essentiel, car les données dont nous avions besoin se trouvaient déjà dans Snowflake. Bons de commande, données de référence des fournisseurs, factures historiques, configuration, état des files d’attente et enregistrements de soumission en aval étaient déjà disponibles ou pouvaient y être modélisés. Plutôt que d’exporter ce contexte vers un assemblage hétéroclite de services externes, nous avons rapproché la logique de l’application des données.
InvoiceIQ s’exécute dans Snowflake à l’aide de Snowpark Container Services (SPCS), tandis que la coordination des workflows, la configuration et l’historique d’audit restent également dans Snowflake. Nous bénéficions ainsi d’un périmètre de sécurité unique, d’opérations simplifiées et d’un système plus facile à examiner en cas de problème.
Fonctionnement d’InvoiceIQ
Dans les grandes lignes, InvoiceIQ traite chaque facture en six étapes : classification, extraction, traduction, mise en correspondance, enrichissement et prise de décision. Chaque étape remplit une fonction précise. Ensemble, elles transforment un PDF brut en enregistrement prêt pour la comptabilité, qui peut être soumis à Workday ou transmis à un analyste avec une justification claire.
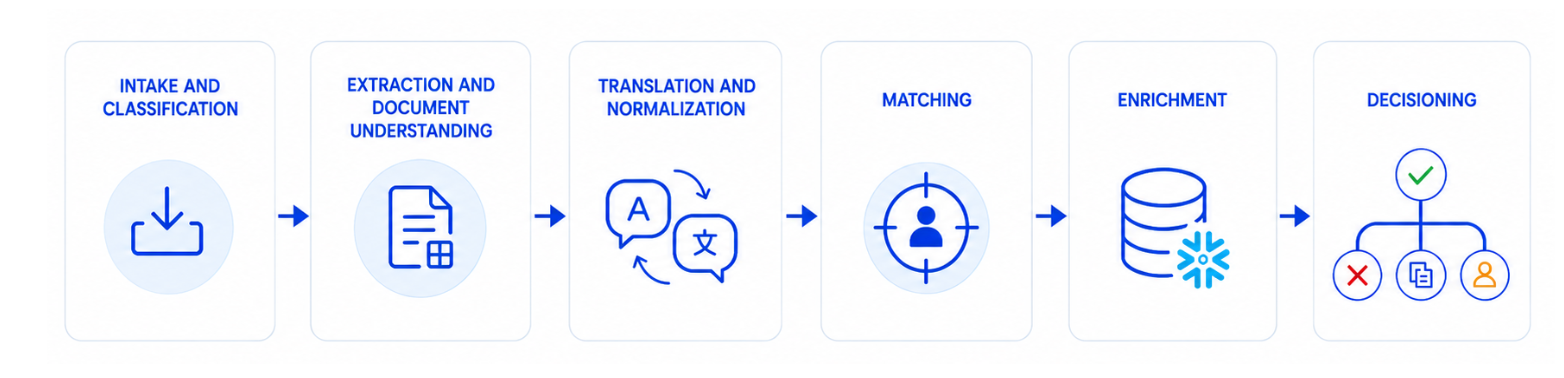
Figure 2 : vue d’ensemble du pipeline InvoiceIQ.
Classification
La première étape consiste à déterminer si le fichier chargé est réellement une facture.
Cela semble évident, mais dans la pratique, les équipes AP reçoivent aussi des reçus, des bons de commande, des relevés et des pièces justificatives. InvoiceIQ les écarte dès le départ à l’aide de AI_PARSE_DOCUMENT et de AI_CLASSIFY. Le reste du pipeline se concentre ainsi uniquement sur les documents utiles au workflow de facturation.
Extraction et compréhension de documents
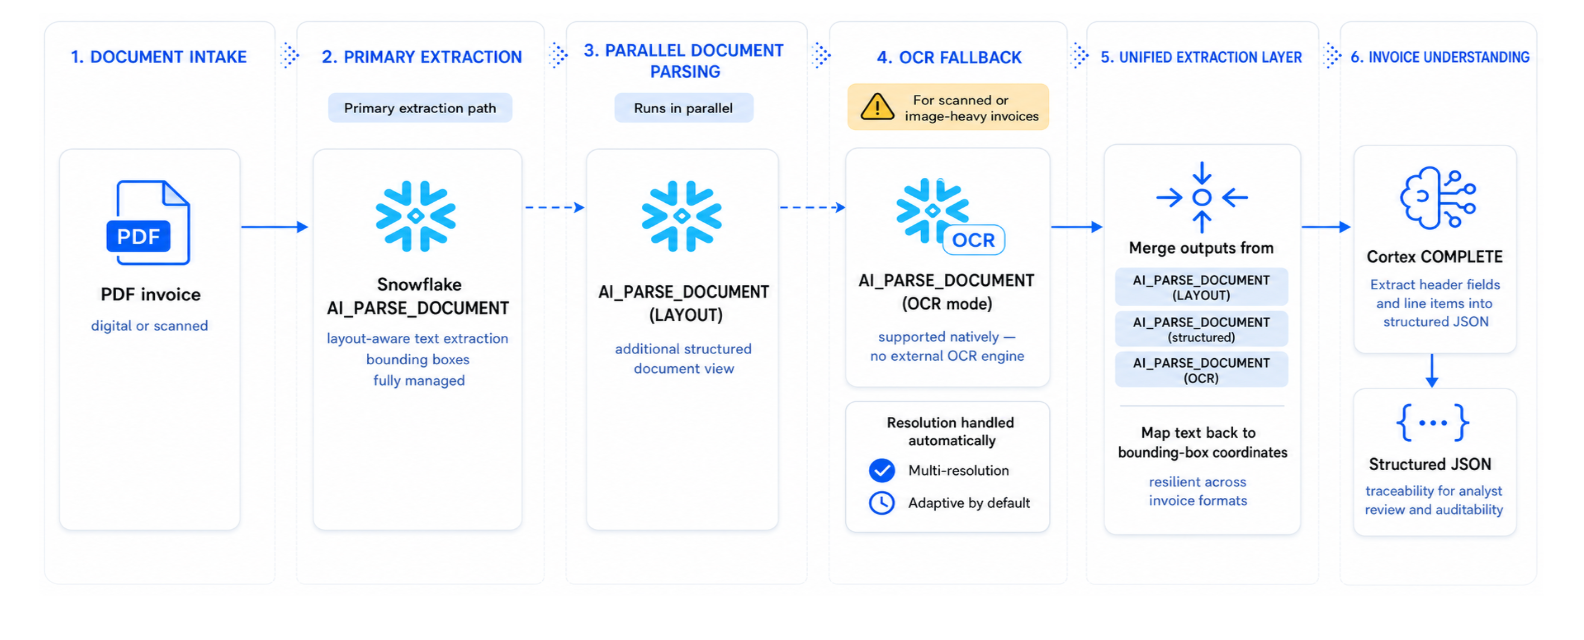
Figure 3 : pipeline d’extraction documentaire, de l’ingestion du PDF à la compréhension de la facture.
L’extraction repose délibérément sur un processus en plusieurs étapes.
InvoiceIQ utilise les services d’intelligence documentaire de Snowflake pour créer une vue structurée de chaque facture, récupérer le texte et les informations de mise en page, et garantir la traçabilité jusqu’au document source afin d’en faciliter l’examen par un analyste.
Une fois le texte assemblé, AI_COMPLETE le convertit en données de facture structurées, notamment les champs d’en-tête et les lignes de facturation. C’est à ce stade que le système passe du contenu brut du document à une représentation que les équipes peuvent réellement exploiter.
Traduction et normalisation
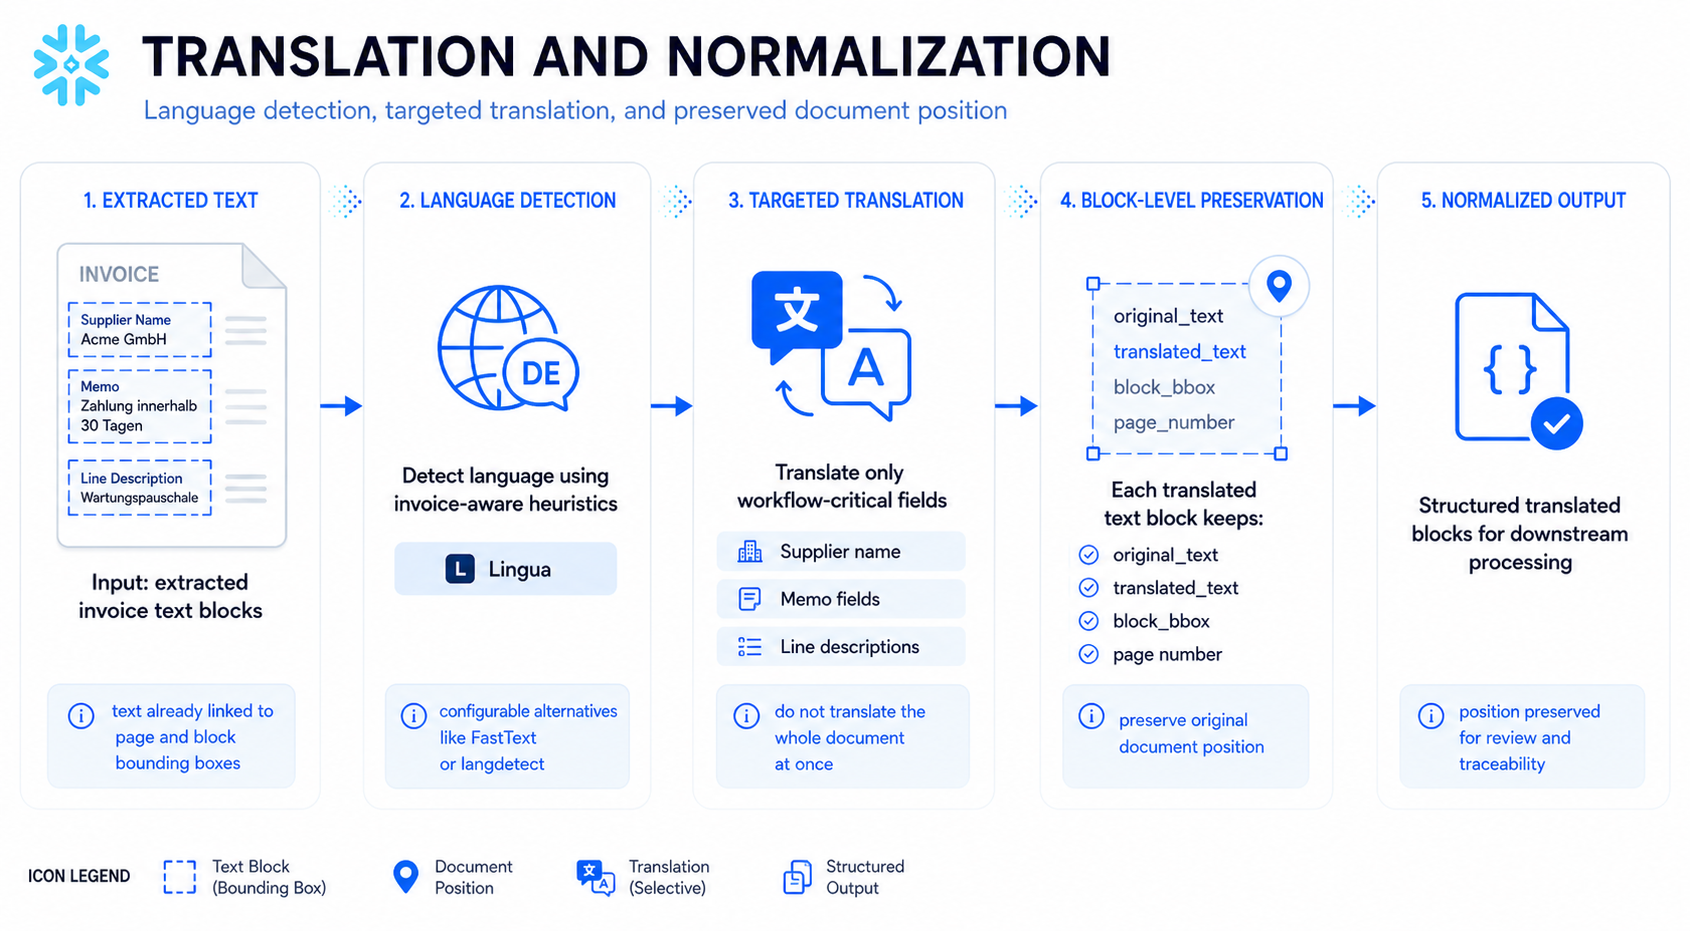
Figure 4 : workflow de détection de la langue et de traduction.
La traduction des factures n’est pas considérée comme un simple prétraitement générique.
Le pipeline commence par détecter la langue à l’aide de signaux propres aux factures, issus du document lui-même. Il traduit ensuite les sections ciblées avec CORTEX.TRANSLATE, tout en préservant leur emplacement dans le document d’origine et en conservant le texte original et sa traduction pour examen.
Cette approche est essentielle, car les factures contiennent souvent peu de texte, beaucoup de chiffres et une structure irrégulière. Traduire précisément les champs qui influent sur la qualité du workflow est plus utile que de traduire l’intégralité du document de façon générique, au risque de perdre le contexte.
Mise en correspondance
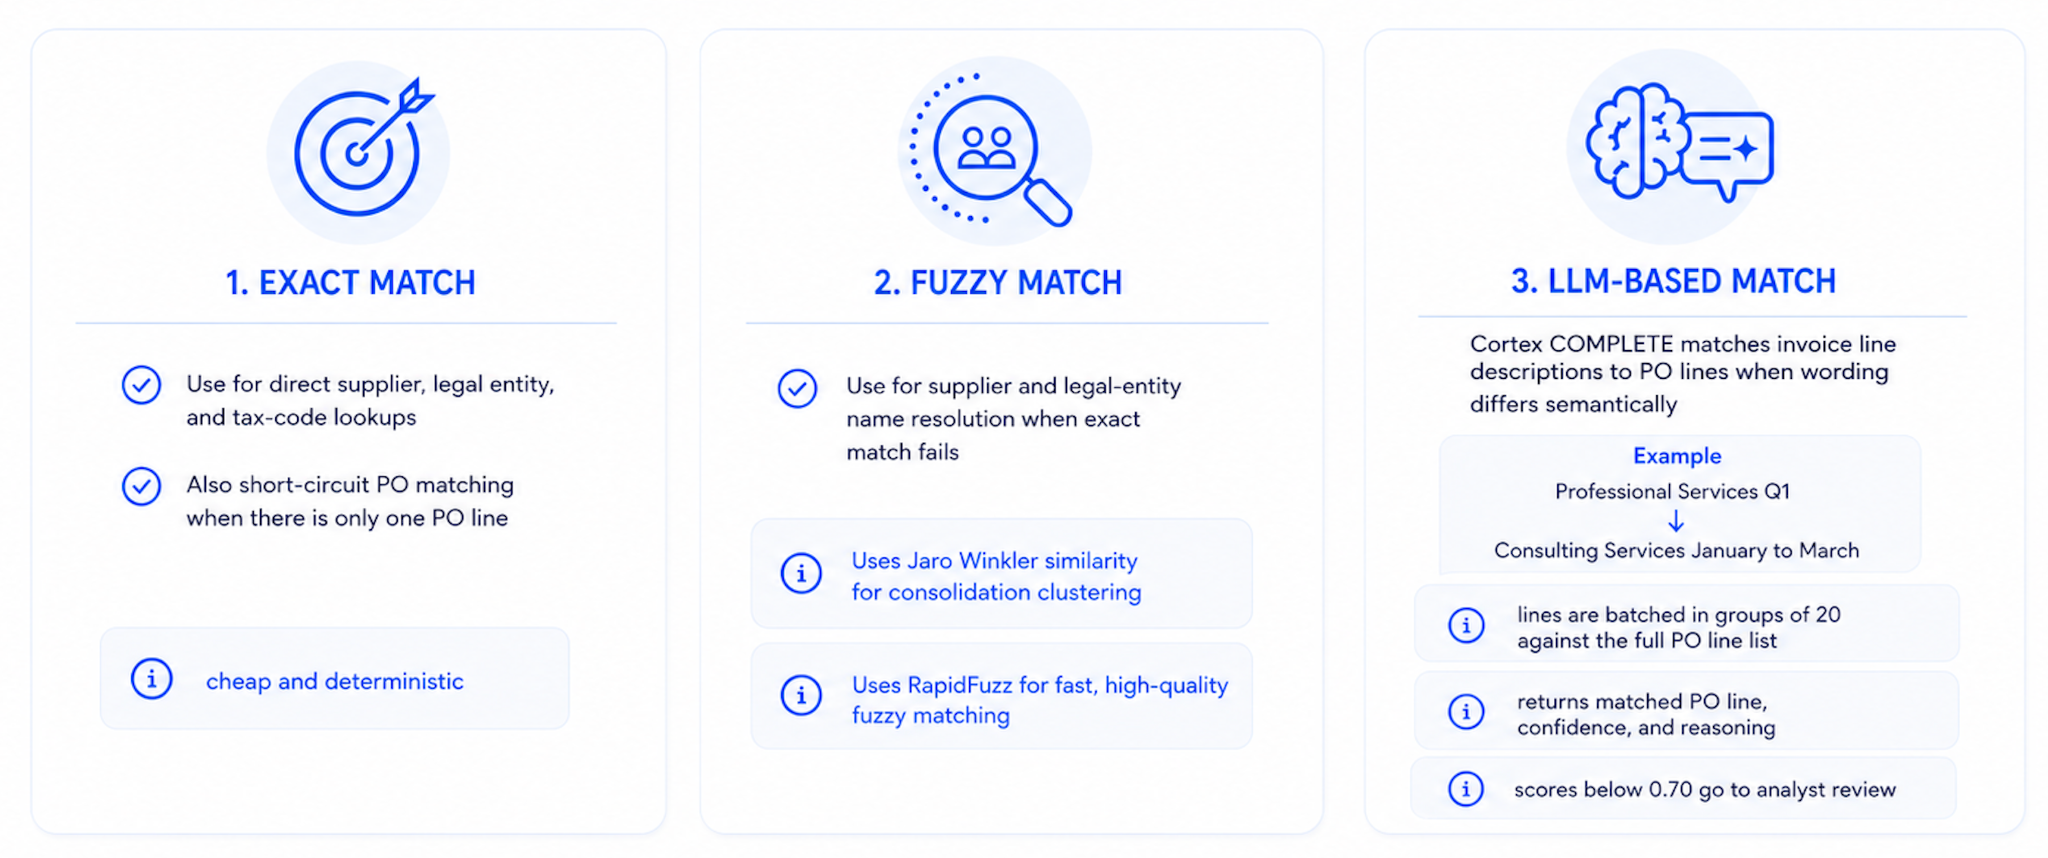
Figure 5 : méthodes de mise en correspondance des factures.
Pour les factures adossées à un bon de commande, la mise en correspondance donne à l’IA toute sa portée opérationnelle.
InvoiceIQ utilise trois méthodes de mise en correspondance, chacune adaptée à une tâche précise. La correspondance exacte offre un raccourci peu coûteux lorsque les chaînes de caractères concordent déjà. JAROWINKLER_SIMILARITY aide à rapprocher les noms de fournisseurs et d’entités juridiques, même lorsqu’ils sont incohérents. Enfin, AI_COMPLETE établit une correspondance sémantique entre les lignes de facture et celles du bon de commande lorsque la formulation diffère, mais que la signification business reste identique.
Le système peut ainsi relier une ligne de facture telle que « Snowflake Professional Services Q1 » à une ligne de bon de commande dont la description est plus formelle ou formulée autrement, sans obliger un analyste à rapprocher manuellement chaque écart.
Enrichissement
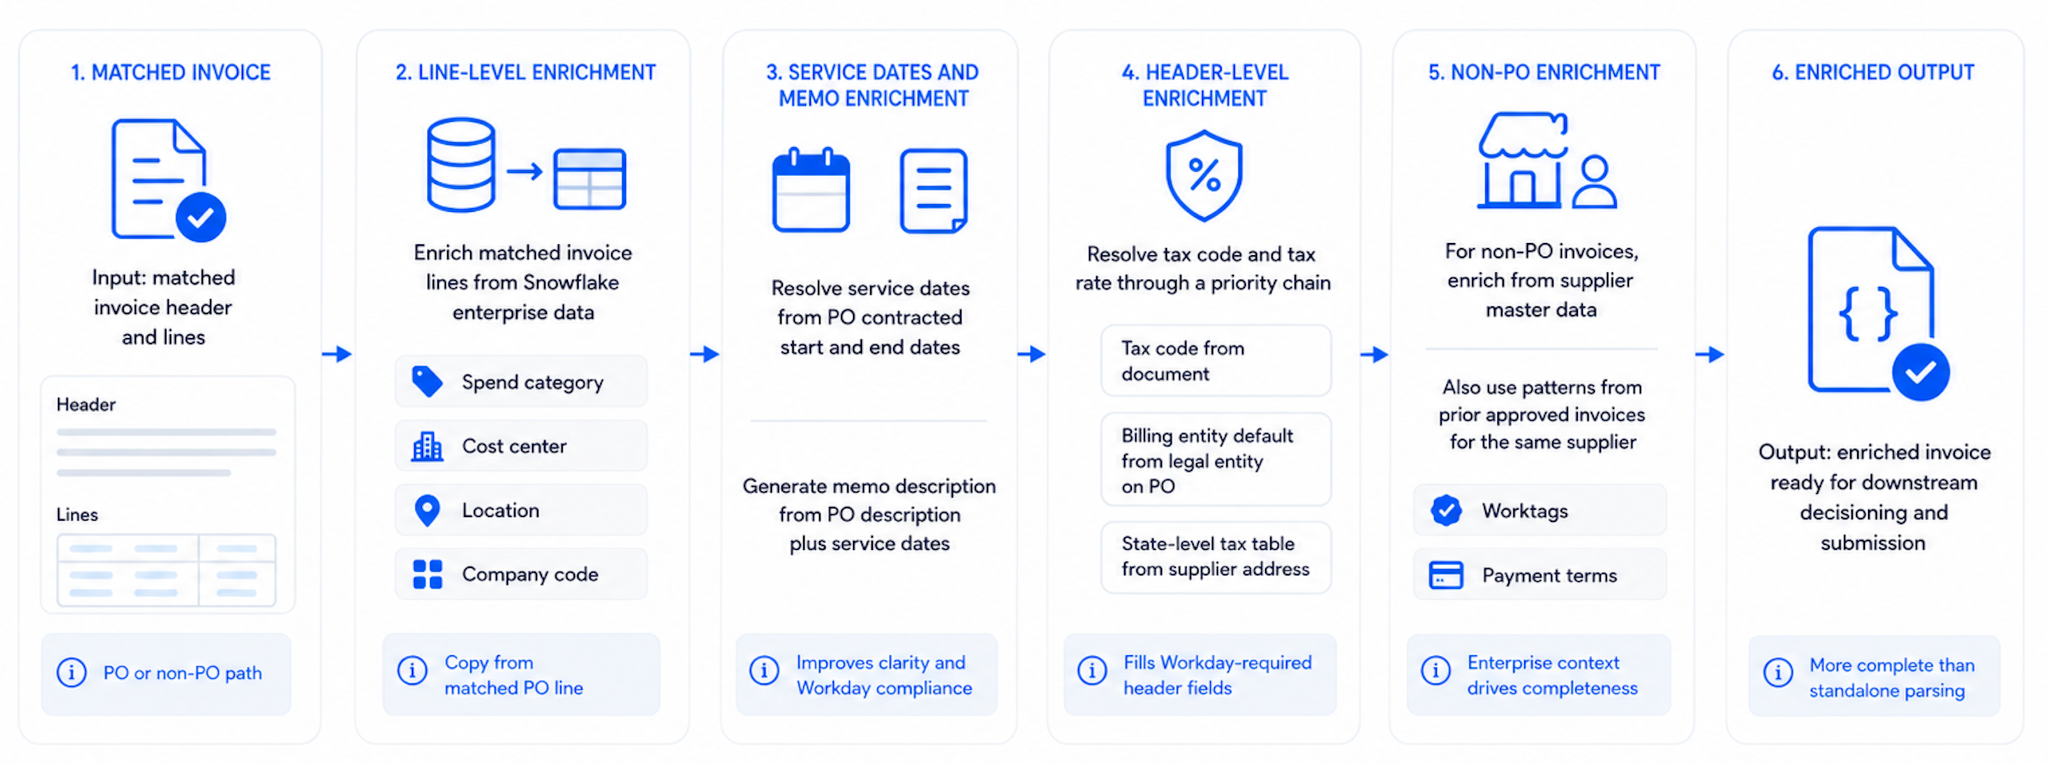
Figure 6 : enrichissement intelligent des factures.
L’extraction indique ce qui figure sur la facture. L’enrichissement détermine le contenu de l’enregistrement business final.
Une fois les lignes mises en correspondance, InvoiceIQ récupère le contexte d’entreprise dans les systèmes de référence hébergés dans Snowflake. Il peut s’agir de champs tels que la catégorie de dépenses, le centre de coûts, le site, le code société, les dates de prestation, les conditions de paiement et les valeurs fiscales.
Il s’agit de l’un des choix de conception les plus importants du système. Nous ne partons pas du principe que le PDF doit constituer la source de référence finale pour chaque champ. Les équipes peuvent choisir quelles données doivent provenir du document et lesquelles doivent être remplacées par celles des systèmes internes ou par la politique stratégique de l’organisation. Pour les factures adossées à un bon de commande, le système de référence des bons de commande peut prévaloir. Pour les factures sans bon de commande, le contexte fournisseur et les données historiques peuvent compléter les informations manquantes du document.
L’application s’adapte ainsi bien mieux aux opérations AP propres à chaque organisation qu’un analyseur autonome.
Prise de décision et soumission
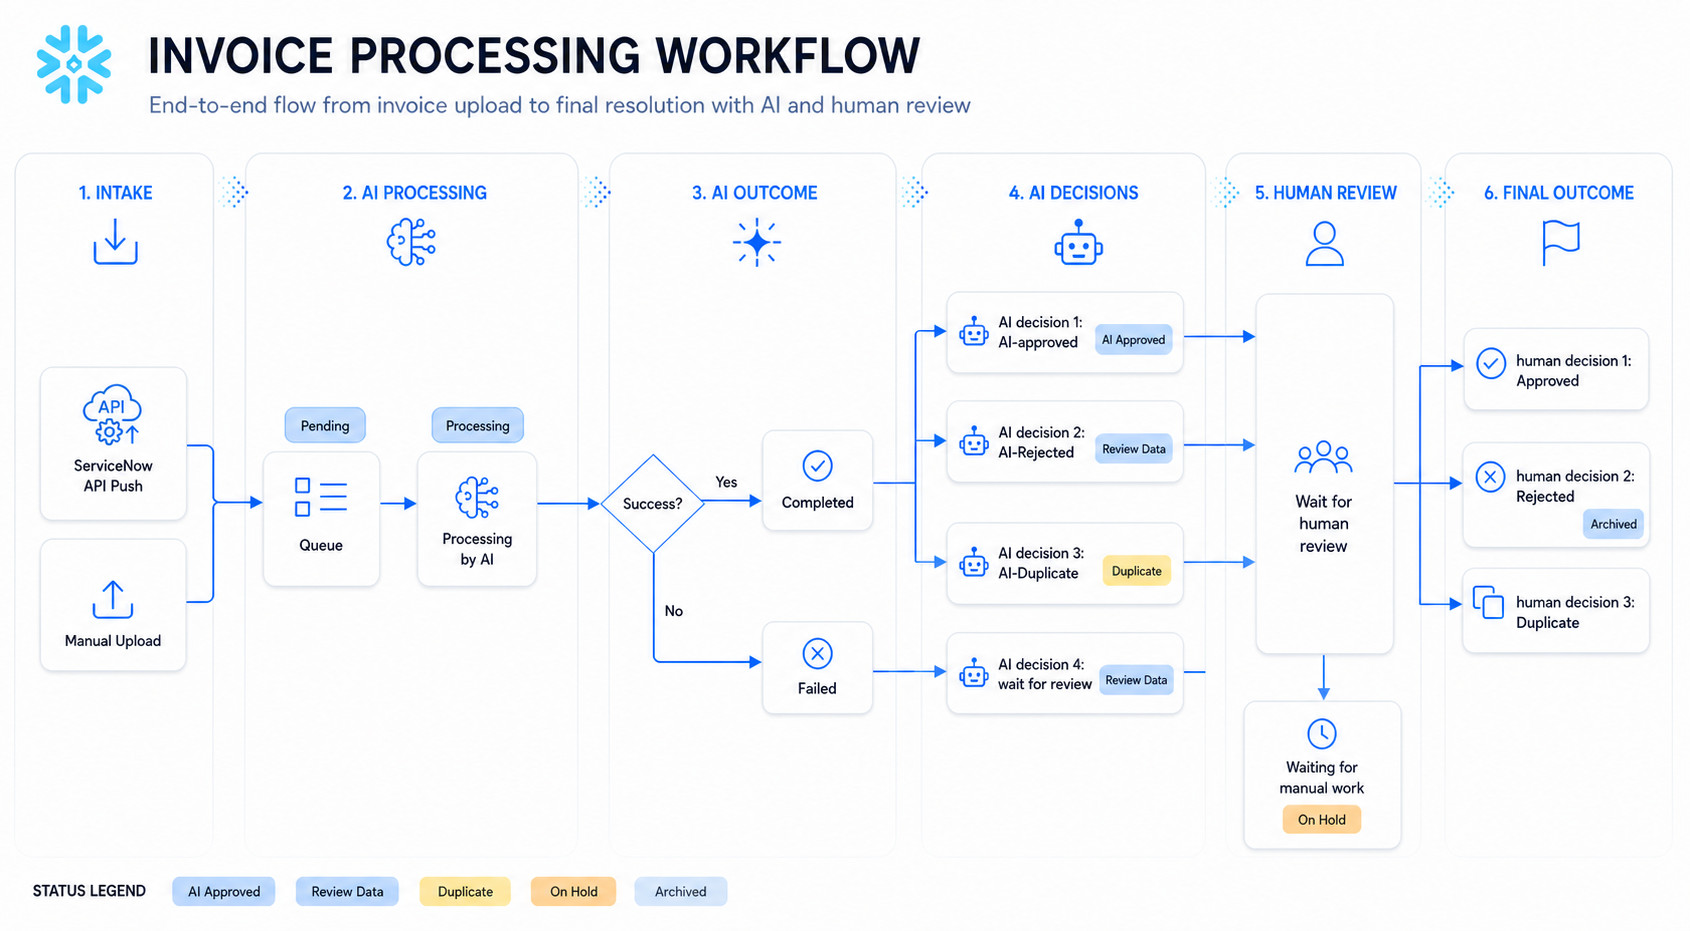
Figure 7 : cycle de vie d’une facture dans InvoiceIQ.
Après les étapes de mise en correspondance et d’enrichissement, le système détermine l’action suivante.
Les factures sont intégrées par e-mail ou chargées manuellement, puis traitées par l’IA. Elles reçoivent ensuite un premier statut : approuvée, rejetée, doublon ou contrôle requis. Les éléments nécessitant une intervention sont affectés aux analystes, tandis que les dossiers sans anomalie peuvent poursuivre leur parcours avec beaucoup moins d’intervention humaine que dans une file d’attente AP traditionnelle.
L’objectif n’est pas de rendre chaque facture entièrement autonome. Il s’agit de réserver le contrôle humain aux cas qui exigent réellement un jugement, en fournissant aux analystes un contexte structuré plutôt qu’un écran vide.
Exécuter des workflows d’IA en production
Déployer des fonctionnalités d’IA ne représente que la moitié du travail. L’autre moitié consiste à les exécuter de façon fiable, à les faire évoluer en toute sécurité, à garantir leur observabilité et à se passer d’une équipe ops dédiée. InvoiceIQ s’appuie sur la plateforme Snowflake pour répondre nativement à chacun de ces enjeux.
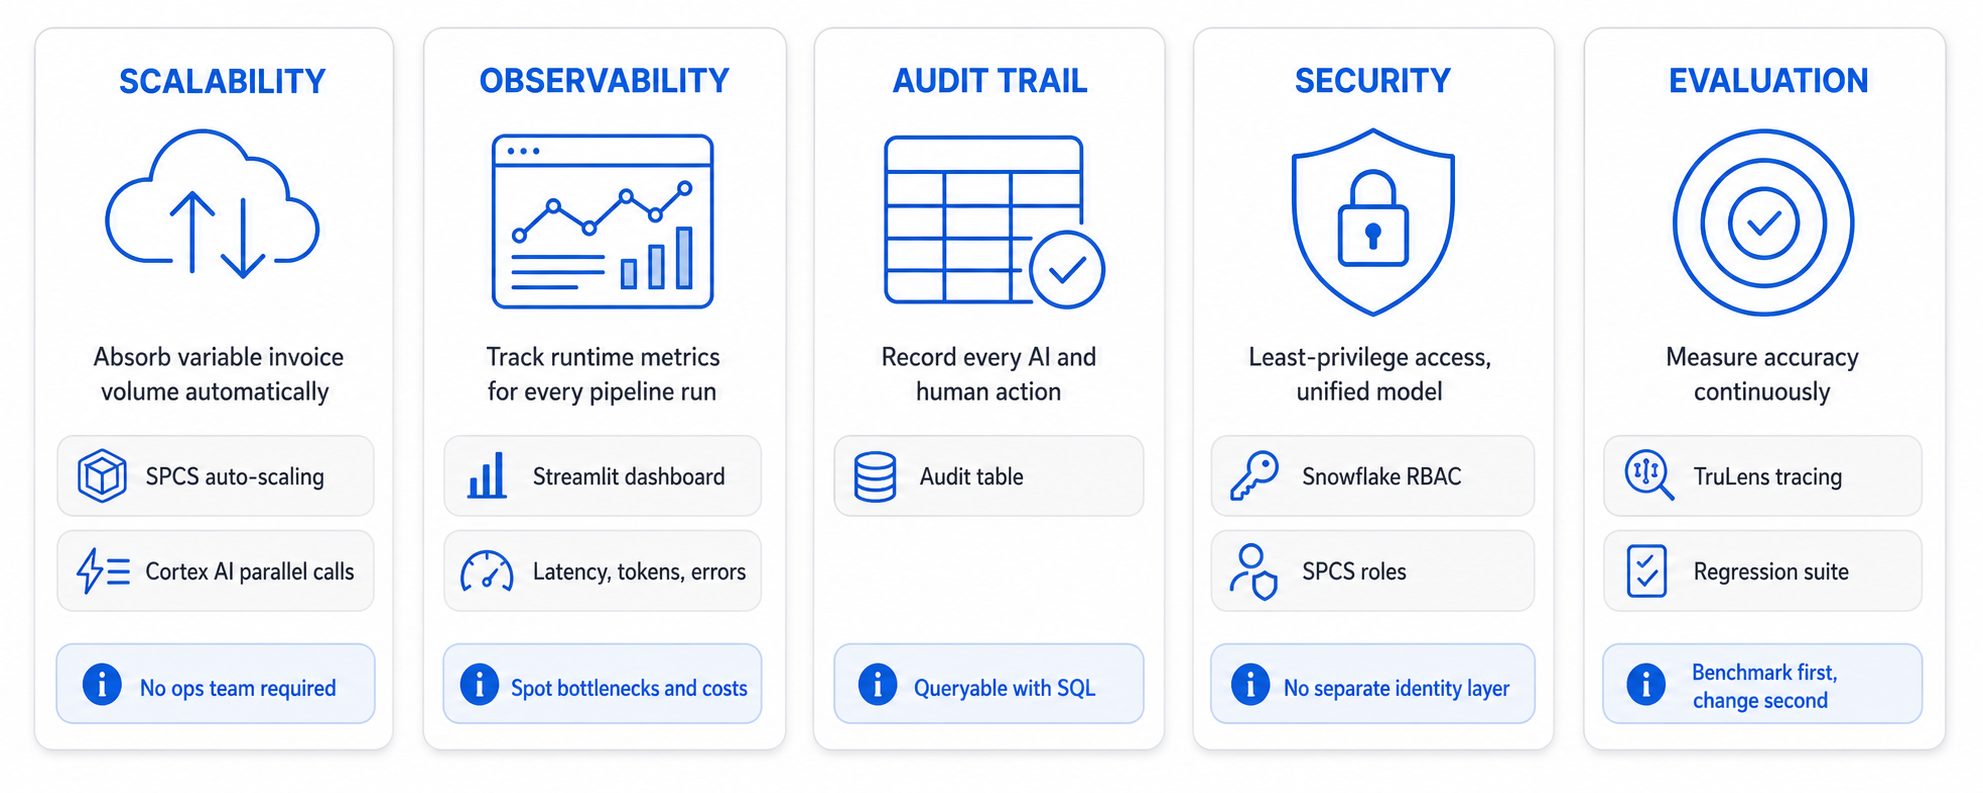
Figure 8 : les cinq piliers qui permettent à InvoiceIQ de s’exécuter en production sur Snowflake : évolutivité, observabilité, piste d’audit, sécurité et évaluation.
Évolutivité : autoscaling de SPCS et inférence d’IA en parallèle
InvoiceIQ peut absorber les fluctuations du volume de factures sans intervention manuelle, car SPCS adapte automatiquement les ressources de calcul à la demande, tandis que les fonctions Snowflake Cortex AI Functions s’exécutent simultanément dans la couche de calcul de Snowflake. Plusieurs étapes d’inférence peuvent ainsi s’exécuter en parallèle dans un même pipeline, sans flux réseau supplémentaires, sans gestion personnalisée des limites de débit ni équipe d’exploitation dédiée.
Observabilité : chaque token compte
Dans InvoiceIQ, l’observabilité porte sur le comportement à l’exécution : chaque exécution du pipeline enregistre des métriques opérationnelles dans Snowflake, notamment la latence de chaque étape, l’utilisation des tokens pour chaque appel à Cortex AI, ainsi que le nombre d’erreurs et de nouvelles tentatives. Ces données de télémétrie alimentent un tableau de bord Streamlit qui aide les ingénieurs à repérer les goulots d’étranglement, à comprendre les coûts par facture et à suivre la performance des modèles dans le temps.
Piste d’audit : L’audit au premier plan
La piste d’audit répond à un autre objectif : elle consigne ce qui s’est passé, et non l’efficacité avec laquelle le système a fonctionné. Chaque action humaine ou pilotée par l’intelligence artificielle génère un événement dans une table d’audit Snowflake. L’historique complet peut ainsi être interrogé en SQL, simplement rapproché des données de compte associées et directement exploité à des fins de conformité ou de reporting opérationnel.
Sécurité et contrôle des accès : RBAC Snowflake et SPCS
La sécurité repose sur le même modèle de contrôle d’accès basé sur les rôles Snowflake que celui utilisé dans le reste du compte. Chaque service SPCS s’exécute avec un rôle Snowflake dédié, limité aux seules autorisations nécessaires. Les analystes, les ingénieurs et les comptes de service utilisent eux aussi des rôles au périmètre défini. Résultat : un modèle unique de moindre privilège pour les utilisateurs comme pour les services, sans couches IAM distinctes, rotation manuelle des identifiants ni infrastructure externe de gestion des secrets.
Évaluation : TruLens et tests de régression
InvoiceIQ mesure la qualité en continu, plutôt que de considérer la précision comme une vérification ponctuelle. TruLens trace et évalue les appels aux LLM tout au long du pipeline selon des critères tels que la pertinence et l’ancrage contextuel. En parallèle, une suite de tests de régression compare chaque modification à des factures réelles dont les données de référence ont été validées par des humains. Cette approche centrée sur les benchmarks permet d’adopter plus sereinement de nouveaux prompts, modèles et capacités d’intelligence artificielle de Snowflake. Elle aide aussi l’équipe à détecter toute baisse de qualité avant la mise en production.
Conclusion
L’automatisation des factures offre encore une belle marge de progression. Mais les fondations sont désormais en place.
En repensant les processus AP autour des services natifs de Snowflake, de données d’entreprise gouvernées et de fonctions d’intelligence artificielle ciblées, nous avons dépassé la simple extraction de factures pour créer un système capable de fonctionner dans des conditions business réelles. Le résultat n’est pas une boîte noire entièrement autonome. C’est bien plus utile : un workflow contrôlable, observable et extensible, qui mobilise l’intelligence artificielle là où elle apporte le plus de valeur et ancre le reste du système dans les données de référence de l’entreprise.
L’impact sur le business
InvoiceIQ a été conçu pour renforcer à la fois l’efficacité et la maîtrise.
Lors du déploiement interne, l’équipe a réussi à confier à InvoiceIQ le traitement de la majorité des factures fournisseurs. Elle a ainsi mis en place un workflow AP agentique fondé sur nos propres données, avec des analyses et des enseignements pilotés par l’intelligence artificielle disponibles dès la mise en production grâce à Snowflake CoCo. Tout aussi important, le système a posé des fondations techniques plus solides pour la future automatisation des processus AP, où les règles business, la logique d’enrichissement, le comportement des modèles et l’auditabilité peuvent évoluer de concert.
Les factures sans anomalie peuvent passer de la boîte de réception à l’ERP en quelques minutes. Les exceptions arrivent avec leur contexte déjà renseigné. Les équipes disposent en outre d’une trajectoire claire pour améliorer la précision au fil du temps, sans reconstruire l’application à chaque nouveau cycle de modèles.